
مارکیٹنگ کو ہمیشہ بہت سارے ڈیٹا کی ضرورت ہوتی ہے۔ ڈیجیٹل مارکیٹنگ سے پہلے، کاروباروں کو سیلز، کسٹمرز کی خریداری، کوپن ریڈیمپشنز، اسٹور وزٹ، اور سروے کے جوابات کا پتہ لگانا پڑتا تھا تاکہ یہ سمجھ سکیں کہ ان کے گاہک کیا چاہتے ہیں۔
ڈیجیٹل مارکیٹنگ نے مارکیٹنگ کے تجزیات کو ایجاد نہیں کیا، لیکن اس نے دستیاب معلومات کی مقدار میں ڈرامائی طور پر اضافہ کیا ہے۔
آج، تقریباً ہر تعامل ڈیٹا تیار کر سکتا ہے۔ کوئی شخص اشتہار دیکھ سکتا ہے، اس پر کلک کر سکتا ہے، ویب سائٹ ملاحظہ کر سکتا ہے، ایک مضمون پڑھ سکتا ہے، ای میل کی فہرست کو سبسکرائب کر سکتا ہے، متعدد ای میلز کھول سکتا ہے، اپنی شاپنگ کارٹ میں مصنوعات شامل کر سکتا ہے، ویب سائٹ چھوڑ سکتا ہے، سرچ انجن کے ذریعے واپس آ سکتا ہے، اور آخر کار خریداری کر سکتا ہے۔ اور یہ تمام تعاملات ممکنہ طور پر ڈیٹا پوائنٹس بن سکتے ہیں۔
مارکیٹرز کے لیے، یہ ناقابل یقین مواقع پیدا کرتا ہے۔ اس سے بھی مسائل پیدا ہوتے ہیں۔ زیادہ ڈیٹا خود بخود بہتر فیصلوں کا مطلب نہیں ہے۔
کمپنیوں کے پاس سینکڑوں ہزاروں صارفین کے ریکارڈ ہو سکتے ہیں، لیکن وہ پھر بھی نہیں جانتی ہیں کہ کون سے گاہک سب سے زیادہ قیمتی ہیں۔ اگرچہ مارکیٹنگ ٹیموں کے پاس درجنوں ڈیش بورڈز ہیں، پھر بھی وہ آسان سوالات کے جوابات دینے کے لیے جدوجہد کر سکتی ہیں جیسے کہ "مجھے کن مہموں میں زیادہ پیسہ لگانا چاہیے؟”
یہ وہ جگہ ہے جہاں پروگرامنگ مفید ہو جاتی ہے۔ Python مارکیٹرز کو ڈیٹا کے ساتھ پروگرام کے مطابق کام کرنے کا ایک طریقہ فراہم کرتا ہے۔ اسپریڈشیٹ کو دستی طور پر کھولنے، فارمولوں کو کاپی کرنے، قطاروں کو فلٹر کرنے، اور ہر ہفتے ایک ہی رپورٹ بنانے کے بجائے، آپ دوبارہ استعمال کے قابل عمل بنا سکتے ہیں جو یہ کام خود بخود انجام دیتا ہے۔
زیادہ اہم بات یہ ہے کہ، ازگر آپ کو صرف رپورٹنگ سے زیادہ کرنے دیتا ہے۔ آپ اسے گاہک کے رویے کی چھان بین کرنے، نمونوں کو دریافت کرنے، شماریاتی تجزیہ کرنے، پیش گوئی کرنے والے ماڈلز بنانے، ورک فلو کو خودکار بنانے، اور ایسے نظاموں کی تعمیر کے لیے استعمال کر سکتے ہیں جو خام مارکیٹنگ کے ڈیٹا کو مسلسل مفید معلومات میں تبدیل کرتے ہیں۔
اس کا مطلب یہ نہیں ہے کہ ہر مارکیٹر کو سافٹ ویئر انجینئر ہونا ضروری ہے۔ اس کا مطلب ہے کہ پروگرامنگ مارکیٹر کے ٹول باکس میں ایک اور ٹول ہو سکتا ہے، اور یہ ٹیوٹوریل بتاتا ہے کہ کیسے۔
شرطیں
اس کتاب کو استعمال کرنے کے لیے آپ کو تجربہ کار پروگرامر یا مارکیٹر ہونے کی ضرورت نہیں ہے، لیکن چند بنیادی باتیں مثالوں کی پیروی کرنا آسان بنا دیں گی۔
- Python کے ساتھ کمپیوٹر انسٹال: تازہ ترین Python 3 ورژن استعمال کریں۔ اگر آپ Python میں نئے ہیں تو VS Code یا PyCharm جیسا ایڈیٹر آپ کو مثالیں چلانے میں مدد کر سکتا ہے۔
- بنیادی کمپیوٹر اور فائل کی مہارت: فائلیں کھولنے، فولڈرز بنانے، اور CSV یا Excel اسپریڈشیٹ کے ساتھ کام کرنے میں ماہر ہونا ضروری ہے۔
- ازگر کی بنیادی باتیں سیکھنے کی خواہش: حصہ 1 متغیرات، تاروں، نمبرز، حالات، لوپس اور فنکشنز سے شروع ہوتا ہے، اس لیے ازگر کا سابقہ تجربہ مددگار ہے لیکن اس کی ضرورت نہیں ہے۔
- مارکیٹنگ کے تصورات کے بارے میں کچھ معلومات: مہمات، تبادلوں، آمدنی، کلکس، اشتھاراتی اخراجات وغیرہ جیسی اصطلاحات ہر جگہ دکھائی جاتی ہیں۔ جاتے جاتے آپ میٹرکس کے بارے میں جان سکتے ہیں۔ یہ کتاب متعارف کرائے گئے کلیدی اصطلاحات کی وضاحت کرتی ہے۔
- پیکیج کی تنصیب کی خصوصیات: بعد کے ابواب لائبریریوں کا استعمال کرتے ہیں جیسے پانڈا، NumPy، Matplotlib، scikit-learn، اور درخواستیں۔ مثال سے پتہ چلتا ہے کہ اسے کیسے انسٹال کرنا ہے۔
آپ نمونہ ڈیٹا کا استعمال کرتے ہوئے کتاب کے ساتھ ساتھ پیروی کر سکتے ہیں۔ آپ کو اپنی کمپنی کے ذاتی کسٹمر ڈیٹا یا ادا شدہ مارکیٹنگ APIs تک رسائی کی ضرورت نہیں ہے۔ اگر آپ حقیقی ڈیٹا استعمال کرتے ہیں، تو یقینی بنائیں کہ آپ کو اس ڈیٹا تک رسائی کی اجازت ہے اور اس بات کو یقینی بنائیں کہ کوئی ذاتی یا خفیہ معلومات سامنے نہ آئیں۔
یہ کتاب آپ کو کیا سکھائے گی۔
کتاب تین اہم خیالات پر مرکوز ہے:
- مارکیٹنگ کے تجزیات: یہ سمجھنے کے لیے ڈیٹا استعمال کریں کہ کیا ہوا اور کیوں۔
- مارکیٹنگ آٹومیشن: Python کا استعمال کرتے ہوئے دہرائے جانے والے مارکیٹنگ کے کاموں کو زیادہ مؤثر طریقے سے انجام دیں۔
- مارکیٹنگ انٹیلی جنس: ہم بہتر فیصلوں کی حمایت کے لیے ڈیٹا، تجزیات، آٹومیشن اور پیشین گوئی کی ٹیکنالوجیز کو یکجا کرتے ہیں۔
آپ Python کی بنیادی باتوں کے ساتھ شروع کریں گے اور آہستہ آہستہ مزید جدید ایپلی کیشنز پر جائیں گے۔
آخر میں، آپ ایک مارکیٹنگ انٹیلی جنس سسٹم بنائیں گے جو ان میں سے بہت سے تصورات کو ایک پروجیکٹ میں یکجا کرتا ہے۔
یہاں ہم کیا احاطہ کریں گے:
اس کتاب کا فلسفہ
Python سیکھنے اور Python سیکھنے میں ایک اہم فرق ہے۔ استعمال کریں ازگر۔
پائتھون سیکھنے کا مطلب ہے نحو، ڈیٹا کی اقسام، فنکشنز، لوپس، لائبریریوں اور پروگرامنگ کے دیگر تصورات کو سمجھنا۔ Python استعمال کرنے کا مطلب ہے کہ ان تصورات کو حقیقی دنیا کے مسائل پر لاگو کرنا۔
یہ کتاب دوسرے نقطہ نظر پر مرکوز ہے۔
آپ اب بھی Python کے بنیادی اصول سیکھیں گے، لیکن مثالیں مسلسل ان بنیادی باتوں کو مارکیٹنگ سے جوڑتی ہیں۔
صرف لکھنے کے بجائے:
x = 10
y = 20
print(x + y)
ہم مندرجہ ذیل کام کریں گے:
campaign_budget = 10000
campaign_spend = 7350

remaining_budget = campaign_budget - campaign_spend

print(remaining_budget)
پروگرامنگ کے تصورات ایک جیسے ہیں، لیکن سیاق و سباق مختلف ہے۔
سیاق و سباق وہی ہے جو ٹیکنالوجی کو کارآمد بناتا ہے۔
حصہ 1: مارکیٹرز کے لیے ازگر کی بنیادی باتیں
Python نہیں جانتا کہ مہم کیا ہے یا گاہک کیا ہے۔ اور آپ نہیں جانتے کہ آپ کا اشتہار کامیاب ہوگا یا نہیں۔ ازگر آپ کی فراہم کردہ ہدایات پر آسانی سے کارروائی کرتا ہے۔
اس کا مطلب ہے کہ آپ کا پہلا کام کمپیوٹر کے ساتھ بات چیت کرنے کا طریقہ سیکھنا ہے۔
خوش قسمتی سے، مارکیٹنگ ڈیٹا کے ساتھ کام شروع کرنے سے پہلے آپ کو ازگر کے بارے میں سب کچھ جاننے کی ضرورت نہیں ہے۔ لیکن آپ کو ایک عملی بنیاد کی ضرورت ہے۔
ایک پروگرامر کی طرح سوچیں۔
پروگرامنگ پہلے تو خوفناک لگ سکتی ہے کیونکہ کمپیوٹر بہت لفظی ہوتے ہیں۔
اگر آپ کسی سے کہتے ہیں، "یہ معلوم کریں کہ آپ نے اپنے مہم کے بجٹ سے کتنی رقم بچائی ہے،” تو وہ شاید جان لیں گے کہ آپ کا کیا مطلب ہے۔
کمپیوٹر کو واضح ہدایات کی ضرورت ہے۔ آپ کو یہ بتانے کی ضرورت ہے کہ کون سی قیمت استعمال کرنی ہے اور کیا کرنا ہے۔
مثال کے طور پر:
budget = 10000
spent = 7350

remaining = budget - spent

print(remaining)
آؤٹ پٹ ہے:
2650
کمپیوٹرز کو مارکیٹنگ کو سمجھنے کی ضرورت نہیں تھی۔ میں نے صرف ہدایات پر عمل کیا۔
یہ آپ اور ایک پروگرامنگ زبان کے درمیان بنیادی تعلق ہے۔
آپ ہدایات فراہم کرتے ہیں، اور Python ان ہدایات کا ان کاموں میں ترجمہ کرتا ہے جو کمپیوٹر انجام دے سکتا ہے۔
مسئلہ کو مراحل میں تقسیم کریں۔
پروگرامنگ کی سب سے اہم مہارتوں میں سے ایک یہ سیکھنا ہے کہ بڑے مسائل کو چھوٹے مراحل میں کیسے توڑا جائے۔
تصور کریں کہ ایک مارکیٹنگ مینیجر پوچھ رہا ہے، "کیا آپ مجھے بتا سکتے ہیں کہ کون سی مہمات کم کارکردگی کا مظاہرہ کر رہی ہیں؟”
یہ سادہ لگ سکتا ہے، لیکن اس میں اصل میں چند چھوٹے سوالات شامل ہیں۔
"غریب” کا کیا مطلب ہے؟
کہ:
- کیا آپ کا منافع کم ہے؟
- کیا آپ کے تبادلوں کی شرح کم ہے؟
- کیا آپ کا CPA زیادہ ہے؟
- کیا ROAS کم ہے؟
- کیا مصروفیت کم ہے؟
- کم منافع؟
آپ کو یہ جاننے کی ضرورت ہے کہ آپ کو کس ڈیٹا کی ضرورت ہے، اسے کہاں ذخیرہ کیا گیا ہے، اسے کیسے صاف کیا جائے، متعلقہ میٹرکس کا حساب کیسے لگایا جائے، اور وہ معیارات جو اس بات کا تعین کرتے ہیں کہ آیا کسی مہم کو کمزور سمجھا جاتا ہے۔
مسائل کو الگ کرنا پروگرامنگ کو بہت آسان بنا دیتا ہے۔
مثال کے طور پر:
Load campaign data.
Clean the data.
Calculate ROAS.
Calculate conversion rate.
Filter campaigns below the chosen thresholds.
Display the results.
ازگر پھر ان اقدامات کو کوڈ میں تبدیل کر سکتا ہے۔
سوچ کے اس انداز کو سڑنا کہا جاتا ہے۔ آپ پوری کتاب میں اس اصطلاح کو مستقل طور پر استعمال کریں گے۔
باب 1: بنیادی باتیں سیکھیں اور ان پر عمل کریں۔
متغیر
متغیرات آپ کو نام کے ذریعہ معلومات ذخیرہ کرنے کی اجازت دیتے ہیں۔
campaign = "Back to School"
budget = 5000
clicks = 1250
conversions = 84
اب ازگر جانتا ہے:
campaignمتن پر مشتمل ہے۔budgetنمبرز پر مشتمل ہے۔clicksنمبرز پر مشتمل ہے۔conversionsنمبرز پر مشتمل ہے۔
آپ اس متغیر کو بعد میں استعمال کر سکتے ہیں۔
print(campaign)
print(budget)
print(clicks)
print(conversions)
آپ اس قدر کو بھی تبدیل کر سکتے ہیں۔
budget = 5000

budget = 7500

print(budget)
حتمی اقدار ہیں:
7500
متغیرات مفید ہیں کیونکہ وہ مارکیٹنگ کے پروگراموں کو مسلسل بدلتی ہوئی اقدار کے مطابق ڈھالنے کی اجازت دیتے ہیں۔
آج کا منافع کل کے منافع سے مختلف ہے۔ اس مہینے کا اشتہاری بجٹ پچھلے مہینے کے اشتہاری بجٹ سے مختلف ہے۔ جب کوئی گاہک خریداری کرتا ہے تو آرڈر کی مقدار بدل جاتی ہے۔ اور آپ کی مہمات کی کارکردگی وقت کے ساتھ بدلتی رہتی ہے۔
متغیرات آپ کو اپنے پروگرام میں ان کی قدر کی نمائندگی کرنے کی اجازت دیتے ہیں۔
متغیرات کو واضح طور پر نام دیں۔
تکنیکی طور پر، آپ لکھ سکتے ہیں:
x = 5000
لیکن یہ کیا کرتا ہے؟ x اوسط؟ یہ جاننے کے لیے آپ کو کہیں اور دیکھنا پڑے گا۔
ایک بہتر طریقہ یہ ہوگا:
campaign_budget = 5000
نام فوراً اپنا مقصد بتاتا ہے۔
اسی طرح:
total_revenue = 25000
total_cost = 8000
total_conversions = 450
اپنے متغیرات کو واضح طور پر نام دینے سے آپ کے کوڈ کو سمجھنا آسان ہو جاتا ہے۔ جیسے جیسے پروگرام بڑھتا جاتا ہے یہ اہم ہو جاتا ہے۔
تار
ایک تار متن کی نمائندگی کرتا ہے۔
campaign_name = "Holiday Sale"
channel = "Email"
customer_name = "Ava"
مثال کے طور پر، آپ اس طرح کے تاروں کو جوڑ سکتے ہیں:
message = "Welcome, " + customer_name

print(message)
نتائج درج ذیل ہیں:
Welcome, Ava
تاہم، f-strings عام طور پر پڑھنا آسان ہوتا ہے۔
message = f"Welcome, {customer_name}"

print(message)
متعدد متغیرات پر مشتمل ہو سکتا ہے۔
customer_name = "Ava"
discount = 20

message = (
    f"Hi {customer_name}, "
    f"you have a {discount}% discount."
)

print(message)
یہ خاص طور پر مفید ہے جب ذاتی نوعیت کے مارکیٹنگ پیغامات تخلیق کرتے ہیں۔
نمبر
Python انٹیجرز اور فلوٹنگ پوائنٹ نمبرز کو سپورٹ کرتا ہے۔
ایک عدد عدد ایک عدد ہے:
customers = 1500
فلوٹ اعشاریہ نمبروں پر مشتمل ہے۔
conversion_rate = 4.75
آپ ریاضی کے عمل کو انجام دے سکتے ہیں۔
revenue = 15000
cost = 5000

profit = revenue - cost

print(profit)
آپ ضرب کر سکتے ہیں:
average_order_value = 75
orders = 120

revenue = average_order_value * orders

print(revenue)
اور اسے اس طرح تقسیم کریں:
revenue = 12000
orders = 150

average_order_value = revenue / orders

print(average_order_value)
یہ بنیادی کارروائیاں بہت ساری مارکیٹنگ میٹرکس کی بنیاد بنتی ہیں۔
فیصد
مارکیٹنگ کے تجزیات ہر جگہ فیصد کا استعمال کرتے ہیں۔
مان لیں کہ 10,000 نقوش میں سے 500 لوگ آپ کے اشتہار پر کلک کرتے ہیں۔
کلک کے ذریعے شرح یہ ہے:
clicks = 500
impressions = 10000

ctr = clicks / impressions * 100

print(ctr)
نتائج درج ذیل ہیں:
5.0
آپ اسے اس طرح فارمیٹ کر سکتے ہیں:
print(f"CTR: {ctr:.2f}%")
کہ .2f ازگر کو دو اعشاریہ دو مقامات ظاہر کرنے کی ہدایت کرتا ہے۔
بولین قدر
بولین ویلیو دو ریاستوں کی نمائندگی کرتی ہے:
True
False
مثال کے طور پر:
campaign_active = True
آپ شرائط کے ساتھ بولین استعمال کرسکتے ہیں۔
campaign_active = True

if campaign_active:
    print("Campaign is currently running.")
بولین خاص طور پر مفید ہوتے ہیں جب آپ کے پروگرام کو فیصلے کرنے کی ضرورت ہوتی ہے۔
موازنہ آپریٹر
ایک میٹرکس جس کا ہم اکثر مارکیٹنگ میں موازنہ کرتے ہیں وہ ہے: اشتہاری اخراجات پر واپسی (ROAS). ROAS ان اشتہارات پر خرچ کی گئی رقم کی بنیاد پر اشتہارات سے حاصل ہونے والی آمدنی کی پیمائش کرتا ہے۔
ROAS = اشتہارات ¼ اشتہاری لاگت سے منسوب آمدنی
مثال کے طور پر، اگر کوئی مہم اشتہارات پر $1,000 خرچ کرتی ہے اور $4,000 سے منسوب آمدنی پیدا کرتی ہے، تو اس کا ROAS 4.0 ہے۔ یعنی، اسے اکثر 4:1 کے طور پر بیان کیا جاتا ہے۔ اس کا مطلب ہے کہ مہم نے اشتہارات پر خرچ کیے گئے ہر $1 کے بدلے $4 آمدنی حاصل کی۔
ROAS منافع کے مترادف نہیں ہے کیونکہ یہ پروڈکٹ کے اخراجات، ڈیلر کمیشن اور دیگر کاروباری اخراجات کو خود بخود کم نہیں کرتا ہے۔ صحیح مقصد آپ کی کمپنی کے مارجن اور اہداف پر منحصر ہوگا۔
Python کا استعمال کرتے ہوئے، آپ کوڈ کی ایک سادہ لائن کا استعمال کرتے ہوئے ROAS اقدار کا اس طرح موازنہ کر سکتے ہیں:
roas = 4.2

print(roas > 3)
نتائج درج ذیل ہیں:
True
دیگر موازنہوں میں شامل ہیں:
roas == 3
roas != 3
roas >= 3
roas <= 3
یہ موازنہ آپ کو قواعد بنانے کی اجازت دیتے ہیں۔
if roas >= 3:
    print("Campaign is performing well.")
شرائط کو یکجا کریں۔
مارکیٹنگ کے فیصلوں میں اکثر متعدد شرائط شامل ہوتی ہیں۔
ہم کہتے ہیں کہ اگر ROAS 3 سے زیادہ ہے اور تبادلوں کی شرح 4% سے زیادہ ہے تو مہم کو امید افزا سمجھا جاتا ہے۔
roas = 3.8
conversion_rate = 5.2

if roas >= 3 and conversion_rate >= 4:
    print("Campaign meets performance criteria.")
کہ and آپریٹر کو دونوں شرائط درست ہونے کی ضرورت ہے۔
آپ بھی استعمال کر سکتے ہیں or:
if roas >= 4 or conversion_rate >= 6:
    print("Campaign has at least one strong performance signal.")
مارکیٹنگ کے خودکار اصول بناتے وقت یہ سادہ لوجیکل آپریٹرز بہت کارآمد ہوتے ہیں۔
جھکاؤ
فہرستیں متعدد اقدار کو ذخیرہ کرتی ہیں۔
channels = [
    "Email",
    "Search",
    "Social Media",
    "Display"
]
آپ آئٹمز کو ان کے مقام کا استعمال کرتے ہوئے درج ذیل تک رسائی حاصل کر سکتے ہیں:
print(channels[0])
نتائج درج ذیل ہیں:
Email
ازگر صفر پر مبنی اشاریہ کاری کا استعمال کرتا ہے۔ اس کا مطلب ہے کہ پہلی چیز پوزیشن میں ہے۔ 0.
آپ آئٹمز شامل کر سکتے ہیں:
channels.append("Affiliate")
آپ دیکھ سکتے ہیں کہ فہرست میں کتنے آئٹمز ہیں۔
print(len(channels))
فہرستیں مارکیٹنگ کی معلومات کے مجموعوں کو ذخیرہ کرنے کے لیے مفید ہیں۔
ڈکشنری
لغتیں معلومات کو کلیدی قدر کے جوڑے کے طور پر محفوظ کرتی ہیں۔
campaign = {
    "name": "Holiday Sale",
    "channel": "Email",
    "budget": 5000,
    "conversions": 125
}
آپ اس طرح کی قیمت کو بازیافت کرسکتے ہیں:
print(campaign["channel"])
آپ اقدار کو بھی اپ ڈیٹ کر سکتے ہیں۔
campaign["budget"] = 7500
لغتیں خاص طور پر اس وقت مفید ہوتی ہیں جب کسی ایک گاہک، مہم، پروڈکٹ، یا مارکیٹنگ ایونٹ کی نمائندگی کرتے ہوں۔
مثال کے طور پر:
customer = {
    "name": "Ava",
    "age": 24,
    "orders": 7,
    "total_spent": 850
}
آپ رسائی حاصل کر سکتے ہیں:
print(customer["total_spent"])
لغت کی فہرست
جب آپ فہرستوں اور لغات کو یکجا کرتے ہیں تو چیزیں بہت زیادہ دلچسپ ہوجاتی ہیں۔
campaigns = [
    {
        "name": "Spring Sale",
        "channel": "Email",
        "revenue": 8500
    },
    {
        "name": "Summer Sale",
        "channel": "Social Media",
        "revenue": 6200
    },
    {
        "name": "Holiday Sale",
        "channel": "Search",
        "revenue": 12000
    }
]
اب آپ آسان طریقے سے متعدد مہمات کی نمائندگی کر سکتے ہیں۔
آپ اس طرح اعادہ کر سکتے ہیں:
for campaign in campaigns:
    print(campaign["name"])
یہ پیدا کرتا ہے:
Spring Sale
Summer Sale
Holiday Sale
یہ سٹرکچرڈ ڈیٹا اکٹھا کرنے کے کام کا آغاز ہے۔
لوپ
ایک لوپ ایک عمل کو دہراتا ہے۔
channels = [
    "Email",
    "Search",
    "Social Media",
    "Display"
]

for channel in channels:
    print(channel)
آپ حساب بھی کر سکتے ہیں۔
revenues = [5000, 7500, 9000, 6200]

for revenue in revenues:
    print(revenue * 0.1)
لوپ ہر قدر پر کارروائی کرتا ہے۔
تصور کریں کہ آپ کے 10,000 گاہک ہیں۔ آپ ایک ہی کام کو دستی طور پر 10,000 بار نہیں لکھنا چاہتے۔
لوپ ہر ریکارڈ پر کارروائی کے لیے ازگر کی ہدایات فراہم کرتا ہے۔ بعد میں کتاب میں، ہم دیکھیں گے کہ کیسے پانڈے اس قسم کے کاموں کو زیادہ طاقتور اور موثر بناتے ہیں۔
مشروط منطق اندرونی لوپ
آپ لوپس اور حالات کو یکجا کر سکتے ہیں۔
campaigns = [
    {"name": "Spring Sale", "roas": 2.5},
    {"name": "Summer Sale", "roas": 4.8},
    {"name": "Holiday Sale", "roas": 1.2}
]

for campaign in campaigns:
    if campaign["roas"] >= 3:
        print(
            f"{campaign['name']} is performing well."
        )
صرف شرائط پر پورا اترنے والی مہم چھاپی جائے گی۔
یہ تصوراتی طور پر مارکیٹنگ ڈیٹا سیٹ کو فلٹر کرنے کے مترادف ہے۔
فنکشن
فنکشن پیکجز دوبارہ قابل استعمال منطق ہیں۔
فرض کریں کہ آپ کو بار بار ROAS کا حساب لگانے کی ضرورت ہے۔ لکھنے کے بجائے:
roas = revenue / cost
ہر بار ایک فنکشن بنائیں۔
def calculate_roas(revenue, cost):
    return revenue / cost
پھر:
roas = calculate_roas(
    15000,
    5000
)

print(roas)
اسی فعالیت کو دوبارہ استعمال کیا جا سکتا ہے۔
campaign_one = calculate_roas(12000, 3000)
campaign_two = calculate_roas(8000, 4000)
campaign_three = calculate_roas(15000, 2500)
یہ بہت زیادہ صاف ہے۔
اپنے فنکشن میں توثیق شامل کریں۔
ایک اچھے فنکشن کو پریشانی والے آدانوں کا حساب دینا چاہئے۔
غور کریں:
def calculate_roas(revenue, cost):
    return revenue / cost
کیا ہوتا ہے اگر: cost کیا یہ 0 ہے؟
Python ایک غلطی پھینکتا ہے کیونکہ صفر سے تقسیم غیر متعینہ ہے۔
ایک محفوظ ورژن یہ ہوگا:
def calculate_roas(revenue, cost):
    if cost == 0:
        return None

    return revenue / cost
اب:
print(calculate_roas(10000, 0))
رپورٹ:
None
کریش ہونے کے بجائے۔
اپنے کوڈ کو غیر متوقع ان پٹ سے بچانے کا خیال اس وقت زیادہ اہم ہو جاتا ہے جب آپ حقیقی ڈیٹا سیٹ کے ساتھ کام کرنا شروع کرتے ہیں۔
متعدد اقدار واپس کریں۔
ایک فنکشن متعدد نتائج واپس کر سکتا ہے۔
def campaign_metrics(
    revenue,
    cost,
    clicks,
    conversions
):
    if cost == 0:
        roas = None
    else:
        roas = revenue / cost

    if clicks == 0:
        conversion_rate = None
    else:
        conversion_rate = (
            conversions / clicks * 100
        )

    return roas, conversion_rate
آپ اسے اس طرح استعمال کر سکتے ہیں:
roas, conversion_rate = campaign_metrics(
    12000,
    4000,
    1000,
    80
)

print(roas)
print(conversion_rate)
ہم بعد میں دوبارہ قابل استعمال تجزیہ ماڈیولز جیسی خصوصیات کو تبدیل یا انضمام کریں گے۔
باب 2: ازگر میں لائبریریاں
لائبریری درآمد کریں۔
اگرچہ Python کی بلٹ ان خصوصیات کارآمد ہیں، مارکیٹنگ کے تجزیات کے لیے اضافی ٹولز کی ضرورت ہوتی ہے۔
لائبریریاں پہلے سے تعمیر شدہ فعالیت فراہم کرتی ہیں۔
مثال کے طور پر:
import pandas as pd
کہ as pd جزوی پانڈا کو ایک چھوٹا عرفی نام دیتا ہے۔
اب آپ استعمال کر سکتے ہیں:
pd.read_csv()
بجائے:
pandas.read_csv()
آپ کو یہ اصول اپنے پورے ڈیٹا تجزیہ پروجیکٹ میں نظر آئیں گے۔
NumPy عام طور پر اس طرح درآمد کیا جاتا ہے:
import numpy as np
Matplotlib کا پلاٹنگ ماڈیول عام طور پر اس طرح درآمد کیا جاتا ہے:
import matplotlib.pyplot as plt
لائبریریاں انسٹال کریں۔
اگر لائبریری پہلے سے انسٹال نہیں ہے تو پائپ استعمال کریں۔
pip install pandas
متعدد لائبریریوں کے لیے:
pip install pandas numpy matplotlib scikit-learn requests openpyxl
آپ کے Python ماحول کے لحاظ سے درست تنصیب کا عمل مختلف ہو سکتا ہے۔
اگر آپ ورچوئل ماحول استعمال کر رہے ہیں، تو ہم تجویز کرتے ہیں کہ عالمی سطح کے بجائے اس ماحول کے اندر پراجیکٹ انحصار کو انسٹال کریں۔
مجازی ماحول
ہم کہتے ہیں کہ ایک پروجیکٹ کو لائبریری کے ایک ورژن کی ضرورت ہے، اور دوسرے پروجیکٹ کو مختلف ورژن کی ضرورت ہے۔ عالمی سطح پر ہر چیز کو انسٹال کرنا تنازعات کا سبب بن سکتا ہے۔
ایک ورچوئل ماحول آپ کے پروجیکٹ کے لیے الگ تھلگ ازگر کا ماحول فراہم کرتا ہے۔
آپ اسے اس طرح بنا سکتے ہیں:
python -m venv marketing-env
پھر اسے ونڈوز میں اس طرح فعال کریں:
marketing-envScriptsactivate
یا macOS یا Linux پر:
source marketing-env/bin/activate
پھر پیکیج انسٹال کریں:
pip install pandas numpy matplotlib scikit-learn
آپ انحصار کو بچا سکتے ہیں۔
pip freeze > requirements.txt
اس کے بعد دوسرے ڈویلپر اسے استعمال کرکے انسٹال کرسکتے ہیں:
pip install -r requirements.txt
یہ حتمی فیصلوں کو قابل اشتراک منصوبوں میں تبدیل کرنے کے لیے مفید ہے۔
حصہ 2: مارکیٹنگ ڈیٹا کے ساتھ کام کرنا
مارکیٹنگ کا ڈیٹا شاذ و نادر ہی آپ کے مطلوبہ فارمیٹ میں آتا ہے۔ یہ پہلی حقیقتوں میں سے ایک ہے جسے آپ کو قبول کرنا ہوگا۔
آپ کی اسپریڈشیٹ میں قدریں غائب ہو سکتی ہیں، آپ کی برآمد شدہ رپورٹس میں متضاد کیپٹلائزیشن ہو سکتی ہے، آپ کا CRM ایک کسٹمر ID فارمیٹ استعمال کر سکتا ہے جب کہ آپ کا اشتہاری پلیٹ فارم مختلف فارمیٹ استعمال کرتا ہے، تاریخیں مختلف فارمیٹس میں دکھائی جا سکتی ہیں، یا نمبرز کو تار کے طور پر محفوظ کیا جا سکتا ہے۔
ایک ڈیٹا سیٹ مکمل طور پر نارمل ظاہر ہو سکتا ہے جبکہ ٹھیک ٹھیک مسائل پر مشتمل ہو جو غلط تجزیہ پیدا کرتے ہیں۔
کسی بھی چیز کا حساب لگانے سے پہلے یہ سمجھ لیں کہ آپ کیا کر رہے ہیں۔
مارکیٹنگ ڈیٹا لائف سائیکل کو سمجھیں۔
مارکیٹنگ کے تجزیات کو لائف سائیکل کے طور پر سوچنے کا ایک مفید طریقہ ہے:
- پہلے ڈیٹا اکٹھا کیا جاتا ہے۔
- پھر محفوظ ہو جائے گا۔
- پھر اسے صاف کیا گیا۔
- پھر اسے تبدیل کر دیا گیا ہے۔
- اس کے بعد اس کا تجزیہ کیا جاتا ہے۔
- اس کے بعد نتائج فراہم کیے جاتے ہیں۔
- آخر میں، کوئی فیصلہ کرنے کے لیے ان نتائج کو استعمال کرتا ہے۔
ازگر تقریباً ہر قدم میں حصہ لے سکتا ہے۔
مثال کے طور پر، Python کسی API سے معلومات حاصل کر سکتا ہے، اسے ڈیٹا فریم میں محفوظ کر سکتا ہے، اسے پانڈوں کے ساتھ منظم کر سکتا ہے، KPIs کا حساب لگا سکتا ہے، تصورات بنا سکتا ہے، مشین لرننگ ماڈلز کو تربیت دے سکتا ہے، اور رپورٹس برآمد کر سکتا ہے۔
یہی وجہ ہے کہ Python زیادہ قیمتی ہو جاتا ہے کیونکہ مارکیٹنگ کے کام کے بہاؤ زیادہ پیچیدہ ہو جاتے ہیں۔
سٹرکچرڈ اور غیر ساختہ ڈیٹا
سٹرکچرڈ ڈیٹا وہ معلومات ہے جو پیشین گوئی کے قابل فیلڈز سے بنی ہوتی ہے۔
اسپریڈشیٹ پر مشتمل ہے:
customer_id
date
campaign
channel
revenue
یہ سٹرکچرڈ ڈیٹا ہے۔
ہر قطار ایک ریکارڈ کی نمائندگی کرتی ہے اور ہر کالم ایک متغیر کی نمائندگی کرتا ہے۔ یہ اس قسم کا ڈیٹا ہے جسے پانڈا خاص طور پر اچھی طرح سے ہینڈل کرتے ہیں۔
غیر ساختہ ڈیٹا مختلف ہے۔ مثالوں میں شامل ہیں:
- سوشل میڈیا پوسٹ
- کسٹمر کے جائزے
- ای میل متن
- سروے کا جواب
- تصویر
- ویڈیو
ازگر غیر ساختہ ڈیٹا کے ساتھ بھی کام کر سکتا ہے، لیکن اس کے لیے اکثر اضافی ٹیکنالوجیز کی ضرورت ہوتی ہے جیسے کہ قدرتی زبان کی پروسیسنگ یا کمپیوٹر ویژن۔
کتاب بنیادی طور پر سٹرکچرڈ مارکیٹنگ ڈیٹا پر مرکوز ہے، جو تجزیات، آٹومیشن، اور مشین لرننگ کے لیے ایک مضبوط بنیاد فراہم کرتی ہے۔
قطار اور کالم
فرض کریں کہ آپ کے ڈیٹا سیٹ پر مشتمل ہے:
customer_id | channel | clicks | conversions | revenue
101         | Email   | 500    | 40          | 3200
102         | Search  | 800    | 65          | 5100
103         | Social  | 300    | 18          | 1400
ہر قطار ایک مشاہدے کی نمائندگی کرتی ہے اور ہر کالم ایک وصف کی نمائندگی کرتا ہے۔
ان اختلافات کو سمجھنا ضروری ہے کیونکہ پانڈا کے بہت سے آپریشنز قطاروں، کالموں یا قطاروں کے گروپس پر کام کرتے ہیں۔
تجزیہ کی اکائی
ایک تصور جو خصوصی توجہ کا مستحق ہے وہ ہے تجزیہ کی اکائی۔
پوچھیں: ایک قطار کس چیز کی نمائندگی کرتی ہے؟ کیا یہ اشارہ کرتا ہے:
- کسٹمر؟
- خریداری؟
- مہم؟
- اشتہار؟
- ویب سائٹ سیشن؟
- ای میل؟
- ایک دن؟
یہ بہت ضروری ہے۔
تصور کریں کہ آپ کے پاس ایک ڈیٹاسیٹ ہے جہاں ہر قطار خریداری کی نمائندگی کرتی ہے۔ 10 بار خریداری کرنے والا گاہک 10 بار ظاہر ہوگا۔
اگر آپ قطاریں گنتے ہیں اور انہیں کسٹمرز کا نمبر کہتے ہیں تو آپ کا تجزیہ غلط ہوگا۔
اس کے بجائے، متعدد منفرد کسٹمر آئی ڈیز درکار ہیں۔
df["customer_id"].nunique()
میٹرک کا حساب لگانے سے پہلے ہمیشہ اپنے تجزیہ کی اکائی کو سمجھیں۔
مارکیٹنگ میٹرکس صورتحال کے لحاظ سے مختلف ہوتی ہیں۔
فرض کریں کہ مہم A کی تبدیلی کی شرح 10% ہے۔
یہ بہت اچھا لگتا ہے، لیکن کیا ہوگا اگر آپ کو صرف 10 زائرین اور 1 تبدیلیاں ملیں؟
اب ہم کہتے ہیں کہ مہم B کی تبادلوں کی شرح 4% ہے، لیکن 100,000 زائرین اور 4,000 تبدیلیاں پیدا کرتی ہے۔
اکیلے فیصد پوری کہانی نہیں بتاتے۔
یہی وجہ ہے کہ اچھی مارکیٹنگ کے تجزیات دوسرے عوامل کو بھی مدنظر رکھتے ہیں، جیسے:
- حجم
- تناسب
- خرچ
- آمدنی
- منافع
- کسٹمر کے معیار
- مدت
- کاروباری مقاصد
میٹرکس خود جواب نہیں ہیں۔ اس کا ثبوت ہے۔
باب 3: CSV ڈیٹا کے ساتھ کام کرنا
CSV کا مطلب ہے Comma-separated Values اور یہ ٹیبلر ڈیٹا کے تبادلے کے سب سے آسان اور عام طریقوں میں سے ایک ہے۔
فرض کریں campaigns.csv پر مشتمل ہے:
campaign,channel,impressions,clicks,conversions,cost,revenue
Spring Sale,Email,10000,850,120,500,6000
Summer Sale,Social Media,25000,1100,75,1200,4200
Holiday Sale,Search,18000,1400,180,2000,9500
لوڈ:
import pandas as pd

df = pd.read_csv("campaigns.csv")
پہلی پانچ قطاروں کی جانچ کی جاتی ہے۔
df.head()
اگر آپ چاہیں تو آپ مزید قطاریں دیکھ سکتے ہیں۔
df.head(10)
یا آخری 5:
df.tail()
ڈیٹا فریم کی شکلوں کو سمجھنا
استعمال کریں:
df.shape
آپ وصول کر سکتے ہیں:
(1000, 8)
اس کا مطلب ہے کہ ڈیٹا فریم میں 1,000 قطاریں اور 8 کالم ہیں۔
یہ آپ کے ڈیٹا سیٹ کے سائز کو سمجھنے کے تیز ترین طریقوں میں سے ایک ہے۔
کالم کے نام دیکھیں
df.columns
آپ دیکھ سکتے ہیں:
Index([
    'campaign',
    'channel',
    'impressions',
    'clicks',
    'conversions',
    'cost',
    'revenue'
], dtype="object")
دوبارہ قابل استعمال کوڈ لکھتے وقت، کالم کے صحیح ناموں کو جاننا ضروری ہے۔
کالم منتخب کریں۔
براہ کرم دس منتخب کریں۔
df["revenue"]
یا متعدد کالم منتخب کریں۔
df[
    [
        "campaign",
        "revenue",
        "cost"
    ]
]
یہ آپ کو اپنے ڈیٹا سیٹ کے چھوٹے نظارے بنانے کی اجازت دیتا ہے۔
قطار کا انتخاب
آپ حالات کا استعمال کرتے ہوئے قطاریں منتخب کر سکتے ہیں۔
df[df["revenue"] > 5000]
$5,000 سے زیادہ آمدنی والی مہمیں واپس کر دی جاتی ہیں۔
آپ حالات کو یکجا کر سکتے ہیں۔
df[
    (df["revenue"] > 5000) &
    (df["cost"] < 3000)
]
پانڈوں کی شرائط کو یکجا کرتے وقت قوسین اہم ہیں کیونکہ پانڈوں کو نتائج کو یکجا کرنے سے پہلے ہر ایک موازنہ کو مکمل شرط کے طور پر جانچنا چاہیے۔ آپریٹرز جیسے & اور | ترجیحی اصول ہیں جو Python کے عام ترجیحی اصولوں سے مختلف ہیں۔ and اور orلہذا، قوسین کو چھوڑنا غلطیاں یا غیر ارادی تاثرات کا سبب بن سکتا ہے۔
ہر شرط کو استعمال کرنے سے پہلے قوسین میں رکھیں۔ & AND اور کے لیے | ڈیٹا فریم کو فلٹر کرتے وقت OR کے لیے۔
مثال کے طور پر:
# Select campaigns with more than 1,000 clicks
# and a conversion rate above 2%
filtered_campaigns = df[
    (df["clicks"] > 1000) &
    (df["conversion_rate"] > 0.02)
]
قطار کو شامل کرنے کے لیے یہاں دونوں شرائط درست ہونے چاہئیں۔ filtered_campaignsڈیٹا کی ترتیب
آمدنی کے لحاظ سے ترتیب دیں:
df.sort_values(
    "revenue",
    ascending=False
)
یہ اس بات کو یقینی بناتا ہے کہ سب سے زیادہ کمانے والی مہموں کو پہلے رکھا جائے۔
قیمت کے لحاظ سے ترتیب دیں:
df.sort_values(
    "cost",
    ascending=True
)
آپ متعدد کالموں کے حساب سے ترتیب دے سکتے ہیں۔
df.sort_values(
    ["channel", "revenue"],
    ascending=[True, False]
)
پہلے چینل کے لحاظ سے نتائج کو گروپ کریں اور پھر ہر چینل کے اندر آمدنی کو ترتیب دیں۔
باب 4: ایکسل کے ساتھ کام کرنا
مارکیٹنگ کے بہت سے محکمے اب بھی ایکسل پر بہت زیادہ انحصار کرتے ہیں۔
خوش قسمتی سے، ایکسل فائلوں کے ساتھ کام کرنا پانڈوں کے ساتھ نسبتاً آسان ہے۔
df = pd.read_excel(
    "marketing_data.xlsx"
)
آپ ورک شیٹ کی وضاحت کر سکتے ہیں۔
df = pd.read_excel(
    "marketing_data.xlsx",
    sheet_name="Campaigns"
)
آپ دستیاب شیٹس کو استعمال کرتے ہوئے چیک کر سکتے ہیں:
excel_file = pd.ExcelFile(
    "marketing_data.xlsx"
)

print(excel_file.sheet_names)
بڑی ورک بک کے ساتھ کام کرتے وقت یہ مفید ہے۔
ایکسل میں ڈیٹا ایکسپورٹ کریں۔
آپ ڈیٹا فریم برآمد کر سکتے ہیں۔
df.to_excel(
    "marketing_report.xlsx",
    index=False
)
آپ متعدد ورک شیٹس بنا سکتے ہیں۔
with pd.ExcelWriter(
    "marketing_report.xlsx"
) as writer:

    df.to_excel(
        writer,
        sheet_name="Data",
        index=False
    )

    channel_summary.to_excel(
        writer,
        sheet_name="Channels"
    )
یہ فعالیت بالآخر اہم ہو جاتی ہے کیونکہ حتمی نظام ساختی مارکیٹنگ رپورٹس تیار کرتا ہے۔
باب 5: تاریخیں اور اوقات
مارکیٹنگ کی کارکردگی وقت کے ساتھ بہت مختلف ہوتی ہے۔
ایک مہم جس نے چھ مہینوں میں $20,000 کی آمدنی حاصل کی وہ اس مہم سے بہت مختلف ہے جس نے دو دنوں میں $20,000 کمائے۔
تاریخ کے کالم کو تبدیل کرکے شروع کریں۔
df["date"] = pd.to_datetime(
    df["date"]
)
اب آپ اجزاء نکال سکتے ہیں۔
df["year"] = df["date"].dt.year
df["month"] = df["date"].dt.month
df["day"] = df["date"].dt.day
آپ مہینے کا نام نکال سکتے ہیں۔
df["month_name"] = (
    df["date"]
    .dt.month_name()
)
ہفتے کے دن:
df["weekday"] = (
    df["date"]
    .dt.day_name()
)
وقت پر مبنی مارکیٹنگ کے سوالات
ایک بار جب آپ کی تاریخ درست طریقے سے فارمیٹ ہو جاتی ہے، تو آپ سوالات کے جواب دے سکتے ہیں جیسے:
- کون سا مہینہ سب سے زیادہ آمدنی لایا؟
- ہفتے کے کن دنوں میں تبادلوں کی شرح سب سے زیادہ ہوتی ہے؟
- کیا کچھ تبدیلیاں کرنے کے بعد آپ کی مہم نے بہتر کارکردگی کا مظاہرہ کیا؟
- کیا کوئی موسمی رویے ہیں؟
- کیا آپ کے گاہک کم سے کم بار بار خریداری کر رہے ہیں؟
مثال کے طور پر:
monthly_revenue = (
    df.groupby(
        df["date"].dt.to_period("M")
    )["revenue"]
    .sum()
)
اس سے ماہانہ کل آمدنی ہوتی ہے۔
باب 6: مارکیٹنگ APIs کے ساتھ کام کرنا
فائل اس وقت کارآمد ہوتی ہے جب کوئی دستی طور پر ڈیٹا ایکسپورٹ کرتا ہے۔ لیکن آپ یہ کیسے یقینی بناتے ہیں کہ آپ کا مارکیٹنگ انٹیلی جنس سسٹم خود بخود ڈیٹا اکٹھا کرتا ہے؟
یہ وہ جگہ ہے جہاں APIs اہم ہو جاتے ہیں۔
ایک ایپلیکیشن پروگرامنگ انٹرفیس (API) ایک پروگرام کو دوسرے پروگرام کے ساتھ بات چیت کرنے کا ایک منظم طریقہ فراہم کرتا ہے۔
مثال کے طور پر، ایک پلیٹ فارم ایک اختتامی نقطہ کو ظاہر کر سکتا ہے جو مہم کی معلومات واپس کرتا ہے۔
ازگر درخواستیں بھیج سکتا ہے۔
import requests

response = requests.get(
    "https://example.com/api/campaigns"
)

print(response.status_code)
ایک کامیاب جواب میں عام طور پر درج ذیل اسٹیٹس کوڈ ہوتا ہے:
200
آپ رسپانس باڈی کا معائنہ کر سکتے ہیں۔
print(response.text)
اگر جواب میں JSON ہے:
data = response.json()
آپ چیک کر سکتے ہیں:
print(data)
API کی توثیق
حقیقی دنیا کے APIs کو اکثر تصدیق کی ضرورت ہوتی ہے۔
مثال کے طور پر:
api_key = "your-api-key"
لیکن آپ کو چاہئے ~ نہیں اپنی اصل خفیہ کلید کو براہ راست اس کوڈ کے اندر رکھیں جس کا آپ عوامی طور پر اشتراک کرنا چاہتے ہیں۔
اس کے بجائے ماحولیاتی متغیرات کا استعمال کریں۔
import os

api_key = os.getenv(
    "MARKETING_API_KEY"
)
اس کے بعد آپ ہیڈر کنفیگر کر سکتے ہیں۔
headers = {
    "Authorization": f"Bearer {api_key}"
}
اور پھر اس طرح کی درخواست کریں:
response = requests.get(
    "https://example.com/api/campaigns",
    headers=headers
)
درست تصدیق کا نظام API پر منحصر ہے۔
API کی خرابی۔
آپ کے پروگرام کو یہ نہیں سمجھنا چاہئے کہ تمام درخواستیں کامیاب ہوں گی۔
response = requests.get(
    api_url,
    timeout=30
)

if response.status_code == 200:
    data = response.json()
else:
    print(
        f"Request failed: "
        f"{response.status_code}"
    )
جب آپ API کی درخواست بھیجتے ہیں، تو جواب موصول ہونے کا لازمی طور پر یہ مطلب نہیں ہے کہ درخواست کامیاب تھی۔ سرور درج ذیل خرابی کی حیثیت واپس کر سکتا ہے: 404 Not Found یا 500 Internal Server Error.
کہ raise_for_status() طریقہ HTTP ردعمل کی حیثیت کو چیک کرتا ہے۔ اگر جواب ایک ناکام درخواست کو ظاہر کرتا ہے، تو یہ پروگرام کو جاری رکھنے کے بجائے ایک استثنا دیتا ہے گویا سب کچھ کام کر رہا ہے۔
کوئی راستہ نہیں try ایک بلاک آپ کو اس استثنا کو سنبھالنے کی اجازت دیتا ہے۔
import requests

try:
    response = requests.get(
        "https://example.com/api/campaigns",
        timeout=30
    )
    response.raise_for_status()
    campaigns = response.json()

except requests.exceptions.RequestException as error:
    print(f"Could not retrieve campaign data: {error}")
یہاں، requests.get() درخواست بھیجیں، timeout=30 پروگراموں کو غیر معینہ مدت تک انتظار کرنے سے روکتا ہے۔ raise_for_status() ناکام HTTP جوابات کے لیے ایک استثنا پیدا کرتا ہے۔ کہ except بلاک درخواست سے متعلق غلطیاں پکڑتا ہے اور ایک پیغام دکھاتا ہے۔
پروڈکشن ورک فلو میں، آپ کو یہ فیصلہ کرنا ہوگا کہ آیا غلطی کو لاگ ان کرنا ہے اور عمل کو دوبارہ آزمانا ہے، ناکام ذریعہ کو چھوڑنا ہے، یا رپورٹ کی تیاری کو روکنا ہے۔ ناکام درخواستوں کو خود بخود خالی ڈیٹا سیٹ نہ سمجھیں۔ اس کے نتیجے میں مارکیٹنگ کی گمراہ کن رپورٹس ہو سکتی ہیں۔
یہ خاص طور پر اہم ہے جب نظام خاموشی سے چلتا ہے۔ اگر آپ کا API صبح 3 بجے بند ہوجاتا ہے، تو آپ چاہتے ہیں کہ آپ کا پروگرام خود بخود خالی مارکیٹنگ رپورٹ تیار کرنے کے بجائے مسئلہ کی اطلاع دے۔
کچھ APIs فی درخواست صرف ایک محدود تعداد میں ریکارڈ واپس کرتے ہیں۔ مثال کے طور پر، اگر آپ کے اکاؤنٹ میں مہم کے ہزاروں ریکارڈ موجود ہیں، تو API پہلے 100 کو واپس کر سکتا ہے اور اگلے گروپ کو بازیافت کرنے کے لیے ایک لنک یا ٹوکن فراہم کر سکتا ہے۔ یہ عمل صفحہ بندی.
صفحہ بندی کے طریقے API کے لحاظ سے مختلف ہوتے ہیں۔ کچھ سروسز صفحہ نمبر استعمال کرتی ہیں، دیگر آف سیٹس کا استعمال کرتی ہیں، اور کچھ اگلے صفحہ پر تسلسل ٹوکن یا یو آر ایل فراہم کرتی ہیں۔ صفحہ بندی کو لاگو کرنے سے پہلے ہمیشہ API دستاویزات کو چیک کریں۔
مندرجہ ذیل مثال میں: results فہرست اور next URL:
import requests

def fetch_all_campaigns(api_url, headers):
    all_campaigns = []
    next_url = api_url

    while next_url:
        response = requests.get(
            next_url,
            headers=headers,
            timeout=30
        )
        response.raise_for_status()
        payload = response.json()

        all_campaigns.extend(payload["results"])
        next_url = payload.get("next")

    return all_campaigns
یہ فنکشن ابتدائی API URL سے شروع ہوتا ہے اور صفحات کی درخواست کرنا جاری رکھتا ہے۔ next_url URL پر مشتمل ہے۔ کہ extend() یہ طریقہ ہر صفحہ سے ریکارڈ کو اسی فہرست میں شامل کرتا ہے۔ اگر API اگلے صفحہ کا URL واپس نہیں کرتا ہے تو لوپ رک جائے گا۔
یہ ایک مثالی نمونہ ہے نہ کہ عالمگیر حل۔ آپ کا API مختلف فیلڈ کے نام استعمال کر سکتا ہے یا صفحہ بندی کا ایک مختلف طریقہ درکار ہے۔ عملی انضمام کے لیے، اپنی سروس کے دستاویزات کی پیروی کریں اور دوبارہ کوشش کی حد اور زیادہ سے زیادہ صفحہ شمار جیسے حفاظتی اقدامات پر غور کریں۔
API کی شرح کو محدود کرنا
APIs اکثر ان درخواستوں کی تعداد کو محدود کرتے ہیں جو کلائنٹ ایک مخصوص مدت کے اندر کر سکتے ہیں۔ یہ پابندیاں شرح کی حد. مثال کے طور پر، ایک سروس فی منٹ صرف ایک مخصوص تعداد میں درخواستوں کی اجازت دے سکتی ہے۔
اگر آپ کی مارکیٹنگ آٹومیشن اسکرپٹ بہت زیادہ درخواستیں بھیجتی ہے، تو آپ کا API HTTP واپس کر سکتا ہے۔ 429 Too Many Requests جواب فوری طور پر بار بار درخواستیں بھیجنے کے بجائے، پروگرام کو سروس رولز کے مطابق روک کر دوبارہ کوشش کرنی چاہیے۔
کچھ APIs فراہم کرتے ہیں: Retry-After جوابی ہیڈر یہ بتاتا ہے کہ کلائنٹ کو کتنی دیر انتظار کرنا چاہیے۔ یہاں ایک سادہ مثال ہے:
import time
import requests

def get_with_rate_limit(url, headers, max_retries=5):
    for attempt in range(max_retries):
        response = requests.get(
            url,
            headers=headers,
            timeout=30
        )

        if response.status_code == 429:
            retry_after = response.headers.get(
                "Retry-After", "2"
            )
            time.sleep(float(retry_after))
            continue

        response.raise_for_status()
        return response

    raise RuntimeError(
        "API request failed after repeated rate-limit responses."
    )
اس فنکشن میں ایک API ہے۔ 429 جواب اگر جواب میں شامل ہیں: Retry-After ہیڈر میں، فنکشن تاخیر کا تعین کرنے کے لیے اس قدر کا استعمال کرتا ہے۔ اگر کوئی ہیڈر نہیں ہے تو 2 سیکنڈ انتظار کریں۔
یہ ایک مکمل پروڈکشن ریٹری سسٹم کے بجائے ایک نقطہ آغاز ہے۔ کچھ APIs دوبارہ کوشش کرنے کے مختلف اصول استعمال کرتے ہیں، اور پروڈکشن سسٹمز کو سرور کی عارضی غلطیوں، لاگنگ، ایکسپونینشل بیک آف، اور ضرورت سے زیادہ دوبارہ کوششوں کے خلاف تحفظات پر بھی غور کرنا چاہیے۔ ہمیشہ اپنے API فراہم کنندہ کے دستاویزات کی پیروی کریں۔
شرح کی حدود کو سنبھالنا خاص طور پر اس وقت اہم ہوتا ہے جب متعدد مہمات یا اکاؤنٹس میں رپورٹس کو خودکار بنایا جائے۔ ان پابندیوں پر عمل کرنا انضمام کو زیادہ قابل اعتماد بناتا ہے اور ڈیٹا اکٹھا کرنے میں رکاوٹوں کے امکانات کو کم کرتا ہے۔
حصہ 3: پانڈوں کے ساتھ ڈیٹا کی صفائی اور تجزیہ
مارکیٹنگ کے تجزیات کا پہلا اصول سادہ ہونا چاہیے۔ کسی ڈیٹاسیٹ پر اس وقت تک بھروسہ نہ کریں جب تک آپ اس کی جانچ نہ کر لیں۔
اس کا مطلب یہ نہیں ہے کہ آپ کا ڈیٹا خراب ہے۔ اس کا مطلب صرف یہ ہے کہ آپ کو اس کی بنیاد پر کوئی فیصلہ کرنے سے پہلے اس کا تجزیہ کرنے اور اس کی تصدیق کرنے کی ضرورت ہے۔
یہاں تک کہ اگر آپ کے ڈیٹا سیٹ میں لاکھوں بالکل فارمیٹ شدہ قطاریں ہیں، تب بھی یہ غلط مواد کی نمائندگی کر سکتا ہے۔
باب 7: ڈیٹا کوالٹی چیکنگ
کے ساتھ شروع کریں:
df.info()
یہ معلومات فراہم کرتا ہے:
- قطاروں کی تعداد
- کالم کا نام
- لاپتہ قدر
- ڈیٹا کی قسم
- میموری کا استعمال
آپ بھی استعمال کر سکتے ہیں:
df.describe()
یہ عددی کالموں کے بارے میں شماریاتی معلومات فراہم کرتا ہے۔
مثال کے طور پر، آپ دریافت کر سکتے ہیں کہ:
revenue
count    1000
mean     5820
min      -250
max      85000
منفی کم از کم فوری تحقیقات کی ضرورت ہے۔
منفی آمدنی کی قدریں درست ہو سکتی ہیں اگر وہ چارج بیک کی نمائندگی کرتی ہیں یا ڈیٹا انٹری کی غلطی کی نشاندہی کر سکتی ہیں۔
اکیلے نمبر آپ کو یہ نہیں بتاتے کہ کون سا ہے۔
لاپتہ قدر
لاپتہ اقدار کو استعمال کرتے ہوئے چیک کریں:
df.isnull().sum()
آپ دیکھ سکتے ہیں:
customer_id       0
campaign          3
channel           0
revenue          12
cost              4
اب آپ بالکل جانتے ہیں کہ گمشدہ معلومات کہاں ہے۔
ڈیٹا کی کمی کیوں اہمیت رکھتی ہے۔
فرض کریں کہ آپ اوسط منافع کا حساب لگانا چاہتے ہیں۔
df["revenue"].mean()
پانڈا عام طور پر گمشدہ اقدار کو حساب سے خارج کرتے ہیں۔
یہ آسان ہوسکتا ہے، لیکن آپ کو یہ سمجھنے کی ضرورت ہے کہ اقدار کیوں غائب ہیں۔
اگر گمشدہ اقدار بے ترتیب ہوں تو ایک نقطہ نظر کام کر سکتا ہے: اگر آمدنی کی گمشدہ قیمتیں ایک مخصوص سیلز چینل سے آتی ہیں، تو ان کو نظر انداز کرنا آپ کے نتائج پر تعصب کر سکتا ہے۔
لاپتہ ڈیٹا محض ایک تکنیکی مسئلہ نہیں ہے۔ یہ آپ کے مارکیٹنگ کے تجزیے سے اخذ کردہ نتائج کو تبدیل کر سکتا ہے۔
ہم کہتے ہیں کہ مہم کے کئی ریکارڈز میں آمدنی کی قدر نہیں ہوتی ہے۔ تمام گمشدہ اقدار کو 0 سے تبدیل کرنے سے یہ فرض ہوتا ہے کہ مہم سے کوئی آمدنی نہیں ہوئی۔ تاہم، قدروں کی کمی کا مطلب یہ ہو سکتا ہے کہ آپ اپنی کمائی کو ٹریک کرنے میں ناکام رہے، ڈیٹا ابھی تک نہیں آیا، یا آپ کی خریداری کی معلومات کہیں اور محفوظ ہے۔
یہ حالات ایک جیسے نہیں ہیں۔
گمشدہ اقدار کو پُر کرنے یا ہٹانے سے پہلے، اپنے آپ سے درج ذیل پوچھیں:
- اقدار کیوں غائب ہیں؟
- کیا گمشدہ اقدار کا اصل مطلب 0 ہے، یا معلومات غیر معلوماتی ہے؟
- کتنے ریکارڈ متاثر ہوئے ہیں؟
- کیا ان ریکارڈز کو ہٹانے سے تجزیہ کا تعصب ہو گا؟
مثال کے طور پر، اگر آپ اشتہار کے کھوئے ہوئے اخراجات کو صفر کے ساتھ پُر کرتے ہیں، تو آپ کی مہم کے لیے اشتہاری اخراجات پر واپسی گمراہ کن یا غیر واضح ہو سکتی ہے۔ اسی طرح، گمشدہ گاہک کی صفات کے ساتھ تمام قطاروں کو ہٹانے کے نتیجے میں اہم کسٹمر گروپس کو تجزیہ سے خارج کر دیا جا سکتا ہے۔
استعمال کریں fillna() یا dropna() یہ صرف اس بات کا تعین کرنے کے بعد کیا جا سکتا ہے کہ ڈیٹا سیٹ کے تناظر میں گمشدہ اقدار کا کیا مطلب ہے۔ اہم مفروضوں کو دستاویز کریں تاکہ دوسرے یہ سمجھ سکیں کہ نتائج کیسے پہنچے۔
ڈپلیکیٹ ریکارڈ
اس طرح کی نقلیں چیک کریں:
df.duplicated().sum()
اگر نتیجہ 25 ہے، تو بالکل 25 ڈپلیکیٹ قطاریں ہیں۔
آپ اسے اس طرح ہٹا سکتے ہیں:
df = df.drop_duplicates()
لیکن اپنے تجزیہ کی اکائی کو یاد رکھیں۔
چونکہ ایک گاہک متعدد خریداریاں کر سکتا ہے، اس لیے ضروری نہیں کہ ایک ہی کسٹمر ID والی دو قطاریں ڈپلیکیٹ ہوں۔
ایک ہی مہم کے نام کے ساتھ دو قطاریں ضروری نہیں کہ ڈپلیکیٹ ہوں۔ اس کی وجہ یہ ہے کہ مہمات کا ڈیٹا کئی دنوں میں ریکارڈ کیا جا سکتا ہے۔
ریکارڈز کو صرف اس لیے حذف نہ کریں کہ وہ ایک یا دو قدروں کا اشتراک کرتے ہیں۔ ہمیشہ پہلے اس قدر کو چیک کریں۔
باب 8: ٹیکسٹ ڈیٹا کی صفائی
مارکیٹنگ ڈیٹا سیٹس میں اکثر متضاد متن ہوتا ہے۔
آپ تلاش کر سکتے ہیں:
Email
email
EMAIL
Email Marketing
ازگر اسے ایک مختلف قدر سمجھتا ہے۔
اپنے طریقوں کو معیاری بنا کر شروع کریں۔
df["channel"] = (
    df["channel"]
    .str.lower()
)
پھر کسی بھی غیر ضروری جگہ کو ہٹا دیں۔
df["channel"] = (
    df["channel"]
    .str.strip()
)
اب یہ:
Email
email
EMAIL
سب کو مندرجہ ذیل طور پر معیاری بنایا جائے گا:
email
آپ مخصوص لیبلز کو بھی معیاری بنا سکتے ہیں۔
df["channel"] = df["channel"].replace({
    "email marketing": "email",
    "paid social": "social media",
    "social": "social media"
})
معیاری کاری کیوں ضروری ہے۔
اپنے ڈیٹا کو صاف کرنے سے پہلے چینل کے حساب سے آمدنی کا حساب لگائیں۔
آپ حاصل کر سکتے ہیں:
email            $20,000
Email            $15,000
EMAIL             $8,000
آپ کا کاروبار درحقیقت ایک چینل سے $43,000 پیدا کر رہا ہو سکتا ہے، لیکن اگر آپ نے معیاری نہیں بنایا ہے، تو آپ کے تجزیات اس چینل کو ایک الگ چینل کے طور پر غلط طریقے سے پیش کریں گے۔
یہ صرف ایک چھوٹی سی مثال ہے کہ کس طرح ڈیٹا کا معیار کاروباری فیصلوں کو متاثر کر سکتا ہے۔
باب 9: عددی ڈیٹا کو منظم کرنا
نمبر بعض اوقات آپ کے ڈیٹاسیٹ میں عددی اقدار کے بجائے متن کے طور پر آتے ہیں۔ یہ خاص طور پر عام ہے جب اسپریڈ شیٹس، اشتہاری پلیٹ فارمز، یا کسٹمر ریلیشن شپ مینجمنٹ (CRM) سسٹمز سے برآمد کردہ مارکیٹنگ رپورٹس کے ساتھ کام کرتے ہیں۔
مثال کے طور پر، ریونیو کالم میں درج ذیل اقدار شامل ہو سکتی ہیں:
"$5,000"
"$7,500"
"$2,300"
یہ قدریں پیسے کی نمائندگی کرتی ہیں، لیکن چونکہ ان میں ڈالر کے نشانات اور کوما جیسے حروف ہوتے ہیں، پائتھون انہیں تار کے طور پر محفوظ کر سکتا ہے۔ سٹرنگ حروف کا ایک سلسلہ ہے، نمبر نہیں، جسے ازگر ریاضی کے حساب میں براہ راست استعمال کر سکتا ہے۔
مثال کے طور پر، Python قابل اعتماد طریقے سے کرنسی کی علامتوں پر مشتمل تاروں پر رقم یا اوسط کا حساب نہیں لگا سکتا۔ مارکیٹنگ میٹرکس کا حساب لگانے سے پہلے، آپ کو ان اقدار کو صاف کرنے اور انہیں مناسب عددی قسم میں تبدیل کرنے کی ضرورت ہے۔
کرنسی کی علامت اور جداکار کو ہٹا دیں۔
پہلا قدم ان حروف کو ہٹانا ہے جو ازگر کو ایک نمبر کے طور پر قدر کی تشریح کرنے سے روکتے ہیں۔
df["revenue"] = (
    df["revenue"]
    .str.replace("$", "", regex=False)
    .str.replace(",", "", regex=False)
)
یہاں، "علامتوں کو ہٹانے" کا مطلب ہے فارمیٹنگ حروف کو ہٹانا جیسے: $ اور , متن میں۔ آپ کا کوڈ تبدیل ہو جائے گا۔ "$5,000" ~ میں "5000". نتیجہ اب بھی ایک تار ہے۔ متن کی صفائی خود بخود اسے عددی قدر میں تبدیل نہیں کرتی ہے۔
صاف شدہ اقدار کو نمبروں میں تبدیل کریں۔
فارمیٹنگ حروف کو ہٹانے کے بعد، صاف شدہ سٹرنگ کو عددی قدر میں تبدیل کریں۔
df["revenue"] = pd.to_numeric(
    df["revenue"],
    errors="coerce"
)
اس مثال میں سوئچ اس کا مطلب ہے صاف شدہ متن کو عددی ڈیٹا کی قسم میں تبدیل کرنا جسے ازگر جمع، گھٹاؤ، ضرب، تقسیم اور شماریاتی حساب کے لیے استعمال کر سکتا ہے۔
کہ errors="coerce" دلیل پانڈوں کو ان اقدار کو تبدیل کرنے کے لئے کہتی ہے جن کی تعداد کے ساتھ تشریح نہیں کی جاسکتی ہے: NaNایک غائب یا غیر دستیاب عددی قدر کی نشاندہی کرتا ہے۔ یہ غلط متن کو خود بخود درست نمبروں کے طور پر مانے جانے سے روکتا ہے، لیکن اس کا مطلب یہ بھی ہے کہ ان تمام اقدار کی جانچ کی جانی چاہیے جنہیں اہم نمبر سمجھا جاتا ہے۔ NaN.
آپ مندرجہ ذیل طور پر متاثرہ ریکارڈ کی شناخت کر سکتے ہیں:
df[df["revenue"].isna()]
اگر آپ کے سورس کالم میں گمشدہ اقدار ہو سکتی ہیں، تو صفائی سے پہلے ایک کاپی محفوظ کرنے سے آپ ان اقدار کے درمیان فرق کر سکتے ہیں جو پہلے سے غائب ہیں اور ان اقدار کے درمیان جو تبدیلی کے دوران غلط ہو گئی تھیں۔
original_revenue = df["revenue"].copy()

cleaned_revenue = (
    original_revenue
    .str.replace("$", "", regex=False)
    .str.replace(",", "", regex=False)
)

numeric_revenue = pd.to_numeric(
    cleaned_revenue,
    errors="coerce"
)

invalid_revenue = (
    cleaned_revenue.notna()
    & numeric_revenue.isna()
)

df["revenue"] = numeric_revenue

print(df.loc[invalid_revenue, "revenue"])
مزید تفتیش کے لیے اصل اقدار کو تبدیل کرنے سے پہلے الگ کالم میں رکھیں۔
غلط اقدار کی جانچ کریں۔
متن کو اعداد میں تبدیل کرنا اس بات کی ضمانت نہیں دیتا کہ نتیجے میں آنے والی قدریں معنی خیز ہیں۔ آپ کے ڈیٹاسیٹ میں منفی تبادلوں کی شرح یا غیر معمولی طور پر بڑی شرح ہوسکتی ہے۔
مثال کے طور پر:
conversion_rate
5.2
4.8
-17
250
تبادلوں کی شرح 250% اگر آپ کا میٹرک کلکس سے تقسیم شدہ تبادلوں کی نمائندگی کرتا ہے، اور ہر کلک 1 سے کم تبدیلی پیدا کر سکتا ہے، تو یہ مشکوک ہے۔ تاہم، یہ دوسری تعریفوں کے تحت درست ہو سکتا ہے، جیسے کہ جب میٹرک متعدد تبادلوں کے واقعات کو فی کلک شمار کرتا ہے۔ منفی تبادلوں کی شرح عام طور پر تفتیش کی ضمانت دیتی ہے۔
آپ یہ استعمال کرتے ہوئے اپنی موجودہ تبادلوں کی شرح کی مخصوص حد سے باہر اقدار تلاش کر سکتے ہیں:
df[
    (df["conversion_rate"] < 0)
    | (df["conversion_rate"] > 100)
]
یہ کوڈ اس ریکارڈ کی نشاندہی کرتا ہے جس کا جائزہ لیا جائے۔ یہ خود بخود اس بات کا تعین نہیں کرتا ہے کہ آیا یہ غلطی ہے۔ ریکارڈز میں ترمیم کرنے یا ہٹانے سے پہلے میٹرک تعریفیں، سورس ڈیٹا، اور کاروباری سیاق و سباق کو چیک کریں۔
لہذا آپ کو جو چیز یاد رکھنے کی ضرورت ہے وہ یہ ہے کہ اپنے فارمیٹنگ کریکٹرز کو صاف کریں، صاف شدہ اقدار کو درست ڈیٹا ٹائپ میں تبدیل کریں، اور اپنے مارکیٹنگ کے حسابات میں استعمال کرنے سے پہلے نتائج کی توثیق کریں۔
باب 10: پانڈوں کا استعمال کرتے ہوئے مارکیٹنگ میٹرکس بنانا
خام مارکیٹنگ ڈیٹا آپ کو بتاتا ہے کہ کیا ہوا، لیکن حسابی میٹرکس کارکردگی کا اندازہ کرنے میں آپ کی مدد کرتے ہیں۔ پانڈاس آپ کو یہ پیمائش کرنے کے لیے نئے کالم بنانے دیتا ہے کہ آپ کی مہمات کتنی مؤثر طریقے سے نقوش کو کلکس میں، کلکس کو تبادلوں میں، اور اشتھاراتی اخراجات کو آمدنی میں تبدیل کرتی ہیں۔
ان میٹرکس کا حساب لگانے سے پہلے، یقینی بنائیں کہ آپ کے کالموں میں عددی قدریں ہیں اور آپ کا ڈیٹا مستقل اکائیوں کا استعمال کرتا ہے۔
عام مارکیٹنگ میٹرکس کا حساب لگائیں۔
کلک کے ذریعے شرح (CTR) نقوش کے فیصد کی پیمائش کرتا ہے جس کے نتیجے میں کلکس ہوتے ہیں۔
df["ctr"] = (
    df["clicks"]
    .div(df["impressions"])
    .mul(100)
)
تبادلوں کی شرح ان کلکس کے فیصد کی پیمائش کرتا ہے جو تبادلوں کا باعث بنتے ہیں۔
df["conversion_rate"] = (
    df["conversions"]
    .div(df["clicks"])
    .mul(100)
)
لاگت فی کلک (CPC) ہر کلک کے لیے اشتہارات کی اوسط لاگت کی پیمائش کرتا ہے۔
df["cpc"] = (
    df["cost"]
    .div(df["clicks"])
)
لاگت فی حصول (CPA) ایک منتقلی یا حصول بنانے کی اوسط لاگت کی پیمائش کرتا ہے، اس پر منحصر ہے کہ کمپنی کس طرح حصول کی وضاحت کرتی ہے۔
df["cpa"] = (
    df["cost"]
    .div(df["conversions"])
)
اشتہاری اخراجات پر واپسی (ROAS) اشتہاری اخراجات کے مقابلے میں اشتہارات سے حاصل ہونے والی آمدنی کی پیمائش کرتا ہے۔
جیسا کہ ہم نے پہلے احاطہ کیا ہے، آپ پانڈوں میں ROAS کا حساب لگا سکتے ہیں۔
df["roas"] = (
    df["revenue"]
    .div(df["cost"])
)
ہر میٹرک کی صحیح تشریح ڈیٹاسیٹ میں استعمال کی گئی تعریف پر منحصر ہے۔ مثال کے طور پر، ایک تبدیلی خریداری، سائن اپ، اہل قیادت، یا دیگر مطلوبہ کارروائی کی نمائندگی کر سکتی ہے۔
صفر اقدار کے خلاف حفاظت
مارکیٹنگ ڈیٹاسیٹس میں ایسی مہمات شامل ہو سکتی ہیں جن میں کوئی کلکس، کوئی تبادلوں، یا کوئی اشتہاری خرچ نہیں۔ ان اقدار کو احتیاط کے ساتھ سنبھالا جانا چاہئے کیونکہ صفر سے تقسیم غیر متعینہ ہے۔
مندرجہ ذیل حساب پر غور کریں:
df["conversion_rate"] = (
    df["conversions"]
    .div(df["clicks"])
    .mul(100)
)
اگر آپ کی مہم میں 0 کلکس ہیں، تو آپ کے تبادلوں کی شرح کے حساب کتاب میں ڈینومینیٹر 0 ہے۔ اس کا مطلب ہے کہ کلک پر مبنی کوئی درست شرح نہیں ہے جو اس مہم کے لیے شمار کی جا سکے۔ اسی طرح، اگر آپ کی تبدیلیاں 0 ہیں تو آپ CPA کا حساب نہیں لگا سکتے، اور اگر آپ کی اشتھاراتی لاگت 0 ہے تو آپ ROAS کا حساب نہیں لگا سکتے۔
ایک محفوظ نقطہ نظر یہ ہے کہ تقسیم کو انجام دینے سے پہلے زیرو ڈینومینیٹر کو گمشدہ قدر سے بدل دیا جائے۔
df["conversion_rate"] = (
    df["conversions"]
    .div(df["clicks"].replace(0, float("nan")))
    .mul(100)
)

df["cpa"] = (
    df["cost"]
    .div(df["conversions"].replace(0, float("nan")))
)

df["roas"] = (
    df["revenue"]
    .div(df["cost"].replace(0, float("nan")))
)
یہ نقطہ نظر زیادہ محفوظ ہے کیونکہ یہ غیر متعینہ حسابات کو بامعنی نتائج کے طور پر پیش کرنے سے گریز کرتا ہے۔ اگر کلکس کی تعداد 0 ہے، تو تبادلوں کی شرح کو درست شرح کے طور پر رپورٹ نہیں کیا جائے گا اور وہ چھوٹ جائے گی۔ اگر آپ کے تبادلے 0 ہیں، تو آپ ایک محدود لاگت فی حصول کے بجائے CPA استعمال نہیں کر سکتے۔ اگر لاگت 0 ہے، تو اسے درست شرح نہیں سمجھا جائے گا اور ROAS دستیاب نہیں ہے۔
قدروں کی کمی کا مطلب یہ نہیں ہے کہ میٹرک 0 ہے۔ مثال کے طور پر:
- 100 کلکس کے نتیجے میں تبدیلی نہیں ہوگی: تبادلوں کی شرح 0% ہے۔
- کوئی کلکس نہیں: کلک پر مبنی تبادلوں کی شرحوں کا حساب نہیں لگایا جا سکتا۔
- صفر اشتہاری اخراجات: آمدنی کو اخراجات سے تقسیم کر کے ROAS کا حساب نہیں لگایا جا سکتا۔
ان حالات کے مختلف کاروباری مضمرات ہوتے ہیں اور ان کو قابل تبادلہ نہیں سمجھا جانا چاہیے۔
آپ چیک کر سکتے ہیں کہ کن ریکارڈز میں میٹرکس دستیاب نہیں ہیں۔
df[
    df[
        ["conversion_rate", "cpa", "roas"]
    ].isna().any(axis=1)
]
اپنی رپورٹس میں میٹرکس استعمال کرنے یا مہم کے فیصلے کرنے سے پہلے ان ریکارڈز کی تحقیق کریں۔
نتائج کی تشریح
میٹرکس بنانا صرف شروعات ہے۔ ایک اعلی CTR کا لازمی طور پر یہ مطلب نہیں ہے کہ آپ کی مہم قیمتی گاہک پیدا کرے گی، اور اعلی ROAS کا خود بخود یہ مطلب نہیں ہے کہ آپ کی مہم منافع بخش ہوگی۔
ایک ساتھ متعدد میٹرکس استعمال کریں۔ CTR آپ کو مشغولیت کی پیمائش کرنے میں مدد کرتا ہے، تبادلوں کی شرح آپ کو یہ اندازہ کرنے میں مدد کرتی ہے کہ کلکس سے مطلوبہ کارروائیاں کس حد تک مؤثر طریقے سے ہوتی ہیں، CPA آپ کو حصول کی کارکردگی کا جائزہ لینے میں مدد کرتا ہے، اور ROAS اشتہار کے اخراجات کے مقابلے میں انتساب کی واپسی کا اندازہ کرنے میں آپ کی مدد کرتا ہے۔
مقصد ہر میٹرک کو آزادانہ طور پر زیادہ سے زیادہ کرنا نہیں ہے۔ آپ یہ سمجھنا چاہتے ہیں کہ آپ کے میٹرکس ایک ساتھ کیسے کام کرتے ہیں اور کیا وہ آپ کے کاروباری اہداف کی حمایت کرتے ہیں۔
باب 11: ڈیٹا فلٹرنگ
فلٹرنگ آپ کو ٹارگٹڈ سوالات پوچھنے کی اجازت دیتی ہے۔ خاص طور پر، آپ تلاش کر سکتے ہیں:
3 سے زیادہ ROAS والی مہمات:
high_roas = df[
    df["roas"] > 3
]
اعلی تبادلوں کی شرح کے ساتھ مہمات:
high_conversion = df[
    df["conversion_rate"] > 5
]
ایک مہم جو دونوں کام کرتی ہے:
strong_campaigns = df[
    (df["roas"] > 3) &
    (df["conversion_rate"] > 5)
]
وہ مہم جو درج ذیل میں سے کسی ایک کو پورا کرتی ہیں:
promising_campaigns = df[
    (df["roas"] > 4) |
    (df["conversion_rate"] > 7)
]
متن کے لحاظ سے فلٹر کریں۔
ای میل مہمات:
email = df[
    df["channel"] == "email"
]
آپ متن تلاش کر سکتے ہیں۔
holiday = df[
    df["campaign"]
    .str.contains(
        "holiday",
        case=False,
        na=False
    )
]
جب آپ کی مہم کے نام ایک پیٹرن کی پیروی کرتے ہیں تو یہ مفید ہے۔
باب 12۔ گروپ بائی، مارکیٹنگ کے تجزیات کا مرکز
مارکیٹنگ کے تجزیات کے لیے پانڈوں کے سب سے مفید کاموں میں سے ایک یہ ہے: groupby(). یہ آپ کو ان گروپوں میں قطاروں کو ترتیب دینے کی اجازت دیتا ہے جو اقدار کا اشتراک کرتے ہیں اور ہر گروپ کے لیے خلاصہ کا حساب لگاتے ہیں۔
تصور کریں کہ آپ کا ڈیٹا سیٹ متعدد مارکیٹنگ چینلز کے مہم کے نتائج پر مشتمل ہے، بشمول ای میل، تلاش، سوشل میڈیا، اور ڈسپلے ایڈورٹائزنگ۔ ہر مہم کو انفرادی طور پر دیکھنے سے یہ سمجھنا مشکل ہو سکتا ہے کہ کون سے چینلز سب سے زیادہ ریونیو لے رہے ہیں یا سب سے زیادہ تبادلے کر رہے ہیں۔
کے ساتھ groupby()آپ چینل کے لحاظ سے مہم کی سرگزشت کو یکجا کر سکتے ہیں اور ہر چینل کے لیے میٹرکس کا حساب لگا سکتے ہیں۔
چینل کے لحاظ سے گروپ مہمات
فرض کریں کہ آپ کے ڈیٹا سیٹ میں درج ذیل کالم ہیں: channel اور دوسرا نام revenue. آپ ہر چینل کی کل آمدنی کا حساب لگا سکتے ہیں۔
channel_revenue = (
    df.groupby("channel")["revenue"]
    .sum()
)

print(channel_revenue)
کوڈ تمام قطاروں کو ایک ہی چینل کے نام کے ساتھ گروپ کرتا ہے، ریونیو کالم کو منتخب کرتا ہے، اور پھر ہر گروپ کے اندر ریونیو کی قدریں شامل کرتا ہے۔
آپ اوسط واپسی کا حساب لگانے کے لیے ایک ہی طریقہ استعمال کر سکتے ہیں۔
channel_average = (
    df.groupby("channel")["revenue"]
    .mean()
)
ہر چینل کے لیے مہم کے ریکارڈ کی تعداد کا حساب لگائیں۔
campaign_count = (
    df.groupby("channel")
    .size()
)
یا کل تبادلوں کا حساب لگائیں۔
channel_conversions = (
    df.groupby("channel")["conversions"]
    .sum()
)
ہر نتیجہ ایک مختلف سوال کا جواب دیتا ہے۔ کل آمدنی کسی چینل سے وابستہ آمدنی کی پیمائش کرتی ہے، اوسط آمدنی فی ریکارڈ اوسط آمدنی کی نمائندگی کرتی ہے، مہمات کی تعداد موجودہ ریکارڈز کی تعداد کی نمائندگی کرتی ہے، اور کل تبادلوں سے کسی چینل سے منسوب تبادلوں کی تعداد کی پیمائش ہوتی ہے۔
ایک مکمل مارکیٹنگ رپورٹ بنائیں
مارکیٹنگ کے فیصلوں کے لیے عام طور پر ایک سے زیادہ میٹرک کی ضرورت ہوتی ہے۔ ہر خلاصے کا الگ سے حساب لگانے کے بجائے، آپ استعمال کر سکتے ہیں: agg() ایک آپریشن میں متعدد ٹوٹل کا حساب لگائیں۔
channel_summary = (
    df.groupby("channel")
    .agg({
        "impressions": "sum",
        "clicks": "sum",
        "conversions": "sum",
        "cost": "sum",
        "revenue": "sum"
    })
)
یہ ایک ٹیبل بناتا ہے جس میں فی چینل ایک قطار اور ہر کل کے لیے ایک کالم ہوتا ہے۔ اس کے بعد آپ ان رقوم کو ROAS اور CPA کا حساب لگانے کے لیے استعمال کر سکتے ہیں۔
channel_summary["roas"] = (
    channel_summary["revenue"]
    .div(channel_summary["cost"].replace(0, float("nan")))
)

channel_summary["cpa"] = (
    channel_summary["cost"]
    .div(
        channel_summary["conversions"].replace(
            0, float("nan")
        )
    )
)

print(channel_summary.round(2))
مثال کے طور پر، ہم کہتے ہیں کہ آپ کا ڈیٹا درج ذیل مثال کی رپورٹ تیار کرتا ہے:
| چینل | نقوش | کلکس کی تعداد | تبدیلی | خرچ | آمدنی | گلاب | CPAs |
|---|---|---|---|---|---|---|---|
| ای میل | 50,000 | 4,000 | 500 | $2,000 | $10,000 | 5.00 | $4.00 |
| تلاش کریں | 80,000 | 6,000 | 300 | $3,000 | $9,000 | 3.00 | $10.00 |
| سوشل میڈیا | 100,000 | 5,000 | 250 | $2,500 | $7,500 | 3.00 | $10.00 |
یہ مثال کے اعداد و شمار ہے جو رپورٹ کے ڈھانچے کو ظاہر کرنے کے لیے دکھایا گیا ہے۔
یہ جدول انفرادی ٹوٹل کی فہرست سے زیادہ کارآمد ہے کیونکہ یہ آپ کو ایک جگہ پہنچ، مشغولیت، تبادلوں، لاگت، اور قابل منسوب آمدنی کا موازنہ کرنے کی اجازت دیتا ہے۔
اس مثال میں، ای میل میں تینوں چینلز میں سب سے زیادہ ROAS اور سب سے کم CPA ہے۔ سوشل میڈیا کے سب سے زیادہ نقوش ہیں، لیکن اس کی رسائی سب سے زیادہ آمدنی یا کل تبادلوں کی شرحوں میں ترجمہ نہیں کرتی ہے۔ یہ نتائج ایسے سوالات اٹھاتے ہیں جن کی چھان بین کی ضرورت ہے، لیکن یہ خود بخود ثابت نہیں ہوتے کہ ایک چینل دوسرے سے بہتر کارکردگی کیوں دکھا رہا ہے۔
رقم سے فیصد کیوں شمار کریں؟
مجموعی طور پر چینل ROAS کا حساب لگاتے وقت، کل منسوب آمدنی کو اشتہار کے کل اخراجات سے تقسیم کریں۔ CPA کا حساب لگاتے وقت، اپنی کل لاگت کو تبادلوں کی کل تعداد سے تقسیم کریں۔
اگر آپ مجموعی چینل میٹرکس چاہتے ہیں، تو صرف انفرادی مہم ROAS یا CPA اقدار کا اوسط نہ بنائیں۔ چونکہ مختلف مہمات کے بجٹ اور تبادلوں کا حجم بہت مختلف ہو سکتا ہے، ایک سادہ اوسط آپ کو چھوٹی اور بڑی مہمات کو برابر وزن دینے کی اجازت دیتی ہے۔
یہاں اہم سبق یہ ہے: groupby() یہ انفرادی مہم کے ریکارڈز کو خلاصوں میں تبدیل کرنے میں مدد کرتا ہے جو چینل کے موازنہ اور رپورٹنگ کی حمایت کرتے ہیں۔ نتائج اس وقت زیادہ معنی خیز ہو جاتے ہیں جب آپ گروپ کردہ ٹوٹل سے متعلقہ میٹرکس کا حساب لگاتے ہیں اور سیاق و سباق میں ان کی تشریح کرتے ہیں۔
باب 13: تحقیقی ڈیٹا کا تجزیہ
تحقیقی ڈیٹا تجزیہ، جسے عام طور پر EDA کہا جاتا ہے، نتائج اخذ کرنے یا پیشین گوئی کرنے والے ماڈل بنانے سے پہلے ڈیٹا سیٹس کی ساخت، معیار، نمونوں اور ممکنہ تعلقات کو سمجھنے کے لیے جانچنے کا عمل ہے۔
ای ڈی اے کا مقصد اعداد و شمار تیار کرنا اور ڈیٹا کے بارے میں عملی سوالات کا جواب دینا ہے۔
- ڈیٹا سیٹ کیا معلومات پر مشتمل ہے؟
- کیا اقدار غائب، ڈپلیکیٹ یا خراب ہیں؟
- کون سی مہمات یا چینلز مختلف کارکردگی کا مظاہرہ کر رہے ہیں؟
- کیا کوئی غیر معمولی قدریں ہیں جن کی چھان بین کی ضرورت ہے؟
- کیا متغیرات ایک ساتھ حرکت کرتے نظر آتے ہیں؟
- کیا ایسے نمونے ہیں جو آپ کی مارکیٹنگ کی کارکردگی کی وضاحت میں مدد کر سکتے ہیں؟
EDA آپ کو یہ دریافت کرنے میں مدد کرتا ہے کہ آپ کا ڈیٹا کس چیز کو سپورٹ کر سکتا ہے اور ابھی بھی کن چیزوں کی چھان بین کی ضرورت ہے۔ یہ ڈیٹا کے معیار کے مسائل کو بھی ظاہر کر سکتا ہے جو گمراہ کن رپورٹس یا مشین لرننگ کے ناقابل اعتبار ماڈلز کا باعث بن سکتے ہیں۔
مرحلہ 1: اپنے ڈیٹا سیٹ کو سمجھیں۔
قطاروں اور کالموں کی تعداد کی جانچ کرکے، ریکارڈ کا پیش نظارہ کرکے، اور ڈیٹا کی اقسام کی جانچ کرکے شروع کریں۔
print(df.shape)
print(df.head())
print(df.info())
df.shape ڈیٹاسیٹ کے طول و عرض کو دکھاتا ہے۔ df.head() پہلی چند قطاریں دکھائیں، df.info() کالم، ڈیٹا کی اقسام، اور غیر غائب اقدار کا خلاصہ کرتا ہے۔
یہ چیک ان مسائل کو ظاہر کر سکتے ہیں جیسے کہ ریونیو کالمز کو ٹیکسٹ کے طور پر اسٹور کیا جا رہا ہے یا کالم ایسے ہیں جن میں توقع سے کم ریکارڈ موجود ہیں۔
مرحلہ 2: خلاصہ کے اعدادوشمار کی چھان بین کریں۔
print(df.describe())
عددی کالموں کے لیے describe() اعدادوشمار کی اطلاع دیں جیسے شمار، اوسط، معیاری انحراف، کم از کم، چوتھائی، اور زیادہ سے زیادہ۔
یہ اقدار آپ کو عام اقدار کو سمجھنے اور ممکنہ بے ضابطگیوں کی نشاندہی کرنے میں مدد کرتی ہیں۔ مثال کے طور پر، غیر معمولی طور پر زیادہ اشتہاری اخراجات والی مہم جائز ہو سکتی ہے یا یہ ڈیٹا انٹری کی غلطی کی نشاندہی کر سکتی ہے۔ اکیلے خلاصہ اس بات کا تعین نہیں کر سکتا کہ کون سی وضاحت درست ہے۔
مرحلہ 3: گمشدہ اور ڈپلیکیٹ ریکارڈز کی جانچ کریں۔
print(df.isnull().sum())
print(df.duplicated().sum())
لاپتہ اقدار حسابات اور ماڈلز کو متاثر کر سکتی ہیں۔ ڈپلیکیٹ قطاریں بار بار برآمدات یا ڈپلیکیٹ ریکارڈ کی نشاندہی کر سکتی ہیں، لیکن دہرائی گئی قدریں خود بخود ڈپلیکیٹ نہیں ہوتیں۔ کسی ریکارڈ کو حذف کرنے سے پہلے، یہ چیک کریں کہ آیا یہ درحقیقت دہرایا گیا مشاہدہ ہے یا ایک درست انفرادی واقعہ۔
مرحلہ 4: تحقیقی زمرے
مارکیٹنگ ڈیٹا میں اکثر زمرے شامل ہوتے ہیں جیسے چینل، مہم، علاقہ، سامعین، یا ڈیوائس کی قسم۔
print(df["channel"].value_counts())
print(df["campaign"].value_counts())
یہ خلاصہ دکھاتا ہے کہ ہر زمرے میں کتنے ریکارڈ آتے ہیں۔ اگر ایک چینل صرف ایک بار ظاہر ہوتا ہے اور دوسرا سینکڑوں بار ظاہر ہوتا ہے، تو عدم توازن متاثر کر سکتا ہے کہ موازنہ کی تشریح کیسے کی جاتی ہے۔
مرحلہ 5: تقسیم اور تعلقات کی تلاش
ہم منافع کی تقسیم کا خلاصہ کر سکتے ہیں۔
print(df["revenue"].describe())
آپ عددی متغیرات کے درمیان ارتباط کا بھی جائزہ لے سکتے ہیں۔
numeric_columns = [
    "impressions",
    "clicks",
    "conversions",
    "cost",
    "revenue"
]

print(df[numeric_columns].corr())
ارتباط یہ بتاتا ہے کہ دو عددی متغیرات ایک ساتھ کیسے بدلتے ہیں۔ ایک مثبت ارتباط کا مطلب یہ ہے کہ ایک متغیر کی اعلی اقدار دوسرے متغیر کی اعلی اقدار کے ساتھ مل کر واقع ہوتی ہیں۔ منفی ارتباط کا مطلب یہ ہے کہ ایک کی اعلی قدریں دوسرے کی کم اقدار کے ساتھ ملتی ہیں۔
مثال کے طور پر، اشتہاری اخراجات اور آمدنی مثبت طور پر منسلک ہو سکتے ہیں کیونکہ بڑے بجٹ والی مہمات زیادہ آمدنی پیدا کرتی ہیں۔ اس سے یہ ثابت نہیں ہوتا کہ اخراجات میں اضافے سے آمدنی میں اضافہ ہوا۔ مہم کا معیار، سامعین کا سائز، موسمی، مصنوعات کی طلب اور دیگر عوامل کا بھی اثر ہو سکتا ہے۔
EDA کیا بصیرت فراہم کر سکتا ہے؟
EDA شناخت میں مدد کرتا ہے:
- ڈیٹا کے معیار کے مسائل: گمشدہ اقدار، ڈیٹا کی غلط اقسام، ڈپلیکیٹ ریکارڈز، یا قابل اعتراض پیمائش۔
- کارکردگی کے فرق: زیادہ یا کم آمدنی، تبادلوں، یا اخراجات والے چینلز یا مہمات۔
- تقسیم پیٹرن: کیا زیادہ تر آرڈرز کی قدریں ملتی جلتی ہیں، یا کیا کچھ غیر معمولی طور پر بڑے آرڈرز اوسط کو متاثر کرتے ہیں؟
- ممکنہ تعلقات: متغیرات جو ایک ساتھ تبدیل ہوتے ہیں اور مزید تجزیہ کی ضرورت ہوتی ہے۔
- مزید تفتیش کے لیے سوالات: غیر متوقع نتائج جن کے لیے کاروباری سیاق و سباق، تصور، یا شماریاتی جانچ کی ضرورت ہوتی ہے۔
EDA خود بخود وجہ اور اثر قائم نہیں کرتا ہے۔ اس کے بجائے، یہ آپ کو آپ کے ڈیٹا سیٹ کی بہتر تفہیم فراہم کرتا ہے اور یہ فیصلہ کرنے میں آپ کی مدد کرتا ہے کہ آگے کیا تجزیہ کرنا ہے۔
باب 14: کوہورٹ تجزیہ
وقت کے ساتھ تجزیہ کرنے پر گاہک کا رویہ مزید دلچسپ ہو جاتا ہے۔
مشترکہ نقطہ آغاز کی بنیاد پر کوہورٹس گروپ صارفین۔ مثال کے طور پر، آپ اپنے صارفین کو اس مہینے کے حساب سے گروپ کر سکتے ہیں جب انہوں نے پہلی خریداری کی تھی۔
فرض کریں کہ ایک گاہک نے اپنی پہلی خریداری جنوری میں کی تھی اور دوسرے گاہک نے مارچ میں اپنی پہلی خریداری کی تھی۔ ان کا تعلق مختلف حصولی گروہوں سے ہے۔
سب سے پہلے، ہر گاہک کی پہلی خریداری کی شناخت کریں۔
df["purchase_date"] = pd.to_datetime(
    df["purchase_date"]
)

first_purchase = (
    df.groupby("customer_id")[
        "purchase_date"
    ].min()
)
آپ اس معلومات کو ڈیٹا سیٹ سے جوڑ سکتے ہیں۔
df["first_purchase"] = (
    df["customer_id"]
    .map(first_purchase)
)
پھر کوہورٹ مہینے نکالیں۔
df["cohort_month"] = (
    df["first_purchase"]
    .dt.to_period("M")
)
اب آپ حصول کے ادوار میں کسٹمر کے رویے کا موازنہ کر سکتے ہیں۔
کوہورٹ تجزیہ خاص طور پر برقرار رکھنے کی شرح کو سمجھنے کے لیے مفید ہے۔ کمپنیوں کو معلوم ہو سکتا ہے کہ ایک مہم کے ذریعے حاصل کیے گئے گاہک دوسری مہمات کے ذریعے حاصل کیے گئے صارفین کے مقابلے زیادہ دیر تک متحرک رہتے ہیں۔
یہ بصیرت صرف یہ جاننے سے کہیں زیادہ قیمتی ہو سکتی ہے کہ کن مہموں نے سب سے زیادہ ابتدائی تبادلوں کو جنم دیا۔
باب 15: برقرار رکھنے کا تجزیہ
کسٹمر کا حصول مارکیٹنگ کا صرف ایک حصہ ہے۔ گاہکوں کو برقرار رکھنا بھی ضروری ہے۔
فرض کریں کہ ایک کمپنی نے جنوری میں 1,000 صارفین حاصل کیے۔ اگر فروری میں صرف 50 لوگ واپس آتے ہیں، تو آپ کے کاروبار کو برقرار رکھنے کا مسئلہ ہو سکتا ہے۔
آپ واپس آنے والے صارفین کا حساب درج ذیل کر سکتے ہیں:
monthly_customers = (
    df.groupby(
        df["purchase_date"].dt.to_period("M")
    )["customer_id"]
    .nunique()
)
برقرار رکھنے کے مزید تفصیلی تجزیہ کے لیے، آپ کو درست طریقے سے اس بات کی وضاحت کرنے کی ضرورت ہے کہ کون ایک فعال گاہک سمجھا جاتا ہے۔
ایک ای کامرس کمپنی کے لیے، سرگرمی کا مطلب خریداری ہو سکتا ہے۔ SaaS مصنوعات کے لیے، اس کا مطلب لاگ ان ہو سکتا ہے۔ ای میل مہمات کے لیے، اس کا مطلب کھلا یا کلک ہو سکتا ہے۔
تعریف کاروباری ماڈل کے مطابق ہونی چاہیے۔
حصہ IV: مارکیٹنگ کا تصور
ڈیٹا کو منظم اور تجزیہ کرنے کے بعد، اگلا چیلنج مواصلات کا ہے۔
ایک مارکیٹنگ تجزیہ کار کو ڈیٹا سیٹ کی مکمل سمجھ ہو سکتی ہے، لیکن ایک مارکیٹنگ مینیجر ڈیٹا کی 50,000 قطاریں نہیں دیکھنا چاہتا۔
تصور پل فراہم کرتا ہے.
باب 16: مواصلات کے طور پر تصور
ایک تصور کو ایک سوال کا جواب دینا چاہیے۔ مثال کے طور پر:
- کون سے چینلز سب سے زیادہ آمدنی پیدا کرتے ہیں؟ اس صورت میں، ایک بار چارٹ مناسب ہے.
- آپ کی واپسی وقت کے ساتھ کیسے بدلتی ہے؟ ایک لائن چارٹ یہاں معنی رکھتا ہے۔
- کیا اشتہاری اخراجات آمدنی سے منسلک ہیں؟ اس مقصد کے لیے، ایک scatterplot تعلقات کی جانچ پڑتال میں مددگار ثابت ہو سکتا ہے۔
چارٹس یقینی طور پر پیشہ ور نظر آتے ہیں، لیکن یہ واحد مقصد نہیں ہے۔ ہمارا اصل مقصد اہم معلومات کو سمجھنے میں آسان بنانا ہے۔
صحیح چارٹ کا انتخاب کیسے کریں۔
تو آپ کیسے جانتے ہیں کہ کس قسم کا چارٹ استعمال کرنا ہے؟
آپ کو وقت کے ساتھ رجحانات دیکھنے کے لیے لائن چارٹس، زمروں کا موازنہ کرنے کے لیے بار چارٹس، عددی متغیرات کے درمیان تعلقات کو دیکھنے کے لیے سکیٹر پلاٹ، تقسیم دکھانے کے لیے ہسٹوگرام، اور جب درست اقدار اہم ہوں تو جدولوں کا استعمال کرنا چاہیے۔
تصور سوال سے مماثل ہونا چاہیے۔
باب 17: وقت کے ساتھ واپسی
ریٹرن ایک کل کو دیکھنے کے بجائے وقت کے ساتھ تبدیلیوں کی جانچ کرتے وقت مزید معلومات فراہم کرتے ہیں۔ ایک کمپنی ایک مہینے میں اہم آمدنی پیدا کر سکتی ہے لیکن اگلے مہینے میں کمی کا سامنا کرنا پڑتا ہے۔ دیگر کمپنیوں کی کل آمدنی کم ہو سکتی ہے لیکن مسلسل ترقی ہو سکتی ہے۔
وقت کے ساتھ واپسی کا تجزیہ کرنے سے آپ کو رجحانات، بار بار آنے والے موسمی نمونوں، ڈرامائی تبدیلیوں، اور ایسے ادوار کا جائزہ لینے میں مدد ملتی ہے جن پر اضافی توجہ کی ضرورت ہو سکتی ہے۔
آمدنی ظاہر کرنے سے پہلے، یقینی بنائیں کہ آپ کے ڈیٹاسیٹ میں ایک درست تاریخ کا کالم اور ایک عددی محصول کا کالم ہے۔ ذیل کی مثال یہ فرض کرتی ہے کہ آپ کے ڈیٹاسیٹ میں ہے: purchase_date ہر کالم اور ہر قطار ریونیو ایونٹ یا لین دین کی نمائندگی کرتی ہے۔
ماہانہ واپسی کی تیاری
پہلے، تاریخ کے کالم کو تاریخ/وقت کی شکل میں تبدیل کریں۔
import pandas as pd
import matplotlib.pyplot as plt

df["purchase_date"] = pd.to_datetime(
    df["purchase_date"],
    errors="coerce"
)

df = df.dropna(
    subset=["purchase_date", "revenue"]
)
اگلا، ماہ کے لحاظ سے اپنی آمدنی کو گروپ کریں۔
monthly_revenue = (
    df.set_index("purchase_date")["revenue"]
    .resample("MS")
    .sum()
)
کہ "MS" فریکوئینسی ڈیٹا کو مہینے کے لحاظ سے گروپ کرتا ہے، جس میں ہر پیریڈ کو مہینے کے آغاز کے ساتھ لیبل کیا جاتا ہے۔ کہ sum() یہ کام ماہانہ آمدنی کی قدروں میں اضافہ کرتا ہے۔
یہ حساب فرض کرتا ہے کہ ہر قطار آمدنی کی اس رقم کی نمائندگی کرتی ہے جسے شامل کرنا ضروری ہے۔ اگر آپ کے ڈیٹاسیٹ میں پہلے سے ہی ماہانہ آمدنی کا مجموعہ شامل ہے، تو ڈھانچے کو چیک کیے بغیر اعادی ماہانہ ٹوٹل کو شامل نہ کریں۔ ایسا کرنے کے نتیجے میں آپ کے منافع کو دوگنا شمار کیا جا سکتا ہے۔
رجحان کا تصور
monthly_revenue.plot(
    kind="line",
    marker="o"
)

plt.title("Illustrative Monthly Marketing Revenue")
plt.xlabel("Month")
plt.ylabel("Revenue ($)")
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
لائن چارٹس وقت کے ساتھ تبدیلیاں دیکھنا آسان بناتے ہیں۔ افقی محور وقت کی نمائندگی کرتا ہے، اور عمودی محور منافع کی نمائندگی کرتا ہے۔ ہر ڈاٹ ایک مہینے کی کل آمدنی کی نمائندگی کرتا ہے، اور منسلک لائنیں مجموعی پیٹرن کی پیروی کرنا آسان بناتی ہیں۔
سیکھنے کے مقاصد کے لیے ڈیٹا کی مثال
چارٹ کی تشریح
جب آپ گراف کا جائزہ لیں تو اپنے آپ سے درج ذیل سوالات پوچھیں:
- کیا محصولات عام طور پر بڑھتے ہیں، کم ہوتے ہیں یا مستحکم رہتے ہیں؟
- کیا اچانک اضافہ یا کمی ہے؟
- کیا ہر سال ایک ہی موسم میں ایسی ہی تبدیلیاں آتی ہیں؟
- کیا مہم کا آغاز، قیمت میں تبدیلی، پروموشن، یا پروڈکٹ لانچ تبدیلی کی وضاحت میں مدد کر سکتا ہے؟
- کیا ادوار کا موازنہ مکمل اور مستقل طور پر کیا جا رہا ہے؟
بڑھتی ہوئی لکیر کا خود بخود مطلب یہ نہیں ہے کہ آپ کی مارکیٹنگ مہم کی آمدنی میں اضافہ ہوا ہے۔ دیگر عوامل جیسے موسم، قیمت، مصنوعات کی دستیابی، اور گاہک کی مانگ میں تبدیلی کا بھی اثر ہو سکتا ہے۔
اگر آپ کے ڈیٹاسیٹ میں صرف چند ماہ شامل ہیں، تو ہو سکتا ہے کہ آپ کے پاس قابل اعتماد موسمی نمونوں کی شناخت کے لیے کافی ریکارڈ نہ ہوں۔ سوالات کی شناخت کے لیے چارٹس کا استعمال کریں، پھر نمونوں کا موازنہ مہم کی سرگرمیوں اور دیگر کاروباری معلومات سے کریں۔
تو یاد رکھیں، وقت کے ساتھ منافع کا چارٹ کارکردگی میں تبدیلیوں کو ظاہر کرتا ہے، جو آپ کو رجحانات کی جانچ پڑتال کرنے اور یہ سمجھنے کے لیے ایک نقطہ آغاز فراہم کرتا ہے کہ ان کی وجہ کیا ہے۔
باب 18: چینل کا موازنہ
مارکیٹنگ ٹیمیں اکثر بیک وقت متعدد چینلز استعمال کرتی ہیں۔ ای میل، تلاش کے اشتہارات، سوشل میڈیا، اور ڈسپلے اشتہارات ہر ایک آپ کی آمدنی میں حصہ ڈال سکتے ہیں، لیکن ان کی کارکردگی پہنچ، تبادلوں کی شرح اور لاگت کے لحاظ سے مختلف ہو سکتی ہے۔
چینل کا موازنہ آپ کو سوالات کے جوابات دینے میں مدد کرتا ہے جیسے:
- کون سے چینلز سب سے زیادہ آمدنی پیدا کرتے ہیں؟
- کون سے چینلز سب سے زیادہ تبدیلیاں پیدا کرتے ہیں؟
- کون سے چینلز آپ کے اشتہاری بجٹ کو زیادہ مؤثر طریقے سے استعمال کرتے ہیں؟
- کیا اعلیٰ رسائی والے چینلز بھی معنی خیز نتائج پیدا کر رہے ہیں؟
تصورات ان موازنہ کو سمجھنے میں آسان بنا سکتے ہیں، خاص طور پر اگر آپ کی رپورٹ میں متعدد چینلز شامل ہوں۔
چینل کے لحاظ سے آمدنی کا موازنہ
اپنی آمدنی کو چینل کے لحاظ سے گروپ کر کے شروع کریں۔
channel_revenue = (
    df.groupby("channel")["revenue"]
    .sum()
    .sort_values(ascending=False)
)
پھر بار چارٹ بنائیں۔
import matplotlib.pyplot as plt

channel_revenue.plot(
    kind="bar"
)

plt.title("Illustrative Revenue by Marketing Channel")
plt.xlabel("Marketing Channel")
plt.ylabel("Revenue ($)")
plt.xticks(rotation=45, ha="right")
plt.tight_layout()
plt.show()
ہر بار ایک چینل سے وابستہ کل آمدنی کی نمائندگی کرتا ہے۔ اقدار کو اعلیٰ سے کم تک چھانٹنا یہ شناخت کرنا آسان بناتا ہے کہ آپ کے ڈیٹا سیٹ میں کون سے چینلز سب سے زیادہ آمدنی پیدا کر رہے ہیں۔

سیکھنے کے مقاصد کے لیے ڈیٹا کی مثال
چینل کے لحاظ سے تبادلوں کا موازنہ
آمدنی پوری کہانی نہیں بتاتی۔ آپ کے کاروباری اہداف پر منحصر ہے، ایک چینل کم آمدنی پیدا کر سکتا ہے لیکن زیادہ تعداد میں سائن اپ، لیڈز یا خریداریاں پیدا کر سکتا ہے۔
channel_conversions = (
    df.groupby("channel")["conversions"]
    .sum()
    .sort_values(ascending=False)
)

channel_conversions.plot(
    kind="bar"
)

plt.title("Illustrative Conversions by Marketing Channel")
plt.xlabel("Marketing Channel")
plt.ylabel("Conversions")
plt.xticks(rotation=45, ha="right")
plt.tight_layout()
plt.show()
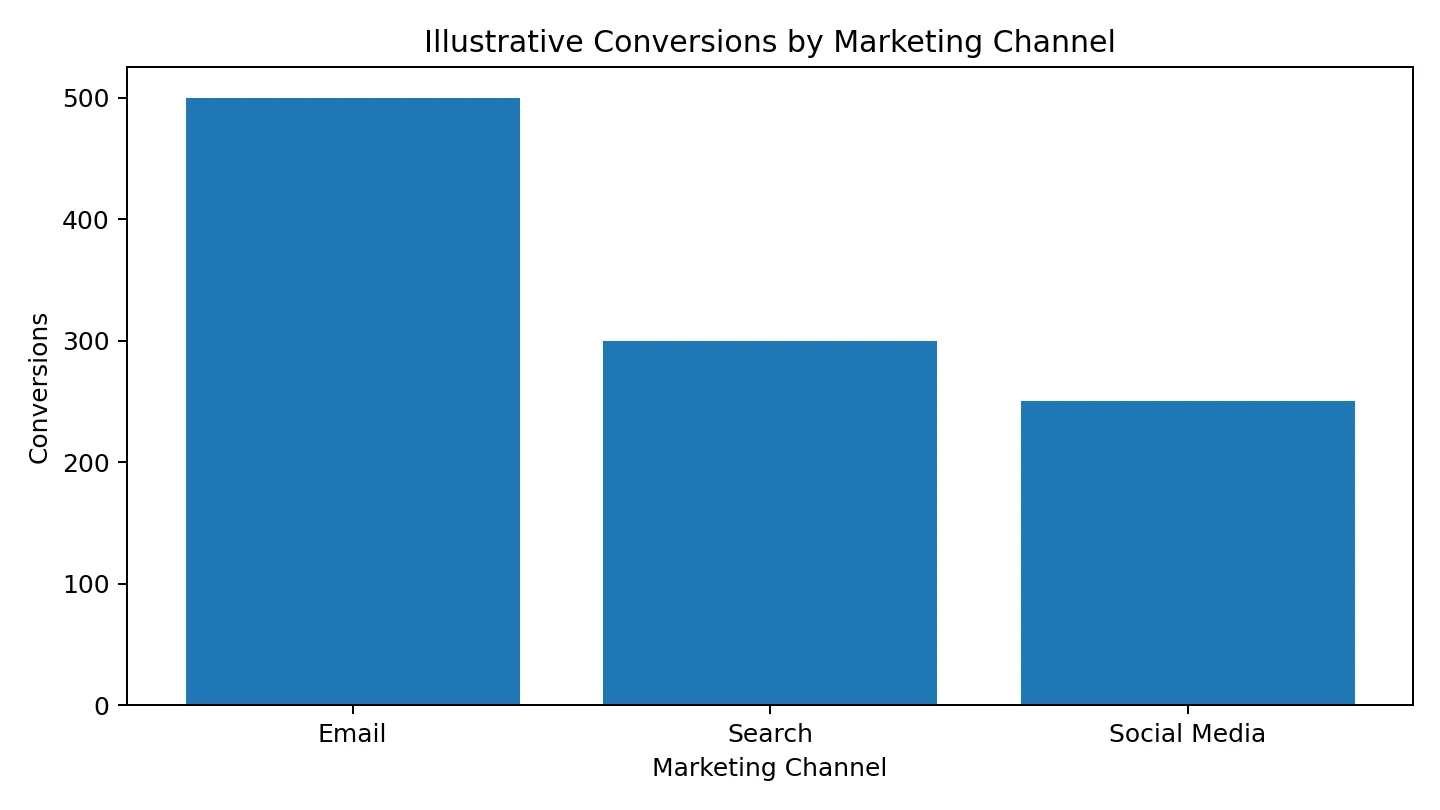
سیکھنے کے مقاصد کے لیے ڈیٹا کی مثال
پہلا چارٹ آمدنی کے سائز کا موازنہ کرتا ہے، اور دوسرا چارٹ تبادلوں کے سائز کا موازنہ کرتا ہے۔ ایک ساتھ استعمال کیا جاتا ہے، وہ اکیلے چارٹ سے زیادہ سیاق و سباق فراہم کرتے ہیں۔
ایک میٹرک کیوں کافی نہیں ہے۔
مندرجہ ذیل نتائج کا تصور کریں:
| چینل | آمدنی | تبدیلی | اشتہاری لاگت |
|---|---|---|---|
| ای میل | $50,000 | 1,000 | $40,000 |
| تلاش کریں | $45,000 | 300 | $5,000 |
ای میل زیادہ آمدنی اور زیادہ تبادلوں کو پیدا کرتا ہے۔ تاہم، تلاش اشتہارات پر صرف $5,000 کی آمدنی میں $45,000 پیدا کرتی ہے، جب کہ ای میل $50,000 آمدنی میں $40,000 کی لاگت آتی ہے۔
ROAS کی قدریں ہیں:
- ای میل: $50,000 ¼ $40,000 = 1.25
- تلاش کریں: $45,000 ¼ $5,000 = 9.00
اگرچہ ای میل زیادہ کل آمدنی پیدا کرتی ہے، لیکن اس مثال میں تلاش کا ROAS زیادہ ہے۔ یاد رکھیں کہ ROAS آپ کے اشتھاراتی اخراجات کے حوالے سے منسوب آمدنی کی پیمائش کرتا ہے۔ یہ منافع کے برابر نہیں ہے۔
یہ نمبر بتاتے ہیں کہ آپ کو سب سے زیادہ ریونیو بار والے چینل کو خودکار طور پر منتخب کرنے کے بجائے متعلقہ میٹرکس کا موازنہ کیوں کرنا چاہیے۔
باب 19: سکیٹر پلاٹس
فرض کریں کہ آپ یہ جاننا چاہتے ہیں کہ آیا آپ کے اشتھاراتی اخراجات اور آمدنی کا تعلق ہے۔
plt.scatter(
    df["cost"],
    df["revenue"]
)

plt.title(
    "Advertising Cost vs Revenue"
)

plt.xlabel("Advertising Cost")
plt.ylabel("Revenue")

plt.tight_layout()
plt.show()
نتیجے کے پیٹرن آپ کو تعلقات کی تحقیقات میں مدد کرسکتے ہیں.
لیکن فوری طور پر اس نتیجے پر نہ پہنچیں کہ زیادہ خرچ کرنے سے منافع میں اضافہ ہوگا۔
تعلقات اس سے متاثر ہوسکتے ہیں:
- مہم کا معیار
- سامعین کا سائز
- موسمی
- مصنوعات کی طلب
- برانڈ بیداری
- موجودہ کسٹمر کا رویہ
- دیگر مارکیٹنگ چینلز
تصورات آپ کو بہتر سوالات پوچھنے میں مدد کرتے ہیں، لیکن وہ ڈیٹا کے حقیقی تجزیے کی جگہ نہیں لیتے۔
باب 20: تقسیم کا تجزیہ
تقسیم کا تجزیہ اس بات کی جانچ کرتا ہے کہ ڈیٹاسیٹ میں اقدار کو کس طرح تقسیم کیا جاتا ہے۔ صرف کل یا اوسط پر توجہ مرکوز کرنے کے بجائے، یہ آپ کو یہ سمجھنے میں مدد کرتا ہے کہ کون سی قدریں کثرت سے ہوتی ہیں، ان میں کتنا تغیر ہوتا ہے، اور کیا غیر معمولی طور پر زیادہ یا کم مشاہدات کی ایک چھوٹی تعداد نتائج کو متاثر کرتی ہے۔
مارکیٹنگ میں، تقسیم کا تجزیہ آپ کو کسٹمر آرڈر کی قیمت، مہم کے اخراجات، ویب سائٹ سیشن، تبادلوں کی شرح، اور دیگر عددی پیمائشوں کو سمجھنے میں مدد کر سکتا ہے۔
یہ صرف پرانی اقدار کا تجزیہ کرنے سے مختلف ہے۔ تاریخی تجزیہ وقت کے ساتھ پیمائش کا موازنہ کرتا ہے، جب کہ تقسیمی تجزیہ ڈیٹا سیٹ یا منتخب مدت کے اندر اقدار کی تقسیم اور تعدد کا جائزہ لیتا ہے۔ دونوں طریقوں کو ایک ساتھ استعمال کیا جا سکتا ہے، لیکن وہ مختلف سوالات کے جوابات دیتے ہیں۔
مثال کے طور پر، تاریخی تجزیہ پوچھتا ہے کہ آیا آرڈر کی اوسط قدر ایک مہینے سے اگلے مہینے تک بڑھتی ہے۔ تقسیم کا تجزیہ پوچھتا ہے کہ آیا زیادہ تر آرڈرز کی قدریں ملتی جلتی ہیں، یا کیا کچھ غیر معمولی طور پر بڑے آرڈرز اوسط کو اوپر کی طرف دھکیلتے ہیں۔
آرڈر ویلیو سروے
ڈیٹاسیٹ میں order_value گرمی اپنے خلاصہ کے اعدادوشمار کا جائزہ لے کر شروع کریں۔
print(df["order_value"].describe())
آؤٹ پٹ میں شمار، اوسط، معیاری انحراف، کم از کم، چوتھائی، اور زیادہ سے زیادہ شامل ہیں۔
کہ اوسط یہ ریاضی کا مطلب ہے۔ آرڈر کی تمام قدریں شامل کریں اور آرڈرز کی تعداد سے تقسیم کریں۔ کہ درمیانی آرڈرز کو چھانٹتے وقت یہ درمیانی قدر ہے۔ میڈین چند بہت بڑی خریداریوں سے کم متاثر ہوتا ہے۔
مثال کے طور پر، مندرجہ ذیل پانچ ترتیب اقدار پر غور کریں:
$20, $25, $30, $35, $390
اوسط $100 ہے، لیکن اوسط $30 ہے۔ اگرچہ پانچ میں سے چار آرڈرز $40 سے کم تھے، $390 کی خریداری نے اوسط کو نمایاں طور پر بڑھا دیا۔
یہی وجہ ہے کہ اوسط ہمیشہ ایک عام صارف کے آرڈرز کو خاص طور پر اچھی طرح سے بیان نہیں کرتے ہیں۔ اگر آرڈینل اقدار بہت زیادہ ترچھی ہیں، تو میڈین اور تقسیم خود ایک زیادہ نمائندہ تصویر فراہم کر سکتی ہے۔
تقسیم کا تصور
ایک ہسٹوگرام عددی اقدار کو رینجز میں گروپ کرتا ہے جسے bins کہتے ہیں اور دکھاتا ہے کہ ہر رینج میں کتنے مشاہدات آتے ہیں۔
import pandas as pd
import matplotlib.pyplot as plt

df = pd.DataFrame({
    "order_id": range(1, 11),
    "order_value": [20, 25, 30, 35, 390, 28, 32, 40, 45, 50]
})

plt.figure(figsize=(9, 5))

plt.hist(
    df["order_value"],
    bins=8,
    edgecolor="black"
)

plt.title("Illustrative Distribution of Customer Order Values")
plt.xlabel("Order Value ($)")
plt.ylabel("Number of Orders")
plt.grid(axis="y", alpha=0.3)
plt.tight_layout()
plt.show()
ہر بار ہجے کی قدروں کی ایک حد کی نمائندگی کرتا ہے، اور اس کی اونچائی اس حد کے اندر آنے والے منتروں کی تعداد کی نمائندگی کرتی ہے۔

ایک ہسٹوگرام اس بات کی نشاندہی کر سکتا ہے کہ آیا زیادہ تر آرڈرز ایک خاص رینج میں مرکوز ہیں، آیا تقسیم میں زیادہ قیمت والی خریداریوں کی لمبی دم ہے، یا آیا متعدد آرڈر ویلیو گروپس موجود ہیں۔
مجھے کیا تلاش کرنا چاہئے؟
تقسیم کی تشریح کرتے وقت، درج ذیل پر غور کریں:
- مرکز: اقدار کہاں گرتی ہیں؟ وسط اور میڈین سینٹرائڈز کو بیان کرنے میں مدد کر سکتے ہیں۔
- بازی: اقدار کتنی متنوع ہیں؟ ایک وسیع تقسیم مضبوطی سے بھری تقسیم سے زیادہ تغیرات کی نمائش کرتی ہے۔
- ترچھا: کیا اقدار ایک سرے پر مرکوز ہیں اور دوسرے سرے پر لمبی دم ہے؟
- باہر والے: کیا کچھ اقدار غیر معمولی طور پر باقیوں سے دور ہیں؟
- متعدد گروپس: کیا تقسیم مختلف قسم کے صارفین یا لین دین کا مشورہ دیتی ہے؟
غیر معمولی اقدار ضروری نہیں کہ غلطیاں ہوں۔ بہت بڑے آرڈرز ہمارے قابل قدر گاہکوں سے جائز خریداری ہو سکتے ہیں۔ کسی بھی چیز کو ہٹانے یا تبدیل کرنے سے پہلے ذریعہ اور کاروباری سیاق و سباق کو چیک کریں۔
تقسیم کا تجزیہ کیوں ضروری ہے۔
فرض کریں کہ آپ کے آرڈر کی اوسط قدر کسی خاص مہینے میں نمایاں طور پر بڑھ جاتی ہے۔ اگر آپ صرف اوسط کو دیکھیں تو آپ اندازہ لگا سکتے ہیں کہ گاہک عام طور پر زیادہ خرچ کرنا شروع کر رہے ہیں۔ تاہم، جب کہ زیادہ تر گاہک ایک ہی رقم خرچ کرتے رہتے ہیں، غیر معمولی طور پر بڑی خریداریوں کی ایک چھوٹی تعداد میں اضافہ کا سبب بن سکتا ہے۔
ذرائع، میڈین، ہسٹوگرام، اور تاریخی رجحانات کا موازنہ کرنے سے ان امکانات کے درمیان فرق کرنے میں مدد مل سکتی ہے۔
اہم سبق یہ ہے کہ تقسیمی تجزیہ ہمیں یہ سمجھنے میں مدد کرتا ہے کہ عام کیا ہے، قدریں کتنی بدلتی ہیں، اور کیا انتہائی مشاہدات اس بات کو متاثر کرتے ہیں جو خلاصہ کے اعدادوشمار کے ذریعے پہنچایا جاتا ہے۔
حصہ V: گاہک اور مہم کا تجزیہ
مارکیٹنگ کے تجزیات اس وقت زیادہ دلچسپ ہو جاتے ہیں جب آپ یہ پوچھنا چھوڑ دیتے ہیں، "ہماری مہم کی کارکردگی کیسی رہی؟" پوچھنا شروع کریں، "کس نے جواب دیا، انہوں نے کیوں جواب دیا، اور ہمیں آگے کیا کرنا چاہیے؟"
باب 21: گاہک کی تقسیم
کسٹمر سیگمنٹیشن مشترکہ خصوصیات یا طرز عمل کی بنیاد پر صارفین کو گروپس میں تقسیم کرنے کا عمل ہے۔ تمام صارفین کے ساتھ یکساں سلوک کرنے کے بجائے، کمپنیاں ایسے گروپوں کی نشاندہی کر سکتی ہیں جو مارکیٹنگ مہمات کے لیے مختلف طریقے سے جواب دے سکتے ہیں۔
مثال کے طور پر، کچھ صارفین کثرت سے خریداری کرتے ہیں، کچھ صرف ایک بار خریدتے ہیں، اور دوسروں نے مہینوں میں خریداری نہیں کی ہے۔ کاروبار وفادار گاہکوں کو انعام دینا چاہتے ہیں، ایک بار خریداروں کو واپس آنے کی ترغیب دینا چاہتے ہیں، یا غیر فعال گاہکوں کے ساتھ دوبارہ رابطہ قائم کرنا چاہتے ہیں۔
سیگمنٹیشن مارکیٹرز کو مختلف کسٹمر گروپس کے لیے مزید متعلقہ حکمت عملی تیار کرنے میں مدد کرتی ہے۔ یہ خود بخود آپ کو نہیں بتاتا کہ ہر گاہک کیا چاہتا ہے، لیکن یہ کسٹمر کے رویے کے نمونوں کو سمجھنے کا ایک منظم طریقہ فراہم کرتا ہے۔
آر ایف ایم تجزیہ
ایک عام نقطہ نظر تین پیمائشوں کا استعمال کرتے ہوئے RFM تجزیہ ہے۔
- حالیہ: گاہک کو خریداری کرتے ہوئے کتنا عرصہ گزر چکا ہے؟
- تعدد: تجزیہ کی مدت کے دوران کسٹمر نے کتنی خریداریاں کیں؟
- مالیاتی قدر: اس مدت کے دوران کسٹمر نے کتنا خرچ کیا؟
یہ پیمائشیں کسٹمر کی سرگرمیوں پر ایک مختلف نقطہ نظر فراہم کرتی ہیں۔ حالیہ دنوں کی کم تعداد والے صارفین نے حال ہی میں خریداری کی ہے، جبکہ حالیہ دنوں کی زیادہ تعداد والے صارفین نے طویل عرصے میں خریداری نہیں کی ہے۔ زیادہ تعدد کا مطلب ہے زیادہ خریداریاں، اور زیادہ مالیاتی قدر کا مطلب ہے زیادہ ریکارڈ شدہ اخراجات۔
فرض کریں کہ آپ کے ڈیٹا سیٹ پر مشتمل ہے: customer_id, purchase_dateاور order_value. سب سے پہلے، خریداری کی تاریخ کو تاریخ/وقت کی قدر میں تبدیل کریں۔
df["purchase_date"] = pd.to_datetime(
    df["purchase_date"],
    errors="coerce"
)
تجزیہ کی تاریخ منتخب کریں اور ہر صارف کی آخری خریداری، خریداری کی فریکوئنسی، اور کل ریکارڈ شدہ اخراجات کا حساب لگائیں۔
analysis_date = pd.Timestamp("2026-09-05")

customer_rfm = (
    df.groupby("customer_id")
    .agg(
        last_purchase=("purchase_date", "max"),
        frequency=("purchase_date", "count"),
        monetary=("order_value", "sum")
    )
)

customer_rfm["recency"] = (
    analysis_date - customer_rfm["last_purchase"]
).dt.days

customer_rfm = customer_rfm[
    ["recency", "frequency", "monetary"]
]

print(customer_rfm)
اس مثال میں، ہر قطار ایک خریداری کی نمائندگی کرتی ہے۔ order_value اس خریداری کی قیمت شامل ہے۔ اگر آپ کے ڈیٹا میں فی آرڈر متعدد قطاریں ہیں، تو آرڈرز کو صحیح طریقے سے شمار کرنے کے لیے منفرد آرڈر شناخت کنندگان کا استعمال کریں۔ ایک تجزیہ کی تاریخ منتخب کریں جو رپورٹنگ کی مدت سے مماثل ہو جس کا آپ مطالعہ کر رہے ہیں۔
RFM ٹیبل کو سمجھنا
مندرجہ ذیل مثال کے جدول سے پتہ چلتا ہے کہ RFM کا خلاصہ کیسا لگتا ہے۔
| کسٹمر ID | حالیہ (دن) | تعدد (آرڈر) | مانیٹری قدر |
|---|---|---|---|
| C001 | 8 | 12 | $960 |
| C002 | 75 | 4 | $240 |
| C003 | 180 | 1 | $45 |
| C004 | 20 | 7 | $525 |
یہ سیکھنے کے مقاصد کے لیے مثالی اقدار ہیں۔
اس مثال میں، کسٹمر C001، جس نے حال ہی میں خریداری کی، سب سے زیادہ آرڈرز دیے اور سب سے زیادہ رقم خرچ کی۔ کسٹمر C003 نے طویل عرصے سے کوئی خریداری نہیں کی ہے، صرف ایک آرڈر دیا ہے، اور سب سے کم خرچ کی تاریخ ہے۔
یہ اختلافات مارکیٹنگ کے مختلف طریقوں کا مشورہ دے سکتے ہیں۔ کاروبار دہرائے جانے والے صارفین کے لیے وفاداری کی پیشکش، ایک بار خریداروں کے لیے فالو اپ پیشکش، یا غیر فعال صارفین کے لیے دوبارہ مشغولیت کی مہمات پر غور کر سکتے ہیں۔
تاہم، RFM اقدار کی سیاق و سباق میں تشریح کی جانی چاہیے۔ ان مصنوعات کے لیے جو سال میں صرف ایک بار خریدتے ہیں، شاذ و نادر گاہک بالکل نارمل ہو سکتے ہیں۔ مشاہدے کی مدت کی لمبائی بھی اہم ہے۔ اس کی وجہ یہ ہے کہ جو گاہک 2 مہینوں سے فعال ہیں ان کے پاس خریداری جمع کرنے کے لیے ان صارفین کے مقابلے میں کم وقت ہوتا ہے جو 2 سال سے فعال ہیں۔
باب 22: کسٹمر لائف ٹائم ویلیو
کسٹمر لائف ٹائم ویلیو اس قدر کا اندازہ لگاتا ہے جو آپ کے گاہک آپ کے کاروبار کے ساتھ اپنے تعلقات کے ذریعے تخلیق کرتے ہیں۔
ایک سادہ تاریخی پیمانہ یہ ہے:
customer_ltv = (
    df.groupby("customer_id")[
        "order_value"
    ].sum()
)
یہ آپ کو بتاتا ہے کہ ہر صارف نے ماضی میں کتنا خرچ کیا ہے۔
مزید نفیس ماڈل مستقبل کی قدروں کا اندازہ لگا سکتے ہیں۔
مثال کے طور پر، ایک تصوراتی لائف ٹائم ویلیو فارمولہ غور کر سکتا ہے:
Average Order Value
× Purchase Frequency
× Expected Customer Lifespan
تاہم، زندگی بھر کی اصل قیمت کا حساب لگانا بہت زیادہ پیچیدہ ہو سکتا ہے۔
انہیں غور کرنے کی ضرورت ہوسکتی ہے:
- مجموعی منافع
- قبضہ
- منڈلانا
- رعایت
- حصول کی لاگت
- پروڈکٹ کیٹیگری
- کسٹمر کے رویے
اہم سبق یہ ہے کہ LTV ایک تخمینہ ہے، غیر متنازعہ سچائی نہیں۔
باب 23 گاہک کے حصول کے اخراجات
کسٹمر ایکوزیشن کاسٹ (CAC) اندازہ لگاتا ہے کہ گاہک کو حاصل کرنے میں کتنا خرچ آتا ہے۔
سادہ فارمولا ہے:
cac = total_marketing_cost / new_customers
فرض کریں:
marketing_cost = 20000
new_customers = 400

cac = marketing_cost / new_customers

print(cac)
نتائج درج ذیل ہیں:
50.0
اس کا مطلب ہے کہ حصول کی اوسط لاگت $50 فی گاہک تھی۔
CAC کا کسٹمر ویلیو سے موازنہ کرنے سے یہ تعین کرنے میں مدد مل سکتی ہے کہ آیا کوئی حصول معاشی طور پر پائیدار ہے۔
CAC اور LTV ایک ساتھ استعمال کرنا
فرض کریں:
CAC = $50
LTV = $300
ممکنہ طور پر صحت مند لگتا ہے۔
اب فرض کرتے ہیں:
CAC = $250
LTV = $180
ایک کاروبار ایک گاہک کو اس کی قیمت سے زیادہ میں حاصل کر سکتا ہے۔
ان اشاریوں کو اب بھی احتیاط سے تشریح کرنے کی ضرورت ہے۔ LTV کا اندازہ لگایا جا سکتا ہے، اور CAC چینل سے دوسرے چینل میں نمایاں طور پر مختلف ہو سکتا ہے۔
حصول کے کچھ اخراجات کو سادہ حساب سے خارج کیا جا سکتا ہے۔ لیکن وہ مل کر مارکیٹنگ اکنامکس کے بارے میں سوچنے کے لیے ایک مفید فریم ورک فراہم کرتے ہیں۔
باب 24: فینل تجزیہ
ایک مارکیٹنگ فنل ان مراحل کی نمائندگی کرتا ہے جن سے ایک صارف مطلوبہ کارروائی مکمل کرنے سے پہلے گزرتا ہے، جیسے خریداری کرنا، سروس کے لیے سائن اپ کرنا، یا لیڈ فارم جمع کروانا۔
ایک عام آن لائن شاپنگ فنل میں شامل ہوسکتا ہے:
- ویب سائٹ ملاحظہ کریں
- مصنوعات دیکھیں
- کارٹ میں پروڈکٹ شامل کریں۔
- ادائیگی شروع ہو رہی ہے۔
- خریداری مکمل ہو گئی۔
ہر مرحلے پر، کچھ لوگ جاری رہتے ہیں اور دوسرے چلے جاتے ہیں۔ فنل کا تجزیہ پیمائش کرتا ہے کہ کتنے لوگ ایک مرحلے سے دوسرے مرحلے تک ترقی کرتے ہیں اور یہ شناخت کرنے میں مدد کرتا ہے کہ مزید تفتیش کہاں مفید ہو سکتی ہے۔
مرحلہ وار تبادلوں کی شرح کا حساب کتاب
فرض کریں کہ آپ کی ویب سائٹ اسی رپورٹنگ مدت کے لیے درج ذیل نمبروں کو ریکارڈ کرتی ہے:
visitors = 50000
product_views = 30000
cart_adds = 8000
checkouts = 4000
purchases = 2500
کوئی راستہ نہیں مرحلہ تبادلوں کی شرح ان لوگوں کا فیصد جو ایک سطح پر پہنچتے ہیں اور پھر اگلے درجے پر جاتے ہیں۔
مرحلہ کی تبدیلی کی شرح = اگلے مراحل کی تعداد پہنچ گئی ¼ پچھلے مراحل کی تعداد × 100 تک پہنچ گئی
مثال کے طور پر، پروڈکٹ ویو ریٹ کا حساب پروڈکٹ کے ملاحظات کی تعداد کو زائرین کی تعداد سے تقسیم کر کے لگایا جاتا ہے۔
product_view_rate = (
    product_views / visitors * 100
)

cart_rate = (
    cart_adds / product_views * 100
)

checkout_rate = (
    checkouts / cart_adds * 100
)

purchase_rate = (
    purchases / checkouts * 100
)

print(f"Visitor to product view: {product_view_rate:.1f}%")
print(f"Product view to cart: {cart_rate:.1f}%")
print(f"Cart to checkout: {checkout_rate:.1f}%")
print(f"Checkout to purchase: {purchase_rate:.1f}%")
ان مثالی اقدار کے ساتھ، 60% زائرین کسی پروڈکٹ کو دیکھتے ہیں، تقریباً 26.7% پروڈکٹ دیکھنے والے اپنی کارٹ میں آئٹمز شامل کرتے ہیں، 50% کارٹ میں اضافے کا نتیجہ چیک آؤٹ ہوتا ہے، اور 62.5% چیک آؤٹ کے نتیجے میں خریداری ہوتی ہے۔
ہر فیصد ایک مخصوص تبدیلی کو بیان کرتا ہے۔ ان مرحلہ وار تبادلوں کی شرح کو مجموعی خریداری کی شرحوں کے ساتھ الجھائیں، جو زائرین سے براہ راست خریداریوں کا موازنہ کرتی ہیں۔
یہ حسابات یہ بھی فرض کرتے ہیں کہ قدموں کی تعداد کو مستقل طور پر بیان کیا جاتا ہے اور اسی رپورٹنگ کی مدت میں موازنہ کرنے والے صارفین یا سیشنز کا حوالہ دیتے ہیں۔ اگر آپ کے نمبر مختلف آبادیوں کی نمائندگی کرتے ہیں یا ٹریکنگ کے مختلف اصول استعمال کرتے ہیں، تو ہو سکتا ہے کہ آپ کے نرخ درست طریقے سے کسٹمر کی ترقی کو بیان نہ کریں۔
کسٹمر کے تجربے کی تحقیق
کم مرحلے کی تبدیلی کی شرح آپ کو بتاتی ہے کہ لوگ کہاں چھوڑ رہے ہیں، لیکن وہ یہ نہیں بتاتے کہ وہ کیوں چھوڑ رہے ہیں۔ اگلا مرحلہ اس مرحلے پر کسٹمر کے تجربے کی تحقیق کرنا ہے۔
مثال کے طور پر، اگر آپ کے بہت سے گاہک ادائیگیاں ترک کر رہے ہیں، تو آپ جن مسائل کی چھان بین کرنا چاہتے ہیں ان میں شامل ہیں:
- غیر متوقع شپنگ کے اخراجات یا ٹیکس
- ادائیگی کے عمل کو بہت زیادہ مراحل کی ضرورت ہے۔
- وہ فارم جو موبائل آلات پر پُر کرنا مشکل ہیں۔
- محدود ادائیگی کے اختیارات
- صفحہ آہستہ لوڈ ہوتا ہے یا تکنیکی خرابیوں کا سامنا کرنا پڑتا ہے۔
- مبہم شپنگ یا واپسی کی معلومات
- اشتہار اور لینڈنگ پیج کے درمیان تضاد
آپ اینالیٹکس ایونٹس، ڈیوائس لیول کے موازنہ، کسٹمر سپورٹ فیڈ بیک، قابل استعمال ٹیسٹنگ، اور ایرر لاگز کا استعمال کرکے ان امکانات کی چھان بین کر سکتے ہیں۔ یہ ذرائع ممکنہ وضاحتوں کی نشاندہی کرنے میں مدد کرتے ہیں بجائے اس کے کہ یہ فرض کر لیں کہ فنل کی رفتار خود اس کی وجہ ثابت کرتی ہے۔
اگر آپ کے پاس اس بات کا ثبوت ہے کہ ادائیگی میں تبدیلی سے مدد مل سکتی ہے، تو آپ ادائیگی کے بہاؤ کی جانچ کر سکتے ہیں تاکہ اسے آسان بنایا جا سکے یا اپنی قیمتوں کی معلومات کو واضح کیا جا سکے۔ یہ فنل تجزیہ کو A/B ٹیسٹنگ سے جوڑتا ہے۔ فنل کا تجزیہ آپ کو یہ شناخت کرنے میں مدد کر سکتا ہے کہ کہاں چھان بین کرنی ہے، اور تجربات آپ کو یہ اندازہ کرنے میں مدد کر سکتے ہیں کہ آیا مجوزہ تبدیلیاں نتائج کو بہتر بنائیں گی۔
فنل تجزیہ آپ کو دکھاتا ہے کہ آپ کے گاہک کہاں ترقی کرنا چھوڑ دیتے ہیں۔ گاہک کے تجربات کی تحقیق کرنے سے آپ کو بیانیہ تیار کرنے اور یہ فیصلہ کرنے میں مدد ملے گی کہ کون سی تبدیلیاں جانچ کے قابل ہیں۔
باب 25: A/B ٹیسٹنگ
A/B ٹیسٹنگ ایک کنٹرول شدہ تجربہ ہے جو مارکیٹنگ کے تجربے کے دو ورژن کا موازنہ کرنے کے لیے استعمال ہوتا ہے۔ کاروبار دو لینڈنگ پیجز، ای میل سبجیکٹ لائنز، اشتہارات، چیک آؤٹ ڈیزائنز، یا کال ٹو ایکشن کا موازنہ کر سکتے ہیں تاکہ یہ معلوم کیا جا سکے کہ کون سا ورژن متعین اہداف کے لیے بہتر کارکردگی کا مظاہرہ کرتا ہے۔
ورژن A کنٹرول یا میراثی ورژن ہے، اور ورژن B متبادل ورژن ہے جس کی جانچ کی جا رہی ہے۔ مثالی طور پر، اہل صارفین کو تصادفی طور پر ایک ورژن کے لیے تفویض کیا جائے گا، جس سے اس امکان کو کم کیا جائے گا کہ گروپوں کے درمیان فرق موازنہ کو بگاڑ دے گا۔
تبادلوں کی شرح کا حساب کتاب
فرض کریں کہ آپ دو لینڈنگ صفحات کی جانچ کر رہے ہیں اور پیمائش کر رہے ہیں کہ آیا ملاحظہ کار مطلوبہ کارروائی مکمل کرتے ہیں۔
visitors_a = 5000
conversions_a = 240

visitors_b = 5000
conversions_b = 290
ہر تبادلوں کی شرح کا حساب لگائیں۔
rate_a = (
    conversions_a / visitors_a
)

rate_b = (
    conversions_b / visitors_b
)

print(f"Version A: {rate_a:.2%}")
print(f"Version B: {rate_b:.2%}")
اس مثال میں، ورژن A کی تبادلوں کی شرح 4.8% ہے، اور ورژن B کی تبادلوں کی شرح 5.8% ہے۔ مشاہدہ کیا گیا فرق 1 فیصد پوائنٹ ہے۔
تاہم، مشاہدہ اختلافات یہ خود بخود ثابت نہیں ہوتا ہے کہ ورژن B اصل میں بہتر ہے۔. یہاں تک کہ اگر وسیع تر آبادی میں دو ورژن یکساں کارکردگی کا مظاہرہ کرتے ہیں، بے ترتیب موقع نتائج میں فرق کا سبب بن سکتا ہے۔
شماریاتی غیر یقینی صورتحال کو سمجھنا
A/B ٹیسٹنگ زائرین کے ایک نمونے کا استعمال کرتی ہے اس بات کا اندازہ لگانے کے لیے کہ ایک ورژن بڑی آبادی میں کیسا کارکردگی دکھا سکتا ہے۔ جانچ میں عام طور پر تمام ممکنہ گاہک شامل نہیں ہوتے ہیں، اس لیے تبادلوں کی شرح کی پیمائش ایک تخمینہ ہے بجائے اس کے کہ ایک مکمل طور پر معلوم آبادی کی قدر ہو۔
اعداد و شمار کی غیر یقینی صورتحال اس حقیقت کی وجہ بنتی ہے کہ یہ اندازے نمونے سے نمونے تک مختلف ہو سکتے ہیں۔ اگرچہ دونوں ورژنز کی بنیادی کارکردگی میں کوئی تبدیلی نہیں آئی ہے، تاہم زائرین کے مختلف گروپوں کے لیے نتائج قدرے مختلف ہو سکتے ہیں۔
کئی عوامل تجربے کی غیر یقینی صورتحال کو متاثر کرتے ہیں۔
- نمونہ سائز: چھوٹے نمونے عام طور پر بڑے نمونوں کے مقابلے میں کم درست تخمینہ لگاتے ہیں۔
- منتقلی کی تعدد: اگر مطلوبہ کارروائی نایاب ہے، تو تبادلوں کی شرحوں کا درست اندازہ لگانے کے لیے مزید مشاہدات کی ضرورت ہو سکتی ہے۔
- بے ترتیب تغیرات: زائرین کے انفرادی رویے کی پوری طرح پیش گوئی نہیں کی جا سکتی۔
- تجرباتی ڈیزائن: غیر مساوی مختص، ٹریکنگ کے مسائل، یا جانچ کے دوران تبدیلیاں موازنہ کو کمزور کر سکتی ہیں۔
چھوٹے نمونوں میں پائے جانے والے چھوٹے فرق بے ترتیب تغیر کی وجہ سے ہو سکتے ہیں۔ بڑے، بہتر ڈیزائن کردہ تجربات مضبوط ثبوت فراہم کر سکتے ہیں، لیکن صرف نمونے کا سائز ہی متعصبانہ تفویض یا غلط ٹریکنگ جیسے مسائل کو حل نہیں کر سکتا۔
شماریاتی اہمیت اور کاروباری اہمیت
شماریاتی اہمیت اس بات کی نشاندہی کرتی ہے کہ آیا مشاہدہ شدہ نتائج کسی دیے گئے شماریاتی ماڈل کے لیے غیر معمولی ہیں جن میں ورژن کے درمیان کوئی حقیقی فرق نہیں ہے۔ یہ آپ کو براہ راست نہیں بتاتا کہ فرق آپ کے کاروبار کے لیے کتنا اہم ہے، اور نہ ہی یہ ثابت کرتا ہے کہ نتائج مستقبل کے تمام ماحول میں دہرائے جا سکیں گے۔
کاروباری اہمیت کا تعلق اس بات سے ہے کہ آیا بہتری کا پیمانہ اس پر کارروائی کرنے کے قابل ہے۔ مثال کے طور پر، تبادلوں کی شرحوں میں چھوٹی بہتری زیادہ ٹریفک والی ویب سائٹ پر معنی خیز اضافی آمدنی پیدا کر سکتی ہے، لیکن کم ٹریفک والی سائٹ پر تھوڑی اضافی قدر کا اضافہ کر سکتی ہے۔ تبدیلی کو لاگو کرنے کے اخراجات اور خطرات بھی اہم ہیں۔
ایک ذمہ دار A/B جانچ کے عمل کو:
- جانچ شروع ہونے سے پہلے بنیادی نتائج کی وضاحت کریں۔
- جہاں مناسب ہو، ہم تصادفی طور پر اہل زائرین کو تفویض کریں گے۔
- اس بات کو یقینی بنائیں کہ آپ کی تبادلوں کی ٹریکنگ دونوں ورژنوں میں مستقل طور پر کام کرتی ہے۔
- نتائج کا جائزہ لینے سے پہلے، اس بات کا تعین کریں کہ ڈیٹا اور جانچ کی مدت کتنی مناسب ہے۔
- شماریاتی غیر یقینی صورتحال اور مشاہدہ شدہ اختلافات کی حقیقی شدت پر غور کریں۔
- جب تک کہ آپ کا جانچ کا طریقہ واضح طور پر ترتیب وار نگرانی کی وضاحت نہیں کرتا ہے، نتائج کو بار بار چیک کریں اور جیسے ہی ایک ورژن اچھا لگے بند نہ کریں۔
- دستاویز کے نتائج، حدود اور فیصلے۔
A/B ٹیسٹنگ صرف ایک اعلی تناسب کے ساتھ ورژن کو منتخب کرنے کا معاملہ نہیں ہے۔ مقصد اس بارے میں قابل اعتماد ثبوت اکٹھا کرنا ہے کہ آیا تبدیلیاں نتائج میں بامعنی بہتری کا باعث بنتی ہیں۔
یہاں اہم سبق یہ ہے کہ شماریاتی غیر یقینی صورتحال اہم ہے کیونکہ نمونے کے نتائج اصل بنیادی کارکردگی سے مختلف ہو سکتے ہیں۔ ان غیر یقینی صورتحال کو سمجھنے سے آپ بے ترتیب اتار چڑھاو کی بنیاد پر مارکیٹنگ کے مہنگے فیصلے کرنے سے بچ سکتے ہیں۔
حصہ 6: مارکیٹنگ آٹومیشن
مارکیٹنگ ٹیمیں اکثر اوقات اعادہ کرنے کے عمل میں بہت زیادہ وقت صرف کرتی ہیں جو پیشین گوئی کے اصولوں پر عمل کرتے ہیں۔
یہ آٹومیشن کو ازگر کی سب سے طاقتور ایپلی کیشنز میں سے ایک بنا دیتا ہے۔
باب 26: آٹومیشن کے مواقع کی شناخت
آٹومیشن کے اچھے امیدواروں میں عام طور پر کئی خصوصیات ہوتی ہیں:
- بار بار ہوتا ہے۔
- یہ پیشین گوئی کے مراحل کی پیروی کرتا ہے۔
- سٹرکچرڈ ڈیٹا استعمال کریں۔
- تھوڑا سا موضوعی فیصلہ درکار ہے۔
- دستی طور پر کیے جانے پر غلطیاں عام ہیں۔
- آٹومیشن بامعنی وقت بچاتا ہے۔
مثال کے طور پر:
"ہر پیر کو، ہم مہم کا ڈیٹا ڈاؤن لوڈ کرتے ہیں، ROAS کا حساب لگاتے ہیں، حد سے نیچے کی مہموں کی نشاندہی کرتے ہیں اور رپورٹیں تیار کرتے ہیں۔"
یہ آٹومیشن کے لیے ایک بہترین امیدوار ہے۔
باب 27: بلڈنگ رپورٹنگ
ہر قدم کو دستی طور پر چلانے کے بجائے، ایک فنکشن بنائیں۔
def generate_campaign_report(
    input_file,
    output_file
):
    df = pd.read_csv(input_file)

    df["roas"] = (
        df["revenue"] /
        df["cost"]
    )

    df["conversion_rate"] = (
        df["conversions"] /
        df["clicks"] *
        100
    )

    df.to_csv(
        output_file,
        index=False
    )
پھر:
generate_campaign_report(
    "campaigns.csv",
    "campaign_report.csv"
)
اب آپ ورک فلو کو دہرا سکتے ہیں۔
باب 28: لاگنگ
جب اسکرپٹ خود بخود چلتا ہے۔ print() اکیلے بیانات اکثر کافی نہیں ہوتے ہیں۔
لاگنگ ایک زیادہ منظم انداز فراہم کرتا ہے۔
import logging

logging.basicConfig(
    level=logging.INFO
)

logging.info(
    "Marketing report started."
)
پھر:
logging.info(
    "Campaign data loaded successfully."
)
اگر کوئی غلطی ہوتی ہے:
logging.error(
    "Unable to load campaign data."
)
لاگنگ خاص طور پر اس وقت مفید ہے جب طے شدہ کام بغیر توجہ کے چلتے ہیں۔
باب 29: شیڈولنگ
اسکرپٹ کام کرنے کے بعد، آپ اسے شیڈول کر سکتے ہیں۔
مثال کے طور پر، آپ ہر پیر کی صبح رپورٹنگ پروگرام چلانے کے لیے اپنے آپریٹنگ سسٹم کو ترتیب دے سکتے ہیں۔
ریزرویشن کا نظام خود آپ کے ماحول کے لحاظ سے مختلف ہوتا ہے۔ ونڈوز میں، ٹاسک شیڈیولر Python پروگرام چلا سکتا ہے۔ میکوس اور لینکس پر، کرون ایک عام آپشن ہے۔ کلاؤڈ پلیٹ فارم بھی طے شدہ کام چلا سکتے ہیں۔
اہم تصور ہے۔ آٹومیشن اس وقت تک مکمل نہیں ہوتی جب تک کہ کوئی اسے دستی طور پر شروع کیے بغیر یہ عمل قابل اعتماد طریقے سے نہ چل سکے۔
باب 30: آٹو الرٹس
آپ کے مارکیٹنگ سسٹم کو ہمیشہ کسی کی رپورٹ کھولنے کا انتظار نہیں کرنا چاہیے۔
نازک حالات کی نشاندہی کی جا سکتی ہے۔
if overall_roas < 1:
    alert = (
        "Warning: overall ROAS is below 1."
    )
یا:
if conversion_rate < previous_rate * 0.8:
    alert = (
        "Conversion rate has fallen "
        "significantly compared with the "
        "previous period."
    )
انتباہات کو بالآخر ای میل، سلیک، مائیکروسافٹ ٹیمز، یا کسی اور اطلاعی نظام سے جوڑا جا سکتا ہے۔
اہم بات یہ ہے کہ نظام ان حالات کی نشاندہی کرتا ہے جن پر توجہ کی ضرورت ہوتی ہے۔
باب 31: ذمہ دار آٹومیشن
آٹومیشن آپ کی مارکیٹنگ کی کوششوں کو تیز تر اور زیادہ مستقل بنا سکتی ہے، لیکن یہ پیمانے پر غلطیاں دہرانے کا باعث بھی بن سکتی ہے۔ ایک اسکرپٹ جو ایک بار غلط میٹرک کا حساب لگاتا ہے وہ ہر بار چلائے جانے پر وہی غلط نتائج دے سکتا ہے۔ نتائج تیزی سے بڑھ سکتے ہیں جب رپورٹس کو مہم کے فیصلوں یا خودکار کسٹمر مواصلات میں شامل کیا جاتا ہے۔
فرض کریں کہ آپ کی رپورٹس غلطی سے کسی گاہک کو پروموشن کے لیے اہل ظاہر کرتی ہیں جب وہ اہلیت کے اصولوں پر پورا نہیں اترتے ہیں۔ دستی جائزہ آپ کو مسائل کی نشاندہی کرنے میں مدد کر سکتا ہے۔ توثیق کے بغیر خودکار نظام بار بار غلط فہرستیں تقسیم کر سکتے ہیں۔
اس وجہ سے، پروڈکشن آٹومیشن میں ان پٹ کی توثیق، غلطی سے نمٹنے، لاگنگ، جانچ، اور نگرانی شامل ہونی چاہیے۔ اہم کاموں کے لیے انسانی منظوری درکار ہو سکتی ہے۔
سادہ، پیداوار کے لیے تیار ورک فلو
ایک بنیادی مارکیٹنگ رپورٹ آٹومیشن ورک فلو ان اقدامات پر عمل کر سکتا ہے:
- سورس ڈیٹا لوڈ کریں۔ تازہ ترین مہم برآمد یا منظور شدہ ان پٹ فائل پڑھیں۔
- اپنے ڈیٹا کی تصدیق کریں: یقینی بنائیں کہ مطلوبہ کالم موجود ہیں، عددی فیلڈز درست قدروں پر مشتمل ہیں، اور غیر متوقع ریکارڈز کو جھنڈا لگایا گیا ہے۔
- میٹرکس کا حساب لگائیں۔ صفر ڈینومینیٹرس کو صحیح طریقے سے سنبھالتے ہوئے تبادلوں کی شرحیں، CPA، اور ROAS بنائیں۔
- رپورٹ کو محفوظ کریں۔ نتائج کو مخصوص آؤٹ پٹ مقام پر لکھتا ہے۔
- اپنے نتائج ریکارڈ کریں۔ رپورٹ کی کامیابی یا ناکامی کو ریکارڈ کریں تاکہ کوئی اس مسئلے کی تحقیقات کر سکے۔
- شیڈول اور عمل کی نگرانی. آپریٹنگ سسٹم شیڈیولر یا منظور شدہ ٹیوننگ ٹول استعمال کریں اور تصدیق کریں کہ یہ متوقع آؤٹ پٹ تیار کرتا ہے۔
درج ذیل مثال مہم کی رپورٹ کے لیے ایک سادہ ورک فلو دکھاتی ہے۔ فرض کریں کہ ان پٹ CSV ہر مہم پر ایک قطار پر مشتمل ہے اور اس پر مشتمل ہے: campaign, clicks, conversions, costاور revenue گرمی
import logging
from pathlib import Path

import pandas as pd

logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s %(levelname)s: %(message)s"
)

REQUIRED_COLUMNS = {
    "campaign",
    "clicks",
    "conversions",
    "cost",
    "revenue"
}


def generate_report(input_file, output_file):
    input_path = Path(input_file)
    output_path = Path(output_file)

    try:
        if not input_path.exists():
            raise FileNotFoundError(
                f"Input file not found: {input_path}"
            )

        df = pd.read_csv(input_path)

        missing = REQUIRED_COLUMNS - set(df.columns)
        if missing:
            raise ValueError(
                f"Missing required columns: {sorted(missing)}"
            )

        numeric_columns = [
            "clicks",
            "conversions",
            "cost",
            "revenue"
        ]

        for column in numeric_columns:
            df[column] = pd.to_numeric(
                df[column],
                errors="coerce"
            )

        if df[numeric_columns].isna().any().any():
            raise ValueError(
                "Required numeric fields contain missing "
                "or invalid values."
            )

        if (df[numeric_columns] < 0).any().any():
            raise ValueError(
                "Negative values were found in metrics "
                "that should not be negative."
            )

        if (df["conversions"] > df["clicks"]).any():
            logging.warning(
                "Some campaigns have more conversions "
                "than clicks. Check the metric definitions."
            )

        df["conversion_rate"] = (
            df["conversions"]
            .div(df["clicks"].replace(0, float("nan")))
            .mul(100)
        )

        df["cpa"] = (
            df["cost"]
            .div(
                df["conversions"].replace(
                    0, float("nan")
                )
            )
        )

        df["roas"] = (
            df["revenue"]
            .div(df["cost"].replace(0, float("nan")))
        )

        output_path.parent.mkdir(
            parents=True,
            exist_ok=True
        )

        df.to_csv(output_path, index=False)

        logging.info(
            "Report saved successfully to %s",
            output_path
        )

    except Exception:
        logging.exception(
            "Marketing report generation failed"
        )
        raise


if __name__ == "__main__":
    generate_report(
        "campaigns.csv",
        "reports/campaign_report.csv"
    )
اس ورک فلو کو کیا زیادہ محفوظ بنائے گا؟
اسکرپٹ چیک کرتا ہے کہ آیا ان پٹ فائل موجود ہے اور آیا مطلوبہ کالم موجود ہیں۔ یہ ایک میٹرک کالم کو عددی اقدار میں تبدیل کرنے کی کوشش کرتا ہے اور اگر مطلوبہ فیلڈز میں گم یا غلط ڈیٹا موجود ہو تو رک جاتا ہے۔ یہ میٹرکس کے لیے منفی اقدار کو بھی جھنڈا لگاتا ہے جو عام طور پر منفی نہیں ہونا چاہیے۔
اگر تبادلوں کی تعداد کلکس کی تعداد سے زیادہ ہے، تو مثال ڈیٹا کو خود بخود تبدیل کرنے کے بجائے ایک انتباہ کو لاگ کرتی ہے۔ آپ کی کمپنی کی منتقلی کی تعریف پر منحصر ہے، یہ نتائج ہو سکتے ہیں اور خاموشی سے طے کرنے کے بجائے ان کی چھان بین کی جانی چاہیے۔
حسابی شرح گمشدہ اقدار کا استعمال کرتی ہے اگر ڈینومینیٹر 0 ہے۔ یہ غیر متعینہ تناسب کو درست اعداد کے طور پر رپورٹ ہونے سے روکتا ہے۔ اسکرپٹ ضرورت پڑنے پر ایک آؤٹ پٹ ڈائرکٹری بھی بناتی ہے، کامیاب تکمیل کو لاگ کرتی ہے، اور غلطیوں کے ہونے سے پہلے لاگ ان کرتی ہے تاکہ شیڈولر یا مانیٹرنگ سسٹم ان کا پتہ لگا سکے۔
یہ ایک مکمل مانیٹرنگ پلیٹ فارم کے بجائے ایک عملی نقطہ آغاز ہے۔ حقیقی دنیا کی تعیناتیوں کو ڈیٹا کی تازہ کاری، بے کار درآمدات، قطاروں کی متوقع تعداد، رسائی کی اجازت، محفوظ اسٹوریج، بیک اپ، انتباہات، اور آیا کسی انسان کو مہمات پر اثر انداز ہونے سے پہلے رپورٹس کو منظور کرنے کی ضرورت پر بھی غور کرنا چاہیے۔
ورک فلو شیڈولنگ
آپ جانچ کے دوران اسکرپٹ کو دستی طور پر چلا سکتے ہیں۔ ایک بار جب یہ قابل اعتماد طریقے سے کام کرتا ہے، تو آپ اسے لینکس اور میک او ایس پر ونڈوز ٹاسک شیڈیولر یا کرون جیسے ٹولز کا استعمال کرکے شیڈول کرسکتے ہیں۔ شیڈولر طے کرتا ہے کہ اسکرپٹ کب چلتا ہے۔ ازگر کوڈ اسکرپٹ کی فعالیت کا تعین کرتا ہے۔
شیڈول کرنے سے پہلے، نمونے کے اعداد و شمار کے ساتھ اپنے ورک فلو کی جانچ کریں اور جان بوجھ کر مسائل متعارف کروائیں جیسے کالم غائب ہونا یا غلط عددی اقدار۔ یقینی بنائیں کہ آپ کا اسکرپٹ ایک گمراہ کن رپورٹ بنانے کے بجائے واضح طور پر ناکام ہوجاتا ہے۔
یہاں اہم سبق یہ ہے کہ قابل اعتماد آٹومیشن صرف انسانی مداخلت کے بغیر کوڈ کو چلانے کے بارے میں نہیں ہے۔ آپ کو ان پٹ کی توثیق کرنے، ناکامیوں سے نمٹنے، نتائج کو دستاویز کرنے، اور خودکار آؤٹ پٹ کی وشوسنییتا کو یقینی بنانے کے بارے میں بھی فکر کرنی ہوگی۔
حصہ 7: مارکیٹنگ کے لیے مشین لرننگ
مشین لرننگ اس وقت مفید ہوتی ہے جب آپ یہ بتانے سے آگے بڑھنا چاہتے ہیں کہ کیا ہوا اس کی پیشین گوئی کرنے کے لیے آگے کیا ہوگا۔
باب 32: تجزیہ سے پیشین گوئی تک
روایتی تجزیات سوالات کا جواب دے سکتے ہیں جیسے "گزشتہ ماہ کن صارفین نے خریدا؟"
دوسری طرف، مشین لرننگ اس بات کا جواب دے سکتی ہے کہ "اگلے مہینے کون سے صارفین سب سے زیادہ خرید سکتے ہیں؟"
روایتی تجزیات پوچھتے ہیں، "کون سی لیڈز تبدیل ہوئیں؟"
مشین لرننگ پوچھتی ہے، "کون سی لیڈز کے تبدیل ہونے کا زیادہ امکان ہے؟"
روایتی تجزیات پوچھتے ہیں، "کون سے گاہک منڈلا رہے ہیں؟"
مشین لرننگ پوچھتی ہے، "کس گاہک کا سب سے زیادہ امکان ہے؟"
یہ فرق اہم ہے۔ مشین لرننگ تجزیات کی جگہ نہیں لیتی۔ اس پر مبنی ہے۔
باب 33: افعال اور سامعین
مشین لرننگ ماڈلز کو عام طور پر ان پٹ متغیرات کی ضرورت ہوتی ہے جسے فیچر کہتے ہیں۔
ہم کہتے ہیں کہ آپ گاہک کے منتھن کی پیشن گوئی کرنا چاہتے ہیں۔ خصوصیات میں شامل ہیں:
purchase_frequency
total_spend
days_since_last_purchase
email_opens
website_sessions
اہداف ہو سکتے ہیں:
churned
ازگر میں:
features = [
    "purchase_frequency",
    "total_spend",
    "days_since_last_purchase",
    "email_opens",
    "website_sessions"
]

X = df[features]
y = df["churned"]
یہاں:
X پیشین گوئیوں کے لیے استعمال ہونے والی معلومات پر مشتمل ہے۔
y اس میں وہ نتیجہ ہوتا ہے جس کی آپ پیش گوئی کرنا چاہتے ہیں۔
باب 34: ڈیٹا تقسیم کرنا
مشین لرننگ ماڈل کو تربیت دینے سے پہلے، آپ کو ماڈل کی تربیت کے لیے استعمال ہونے والے ڈیٹا کو ماڈل کی جانچ کے لیے استعمال کیے جانے والے ڈیٹا سے الگ کرنا چاہیے۔
یہ اہم ہے کیونکہ ایک ماڈل نئی مثالوں پر یکساں طور پر اچھی کارکردگی دکھائے بغیر ان مثالوں پر اچھی کارکردگی کا مظاہرہ کر سکتا ہے جو ہم پہلے ہی دیکھ چکے ہیں۔ اسی تاریخ کو استعمال کرتے ہوئے کسی ماڈل کا جائزہ لینے سے جس پر اسے تربیت دی گئی تھی اس کے نتیجے میں یہ حد سے زیادہ پر امید تاثر پیدا ہو سکتا ہے کہ ماڈل حقیقت میں کتنی اچھی کارکردگی کا مظاہرہ کرے گا۔
عمومی نقطہ نظر ہے۔ تربیتی سیٹ اور ٹیسٹ سیٹ:
- تربیتی سیٹ: یہ وہ تاریخ ہے جسے ماڈل پیٹرن سیکھنے کے لیے استعمال کرتا ہے۔
- ٹیسٹ سیٹ: ریکارڈنگ کو اس وقت تک روک دیا گیا جب تک اس کا اندازہ نہیں لگایا جاتا کہ تربیت یافتہ ماڈل نے تربیت کے لیے استعمال نہ ہونے والے ڈیٹا پر کس طرح کارکردگی کا مظاہرہ کیا۔
مثال کے طور پر، ایک 80/20 تقسیم تقریباً 80% ریکارڈ کو تربیت اور 20% ٹیسٹنگ کے لیے مختص کرے گی۔ یہ کوئی آفاقی اصول نہیں ہے، بلکہ ایک عام نقطہ آغاز ہے۔ مناسب تقسیم کا انحصار ڈیٹا سیٹ کے سائز، پیشین گوئی کے کام، اور ماڈل کے استعمال کے طریقہ پر ہے۔
سکِٹ لرن کا استعمال کرتے ہوئے سپلٹس بنانا
گھر X ماڈل کی ان پٹ خصوصیات پر مشتمل ہے اور y اس میں وہ مقصد ہے جس کی آپ پیش گوئی کرنا چاہتے ہیں۔
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)
یہاں، test_size=0.2 ٹیسٹنگ کے لیے 20% ریکارڈ محفوظ کریں۔ random_state=42 یہ بے ترتیب تقسیم کو دوبارہ پیدا کرنے کے قابل بناتا ہے، لہذا آپ دوبارہ وہی تقسیم حاصل کر سکتے ہیں چاہے آپ کا ڈیٹا سیٹ اور کوڈ تبدیل نہ ہو۔
درجہ بندی کے مسائل کے لیے، دونوں سیٹوں میں ہر کلاس کے تخمینی تناسب کو محفوظ کرنا بھی ممکن ہے۔
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)
استعمال کریں stratify=y یہ اکثر اس وقت مددگار ثابت ہوتا ہے جب ٹارگٹ کلاس غیر متوازن ہو۔ تاہم، تہہ بندی کے لیے ہر کلاس کے لیے کافی مثالیں درکار ہوتی ہیں اور یہ تمام کاموں کے لیے موزوں نہیں ہے۔
وقت سے متعلق لیکس سے بچیں۔
مارکیٹنگ ڈیٹا کے لیے بے ترتیب تقسیم ہمیشہ مناسب نہیں ہوتی۔ مستقبل کی خریداریوں یا مستقبل کے منتھن کی پیشین گوئی کرتے وقت، تاریخ کا ایک تاریخی ترتیب ہوتا ہے۔ بعد کے مشاہدات پر تربیت اور پچھلے مشاہدات پر جانچ مستقبل کی معلومات کو تشخیص پر اثر انداز ہونے کی اجازت دیتی ہے۔
وقت پر منحصر پیشین گوئیوں کے لیے، پچھلی مدت پر تربیت اور بعد کی مدت پر جانچ پر غور کریں۔ تقسیم کو اس معلومات کی عکاسی کرنی چاہیے جو پیشین گوئی کے وقت اصل میں دستیاب تھی۔
یہ بھی یاد رکھیں کہ ڈیٹا لیک ہونے سے بچنے کے لیے صرف ڈیٹا تقسیم کرنا کافی نہیں ہے۔ پہلے سے پروسیسنگ کے اقدامات جو ڈیٹا سیٹ سے معلومات سیکھتے ہیں (جیسے کہ قدر کی کمی یا خصوصیت کی توسیع) کے لیے عام طور پر صرف تربیتی ڈیٹا کا استعمال کرتے ہوئے اور پھر اسے ٹیسٹ ڈیٹا پر لاگو کرنے کی ضرورت ہوتی ہے۔
یاد رکھیں: ڈیٹا کی تقسیم آپ کو غیر دیکھے ہوئے ڈیٹا پر اپنے ماڈل کی کارکردگی کا اندازہ لگانے میں مدد کرتی ہے، لیکن تقسیم سے یہ ظاہر ہونا چاہیے کہ آپ کا ماڈل حقیقی دنیا میں کیسے استعمال ہوگا۔
باب 35 درجہ بندی
درجہ بندی ایک مشین لرننگ کام ہے جس میں ایک ماڈل زمروں یا کلاسوں کی پیش گوئی کرتا ہے۔ مارکیٹنگ کے طریقوں میں یہ پیشین گوئی کرنا شامل ہے کہ آیا گاہک منتھن کریں گے، کیا لیڈز تبدیل ہوں گی، آیا ای میل کو اسپام کے طور پر نشان زد کرنے کا امکان ہے، یا آیا کوئی صارف ایک مقررہ مدت کے اندر خریداری کرے گا۔
درجہ بندی رجعت سے مختلف ہے۔ درجہ بندی زمرہ جات کی پیشین گوئی کرتی ہے، جب کہ رجعت عددی اقدار کی پیشین گوئی کرتی ہے، جیسے متوقع آمدنی یا گاہک کی زندگی بھر کی قدر۔
درجہ بندی کے ماڈل تاریخی مثالوں سے نمونے سیکھتے ہیں جہاں صحیح نتیجہ پہلے سے معلوم ہوتا ہے۔ اس کے بعد یہ نئے ریکارڈ کے نتائج کی پیشن گوئی کرنے کے لیے اس پیٹرن کا استعمال کرتا ہے۔ ماڈل کی پیشین گوئیاں تخمینہ ہیں نہ کہ ضمانت۔
خصوصیات اور سامعین کے لیے تیار
ہم کہتے ہیں کہ آپ پیشن گوئی کرنا چاہتے ہیں کہ آیا کوئی گاہک منڈلا جائے گا۔ ڈیٹا سیٹ میں درج ذیل خصوصیات شامل ہو سکتی ہیں:
purchase_frequency
total_spend
days_since_last_purchase
email_opens
website_sessions
ہدف درج ذیل کالموں میں سے کوئی بھی ہو سکتا ہے: churnedیہاں، ہر ریکارڈ کو یہ بتانے کے لیے لیبل لگایا جاتا ہے کہ آیا گاہک نے واضح طور پر متعین مدت کے دوران منڈلا یا نہیں۔
ازگر میں:
features = [
    "purchase_frequency",
    "total_spend",
    "days_since_last_purchase",
    "email_opens",
    "website_sessions"
]

X = df[features]
y = df["churned"]
یہاں، X پیشین گوئیوں کے لیے استعمال ہونے والی معلومات پر مشتمل ہے، y ان نتائج پر مشتمل ہے جن کی ماڈل کو پیش گوئی کرنی چاہیے۔ خصوصیات میں صرف وہ معلومات شامل ہونی چاہئیں جو پیشین گوئی کے وقت اصل میں دستیاب ہوں۔
ماڈل کو فٹ کرنے سے پہلے، گمشدہ اقدار اور واضح متغیرات کو مناسب طریقے سے ہینڈل کریں اور ڈیٹا سیٹ کو ٹریننگ اور ٹیسٹ سیٹ میں تقسیم کریں جیسا کہ پچھلے باب میں بیان کیا گیا ہے۔
لاجسٹک ریگریشن کلاسیفائر کی تربیت
لاجسٹک ریگریشن بائنری درجہ بندی کے لیے ایک عام نقطہ آغاز ہے، جیسے کہ دو میں سے کسی ایک نتائج کی پیشین گوئی کرنا: churn or no churn.
from sklearn.linear_model import LogisticRegression

model = LogisticRegression(
    max_iter=1000
)

model.fit(
    X_train,
    y_train
)
کہ fit() یہ طریقہ تربیتی خصوصیات اور معلوم ہدف کے لیبلز کا استعمال کرتے ہوئے ایک ماڈل کو تربیت دیتا ہے۔ ماڈل ان پٹ متغیرات اور نتائج کے درمیان تعلقات کو سیکھتا ہے۔
زیر التواء ٹیسٹ خصوصیات کے لیے کلاسوں کی پیشین گوئی کرنے کے لیے تربیت یافتہ ماڈل استعمال کریں۔
predictions = model.predict(
    X_test
)
کہ predict() طریقہ پیشن گوئی شدہ کلاس لیبل تیار کرتا ہے۔ بائنری چرن ماڈل کے لیے، لیبل منتھن یا کوئی چرن کی نشاندہی کر سکتا ہے۔
آپ اپنی پیشین گوئیوں کا اندازہ لگانے کے لیے درجہ بندی کی رپورٹ کا استعمال کر سکتے ہیں۔
from sklearn.metrics import classification_report

print(
    classification_report(
        y_test,
        predictions,
        zero_division=0
    )
)
یہ رپورٹ میٹرکس کا خلاصہ کرتی ہے جیسے کہ درستگی، یاد کرنا، اور F1 سکور ہر کلاس کے لیے۔
دوسرے درجہ بندی کے ماڈل
لاجسٹک ریگریشن واحد آپشن نہیں ہے۔ آپ کے ڈیٹا اور مسئلہ پر منحصر ہے، آپ یہ بھی تفتیش کر سکتے ہیں:
- فیصلہ کن درخت: یہ خصوصیت کی اقدار کی بنیاد پر فیصلے کے قواعد کا ایک سیٹ سیکھتا ہے۔
- بے ترتیب جنگل: متعدد فیصلہ کن درختوں سے پیشین گوئیوں کو یکجا کریں۔
- گریڈینٹ بڑھانا: ماڈلز کی ایک سیریز بنائیں جس کا مقصد پیشین گوئی کی کارکردگی کو بہتر بنانا ہے۔
- سپورٹ ویکٹر مشینیں: فیصلہ کی حدود کی نشاندہی کریں جو کلاسوں کو الگ کرتی ہیں۔
- بولی بےز: ہم کلاس کی رکنیت کا اندازہ لگانے کے لیے امکانی مفروضے استعمال کرتے ہیں۔
مختلف ماڈلز کے مختلف فوائد، کمپیوٹیشنل تقاضے اور تشریحی صلاحیت ہوتی ہے۔ زیادہ پیچیدہ ماڈل خود بخود بہتر نہیں ہوتا ہے۔ اسی ڈیٹا کی تقسیم اور تشخیص کے معیار کو استعمال کرتے ہوئے موزوں ماڈلز کا موازنہ کریں، اور صرف تربیتی کارکردگی کی بنیاد پر ماڈل کے انتخاب سے گریز کریں۔
تو یاد رکھیں: درجہ بندی کا ماڈل ایک نئے ریکارڈ کے زمرے کی پیشین گوئی کرنے کے لیے لیبل شدہ ماضی کی مثالوں سے سیکھتا ہے۔ استعمال کا انحصار اس بات پر ہے کہ ڈیٹا کے معیار، خصوصیات کا وقت، ماڈل کے انتخاب، اور پیشین گوئیوں کی کتنی اچھی طرح سے جانچ کی جاتی ہے۔
باب 36 کیوں درستگی گمراہ کن ہو سکتی ہے۔
درستگی درجہ بندی کے ماڈل کی درست پیشین گوئیوں کے تناسب کی پیمائش کرتی ہے۔ اگرچہ سمجھنا آسان ہے، یہ گمراہ کن ہو سکتا ہے جب کلاسز غیر متوازن ہوں یا غلطیوں کی وجہ سے آپ کے کاروبار کو مختلف طریقے سے لاگت آئے۔
فرض کریں کہ آپ کے صرف 1% گاہک منڈلاتے ہیں۔ ایک ماڈل جو تمام صارفین کے لیے "کوئی منتھن نہیں" کی پیش گوئی کرتا ہے تقریباً 99% درستگی حاصل کرتا ہے۔ تاہم، یہ ان صارفین کی شناخت کرنے میں ناکام رہتا ہے جنہوں نے حقیقت میں منتھنی کی ہے۔
اگرچہ یہ ماڈل انتہائی درست ہے، لیکن یہ عملی طور پر بیکار ہو سکتا ہے اگر آپ کا مقصد ایسے صارفین کی شناخت کرنا ہے جنہیں برقرار رکھنے کی کوششوں کی ضرورت ہے۔
اپنے درجہ بندی کے ماڈل کو بہتر طریقے سے جانچنے کے لیے، درستگی، یاد کرنے، F1 سکور، ROC-AUC، اور کنفیوژن میٹرکس پر غور کریں۔
کنفیوژن میٹرکس
کنفیوژن میٹرکس پیش گوئی شدہ لیبلز کا اصل لیبل سے موازنہ کرتا ہے۔ بائنری درجہ بندی کے لیے، اس میں چار نتائج ہوتے ہیں:
- حقیقی مثبت (TP): ماڈل ایک مثبت کلاس کی پیش گوئی کرتا ہے اور اصل کلاس مثبت ہے۔
- حقیقی منفی (TN): ماڈل منفی کلاس کی پیش گوئی کرتا ہے اور اصل کلاس منفی ہے۔
- غلط مثبت (FP): ماڈل ایک مثبت کلاس کی پیش گوئی کرتا ہے، لیکن اصل کلاس منفی ہے۔
- غلط منفی (FN): ماڈل منفی کلاس کی پیش گوئی کرتا ہے، لیکن اصل کلاس مثبت ہے۔
چرن ماڈلز کے لیے، حقیقی مثبت وہ گاہک ہوتے ہیں جن کی صحیح شناخت کرنرز کے طور پر کی جاتی ہے۔ جھوٹے مثبتات وہ ہیں جو صارفین کو غلط طریقے سے جھنڈا لگاتے ہیں جیسا کہ ممکنہ طور پر منڈلاتے ہیں۔ جھوٹے منفی وہ صارفین ہیں جو منتھن کرتے ہیں لیکن ماڈل کے ذریعہ ان کی شناخت نہیں ہوتی ہے۔
اس قسم کی غلطیوں کے مختلف نتائج ہوتے ہیں۔ غلط مثبت کے نتیجے میں کمپنی کسی ایسے شخص کے لیے برقرار رکھنے کی پیشکشوں پر رقم خرچ کر سکتی ہے جو بہرحال ٹھہرے گا۔ غلط منفی کا مطلب یہ ہو سکتا ہے کہ کمپنی کسی ایسے گاہک سے رابطہ کرنے کا موقع کھو دیتی ہے جو جانے والا ہے۔
درستگی
درستگی ان تمام پیشین گوئیوں کے تناسب کی پیمائش کرتی ہے جو درست ہیں۔
درستگی = (TP + TN) ¼ (TP + TN + FP + FN)
یہ اس وقت مفید ہو سکتا ہے جب کلاسز اور غلطی کے اخراجات معقول حد تک متوازن ہوں۔ تاہم، اگر ایک طبقہ دوسرے کے مقابلے میں بہت زیادہ عام ہے، تو درستگی کم عام طبقے کے لیے کارکردگی میں کمی کو چھپا سکتی ہے۔
ڈگری
درستگی پیش گوئی شدہ مثبتات کے تناسب کی پیمائش کرتی ہے جو حقیقت میں مثبت ہیں۔
درستگی = TP ¼ (TP + FP)
چرن ماڈل کے لیے، درست جواب یہ ہے: "آپ کا ماڈل جن صارفین کے جھنڈے گاڑتا ہے، ان میں سے اصل میں کتنے فیصد متھنے کا امکان ہے؟"
جب صارفین سے رابطہ کرنا مہنگا ہو یا جب جھوٹے الارم مہم کے محدود وسائل کو ضائع کرتے ہیں تو اعلیٰ درستگی مفید ہو سکتی ہے۔
یاد کرنا
Recall حقیقی مثبتات کے تناسب کی پیمائش کرتا ہے جس کی ایک ماڈل صحیح شناخت کرتا ہے۔
یاد کریں = TP ¼ (TP + FN)
چرن ماڈلز کے لیے، جواب دینا یاد رکھیں: "تمام صارفین میں سے جو اصل میں منتھن کرتے ہیں، ماڈل نے کس تناسب کی نشاندہی کی؟"
اگر آپ ایسے صارفین کو یاد کر رہے ہیں جن کو گرنے کا خطرہ ہے، خاص طور پر اگر اس پر آپ کو بہت زیادہ لاگت آتی ہے تو ایک اعلیٰ واپسی کی شرح اہم ہو سکتی ہے۔ تاہم، جیسے جیسے یاد کرنا بڑھتا ہے، ماڈل اور فیصلے کی حد کے لحاظ سے جھوٹے مثبتات بڑھ سکتے ہیں۔
F1 سکور
F1 سکور ہارمونک وسط کا استعمال کرتے ہوئے درستگی اور یاد کو یکجا کرتا ہے۔
F1 = 2 × (پریسیزن × یاد کرنا) ¼ (پریسیژن + یاد کرنا)
یہ تب مفید ہو سکتا ہے جب درستگی اور یاد دونوں اہم ہوں۔ یہ براہ راست حقیقی منفیوں کا حساب نہیں رکھتا ہے اور اسے ہر کاروباری مسئلے کے لیے بہترین میٹرک نہیں سمجھا جانا چاہیے۔
ROC-AUC
ROC-AUC خلاصہ کرتا ہے کہ ایک ماڈل مختلف درجہ بندی کی حدوں میں منفی مثالوں پر مثبت مثالوں کی کتنی اچھی جانچ کرتا ہے۔ 1 کے قریب ہونا مضبوط درجہ بندی کی کارکردگی کی نشاندہی کرتا ہے، اور 0.5 کے قریب عام تشریح کے مطابق بے ترتیب درجہ بندی جیسی کارکردگی کی نشاندہی کرتا ہے۔
ROC-AUC آپ کو یہ نہیں بتاتا کہ آیا آپ کی مارکیٹنگ کی کوششوں کے لیے کوئی خاص حد مناسب ہے۔ اگر مثبت کیسز نایاب ہیں، درست تولیدی تجزیہ بھی مفید بصیرت فراہم کر سکتا ہے۔ دونوں صورتوں میں، ڈیٹا پر ماڈل کا اندازہ کریں جو ماڈل کو تربیت دینے کے لیے استعمال نہیں کیا گیا تھا۔
Python میں میٹرکس کا حساب لگائیں۔
آپ اسکیٹ لرن کا استعمال کرتے ہوئے ان میں سے کچھ میٹرکس کا حساب لگا سکتے ہیں۔
from sklearn.metrics import (
    accuracy_score,
    precision_score,
    recall_score,
    f1_score,
    roc_auc_score,
    confusion_matrix
)

predictions = model.predict(X_test)

print("Accuracy:", accuracy_score(y_test, predictions))
print(
    "Precision:",
    precision_score(
        y_test, predictions, zero_division=0
    )
)
print(
    "Recall:",
    recall_score(
        y_test, predictions, zero_division=0
    )
)
print(
    "F1 score:",
    f1_score(
        y_test, predictions, zero_division=0
    )
)
print("Confusion matrix:")
print(confusion_matrix(y_test, predictions))
ROC-AUC کے لیے، ہم حتمی پیشین گوئی لیبل کے بجائے ماڈل کے امکانی تخمینہ یا فیصلہ سکور کا استعمال کرتے ہیں۔
probabilities = model.predict_proba(X_test)[:, 1]

print(
    "ROC-AUC:",
    roc_auc_score(y_test, probabilities)
)
یہ فرض کرتا ہے کہ ماڈل اس کی حمایت کرتا ہے۔ predict_proba() مثبت کلاسز کی نمائندگی دوسرے امکانی کالم سے ہوتی ہے۔ مخصوص ماڈلز اور ٹارگٹ لیبلز کے لیے کلاس آرڈر چیک کریں۔
صحیح میٹرکس کا انتخاب کریں۔
عالمی سطح پر کوئی بہترین درجہ بندی میٹرک نہیں ہے۔ مناسب انتخاب کا انحصار مقصد، طبقاتی تقسیم، اور مختلف غلطیوں کے اخراجات پر ہوتا ہے۔
مثال کے طور پر، ایک محدود بجٹ کے ساتھ دیکھ بھال کرنے والی ٹیم درستگی کو ترجیح دے سکتی ہے کیونکہ وہ صرف چند صارفین سے رابطہ کر سکتی ہے۔ اگر زیادہ خطرہ والے صارفین کو لاپتہ کرنا خاص طور پر مہنگا ہے، تو دوسری ٹیمیں واپس بلانے کو ترجیح دینا چاہیں گی۔
میٹرک کا انتخاب کرنے سے پہلے، ان کاروباری فیصلوں پر غور کریں جو آپ کا ماڈل سپورٹ کرتا ہے۔ ایک مفید تشخیص کو نہ صرف یہ بیان کرنا چاہیے کہ ماڈل کتنی اچھی کارکردگی کا مظاہرہ کرتا ہے، بلکہ یہ بھی کہ آیا اس کی غلطیاں اس کے مطلوبہ استعمال کے لیے قابل قبول ہیں۔
یہاں اہم سبق یہ ہے کہ درستگی ماڈل کی تشخیص کا صرف ایک حصہ ہے۔ درستگی، یاد، F1، ROC-AUC، اور کنفیوژن میٹرکس کارکردگی کے مختلف پہلوؤں کو ظاہر کرتے ہیں اور ماڈل کے معیار کو کاروباری نتائج سے جوڑنے میں مدد کرتے ہیں۔
باب 37: مشین لرننگ کے ساتھ کسٹمر سیگمنٹیشن
اصول پر مبنی سیگمنٹیشن گروپ صارفین کے لیے پہلے سے طے شدہ معیار کا استعمال کرتی ہے۔ مشین لرننگ ایک اور طریقہ پیش کرتی ہے جسے کلسٹرنگ کہتے ہیں۔ کلسٹرنگ الگورتھم استعمال شدہ خصوصیات اور فاصلے کے اقدامات کی بنیاد پر ملتے جلتے ڈیٹا اور گروپ مشاہدات میں پیٹرن تلاش کرتے ہیں۔
مارکیٹنگ ٹیموں کے لیے، کلسٹرنگ صارفین کے گروپس کو خریدنے میں ملتے جلتے رویے، اخراجات کی سطح، یا مشغولیت کے نمونوں کو تلاش کرنے میں مدد کر سکتی ہے۔ نتیجے میں آنے والے گروپ مزید تجزیہ کے لیے نقطہ آغاز فراہم کر سکتے ہیں، لیکن وہ خود بخود بامعنی کسٹمر کی اقسام کی نمائندگی نہیں کرتے ہیں۔
K-Means کلسٹرنگ کا استعمال کریں۔
K-Means ایک کلسٹرنگ الگورتھم ہے جو مشاہدات کو کلسٹرز کی منتخب تعداد میں تقسیم کرتا ہے۔ کلسٹر سینٹرائڈز کو بار بار مشاہدات تفویض کرکے اور ان سینٹروائڈز کو اپ ڈیٹ کرکے کلسٹر کے اندر مربع فاصلے کو کم کریں۔
یہ مثال فرض کرتی ہے کہ آپ کے ڈیٹاسیٹ میں پہلے سے ہی فی گاہک ایک قطار ہے اور اس میں شامل ہیں: recency, frequencyاور monetary گرمی
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler

features = df[
    [
        "recency",
        "frequency",
        "monetary"
    ]
].copy()

scaler = StandardScaler()

scaled_features = scaler.fit_transform(
    features
)

model = KMeans(
    n_clusters=4,
    random_state=42,
    n_init=10
)

df["segment"] = model.fit_predict(
    scaled_features
)
اس مثال میں، ہم کلسٹرنگ سے پہلے تین خصوصیات کو معمول پر لاتے ہیں۔ یہ اس لیے اہم ہے کہ اس کی مالیاتی قدر عددی اعتبار سے رجعت یا تعدد سے کہیں زیادہ ہو سکتی ہے۔ اسکیلنگ کے بغیر، بڑی عددی حدود والی خصوصیات فاصلے کے حساب کتاب پر حاوی ہو سکتی ہیں۔
معیاری کاری ان پٹ متغیرات کے پیمانے کو تبدیل کرتی ہے، لیکن کاروباری نقطہ نظر سے انہیں اتنا ہی اہم نہیں بناتی ہے۔ اگر آپ کا ڈیٹا انتہائی قدروں پر مشتمل ہے، تو آپ کو اس بات پر بھی غور کرنا چاہیے کہ آیا معیاری اسکیلنگ مناسب ہے اور کیا آپ کی خصوصیات کو اضافی پری پروسیسنگ کی ضرورت ہے۔
کہ n_clusters=4 سیٹ اپ K-Means سے 4 کلسٹر بنانے کو کہتا ہے۔ الگورتھم ہر صارف کو عددی لیبل اور کوڈ تفویض کرتا ہے۔ segment گرمی
کلسٹر نمبرز شناخت کنندہ ہیں، رینک نہیں۔
لیبل 0, 1, 2اور 3 چار گروپوں کے لیے صرف ایک شناخت کنندہ ہے۔ کلسٹر 0 خود بخود بہتر، زیادہ قیمتی، یا کلسٹر 1 سے زیادہ اہم نہیں ہے۔
نمبرز گاہک کے معیار کی درجہ بندی نہیں کرتے ہیں۔ ماڈل کو مختلف ترتیبات یا ڈیٹا کے ساتھ دوبارہ چلانے کے نتیجے میں مختلف عددی لیبل تفویض کیے جا سکتے ہیں، چاہے مجموعی گروپ پیٹرن ایک جیسے ہوں۔
یہ سمجھنے کے لیے کہ ہر کلسٹر کس چیز کی نمائندگی کرتا ہے، ہر گروپ کے لیے اصل وصف کی قدروں کا خلاصہ کریں۔
cluster_summary = (
    df.groupby("segment")
    .agg(
        customer_count=("segment", "size"),
        average_recency=("recency", "mean"),
        average_frequency=("frequency", "mean"),
        average_monetary=("monetary", "mean")
    )
    .round(2)
)

print(cluster_summary)
یہ خلاصہ آپ کو ہر کلسٹر میں صارفین کے مخصوص رویے کا موازنہ کرنے کی اجازت دیتا ہے۔ ایک گروپ میں وہ صارفین شامل ہو سکتے ہیں جنہوں نے حال ہی میں اور زیادہ بار خریداری کی ہے، جبکہ دوسرے گروپ میں وہ صارفین شامل ہو سکتے ہیں جنہوں نے اپنی آخری خریداری کے بعد سے کم بار اور طویل وقفے کے ساتھ خریداری کی ہے۔
اعداد و شمار کی طرف سے جائز ہونے پر وضاحتی نام تیار کرنے کے لیے مشاہدہ شدہ نمونوں کا استعمال کریں۔ مثال کے طور پر، حالیہ خریداریوں اور اعلی تعدد والے گروپ کو "بار بار صارفین" کے طور پر بیان کیا جا سکتا ہے۔ اعلی حالیہ اقدار اور پہلے زیادہ خرچ کرنے والے گروپ دوبارہ مشغولیت کے لیے تفتیش کے قابل ہو سکتے ہیں۔
صرف کلسٹر نمبر کی بنیاد پر نام تفویض نہ کریں۔ اصل اقدار کو چیک کریں اور یقینی بنائیں کہ تفصیل گروپ کے رویے سے ملتی ہے۔
کلسٹر کا انتخاب اور تشخیص
کلسٹرز کی تعداد ماڈلنگ کا انتخاب ہے۔ چار کلسٹرز ایک ڈیٹاسیٹ کے لیے مفید ہو سکتے ہیں، لیکن دوسرے ڈیٹاسیٹ کے لیے بہت زیادہ یا بہت کم ہو سکتے ہیں۔ امیدوار کی قدروں کا موازنہ کہنی کے طریقہ کار یا سلہیٹ سکور جیسے طریقوں سے کیا جا سکتا ہے، اس کے ساتھ کہ آیا نتیجہ گروپ قابل تشریح اور کاروبار کے لیے مفید ہے۔
کلسٹرنگ کے نتائج فیچرز، اسکیلنگ کے طریقہ کار، آؤٹ لیرز اور منتخب کردہ کلسٹرز کی تعداد کے لیے بھی حساس ہوتے ہیں۔ اس بات کی کوئی گارنٹی نہیں ہے کہ گروپ قدرتی گاہک کی اقسام سے مطابقت رکھتے ہیں، اور مختلف الگورتھم مختلف نتائج پیدا کر سکتے ہیں۔
کلیدی ٹیک وے: کلسٹرنگ ایسے نمونوں کو ظاہر کر سکتی ہے جو آپ کو کسٹمر گروپس کو تلاش کرنے میں مدد کرتی ہیں۔ کلسٹر لیبل خود فطری طور پر بے معنی ہیں۔ ہر گروپ کی خصوصیات کی جانچ کر کے اور اس بات کی تصدیق کر کے اس کی تشریح کریں کہ آیا یہ نمونے آپ کے کاروبار کے لیے مفید ہیں۔
باب 38: خصوصیت نکالنا
مشین لرننگ ماڈل اکثر اس وقت زیادہ کارآمد ہو جاتے ہیں جب خام ڈیٹا کو معنی خیز خصوصیات میں تبدیل کر دیا جاتا ہے۔
فرض کریں کہ آپ کی مندرجہ ذیل صورت حال ہے:
purchase_date
ماڈل کو براہ راست کچی تاریخیں فراہم کرنے کے بجائے، آپ تیار کر سکتے ہیں:
days_since_last_purchase
اسی طرح، خام لین دین کے ریکارڈ کے بجائے، آپ حساب کر سکتے ہیں:
total_orders
average_order_value
total_spend
days_since_first_purchase
email_open_rate
یہ انجینئرنگ صلاحیتیں کسٹمر کے رویے کی بہتر نمائندگی کر سکتی ہیں۔
فیچر انجینئرنگ اکثر مشین لرننگ پروجیکٹ کے سب سے اہم حصوں میں سے ایک ہوتی ہے۔
باب 39: ڈیٹا لیکس کو روکنا
ڈیٹا لیک اس وقت ہوتا ہے جب پیشن گوئی کے وقت ماڈل کو قانونی طور پر فراہم نہ کی گئی معلومات ماڈل کی تربیت یا تشخیص کو متاثر کرتی ہے۔ لیکس ایک ماڈل کو اس سے کہیں زیادہ درست بنا سکتا ہے جب اسے مستقبل کے حقیقی ڈیٹا کے ساتھ استعمال کیا جائے گا۔
فرض کریں کہ آپ یہ پیشین گوئی کرنے کے لیے ایک ماڈل بنانا چاہتے ہیں کہ آیا کوئی صارف اگلے 30 دنوں میں خریداری کرے گا۔ آپ کا مقصد یہ ہے کہ آپ کے گاہک اگلے مہینے کیا کریں گے اس کا اندازہ لگانے کے لیے فی الحال دستیاب معلومات کا استعمال کریں۔
اگر آپ غلطی سے کسی گاہک کے حقیقی خریداری کے نتائج کو اس مستقبل کی مدت سے ان پٹ خصوصیات کے طور پر شامل کرتے ہیں، تو آپ کے ماڈل کو وہ معلومات موصول ہوں گی جو پیشین گوئی کے وقت دستیاب نہیں تھی۔ یہ تشخیص کو گمراہ کن بنا دیتا ہے۔
ڈیٹا کی خلاف ورزیوں کی مثالیں۔
فرض کریں کہ آپ کے ڈیٹا سیٹ میں درج ذیل کالم ہیں:
past_purchases
website_visits
purchased_next_30_days
پہلے دو کالم ریکارڈنگ کے رویے کو بیان کرتے ہیں۔ آخری کالم اس نتیجہ کو ریکارڈ کرتا ہے جس کی آپ پیش گوئی کرنا چاہتے ہیں۔
درج ذیل کوڈ میں لیک کا مسئلہ ہے:
# Incorrect: the target is included as an input feature.
X = df[
    [
        "past_purchases",
        "website_visits",
        "purchased_next_30_days"
    ]
]

y = df["purchased_next_30_days"]
مقصد ہے، purchased_next_30_daysدونوں میں نظر آتا ہے۔ X اور y. ماڈل کو ایک جواب دیا جاتا ہے جس کی اسے پیش گوئی کرنی چاہیے۔ آپ بہت زیادہ سکور حاصل کر سکتے ہیں، لیکن اس سکور سے یہ ظاہر نہیں ہوتا ہے کہ ماڈل جائز تاریخی معلومات کی بنیاد پر مستقبل کی خریداریوں کی پیش گوئی کر سکتا ہے۔
یہ براہ راست ہدف لیک کی ایک مثال ہے۔ رساو کی دوسری شکلیں کم واضح ہو سکتی ہیں، جیسے پیشن گوئی کی تاریخ کے بعد جمع کی گئی معلومات کا استعمال کرنا یا پورے ڈیٹاسیٹ کو تربیت اور ٹیسٹ سیٹ میں تقسیم کرنے سے پہلے پہلے سے پروسیس کرنا۔
لیک کو درست کرنا
حل یہ ہے کہ اہداف اور دیگر معلومات کو ان پٹ خصوصیات سے خارج کر دیا جائے جو پیشین گوئی میں استعمال نہیں کی جا سکتیں۔
# Correct: use only information available before prediction.
X = df[
    [
        "past_purchases",
        "website_visits"
    ]
]

y = df["purchased_next_30_days"]
اگلا، ہم ڈیٹا کو تربیت اور ٹیسٹ سیٹ میں تقسیم کرتے ہیں۔
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

model = RandomForestClassifier(
    random_state=42
)

model.fit(
    X_train,
    y_train
)

predictions = model.predict(
    X_test
)

print(
    "Accuracy:",
    accuracy_score(y_test, predictions)
)
یہ مثال زیادہ محفوظ ہے کیونکہ ماڈل صرف دو تاریخی خصوصیات کو حاصل کرتا ہے جس کی وضاحت کی گئی ہے: X. مستقبل کی خریداری کے نتائج وہ مقصد رہتے ہیں جس کی پیشن گوئی ماڈل سیکھتا ہے۔
تاہم، کسی فنکشن سے ہدف کو ہٹانا لیک کو روکنے کا صرف ایک حصہ ہے۔ آپ کو درج ذیل کو بھی چیک کرنا چاہئے: past_purchases اور website_visits پیشن گوئی کی تاریخ سے پہلے ریکارڈ کی گئی معلومات پر مشتمل ہے۔ اگر کسی بھی کالم میں اگلے 30 دن کے نتائج کی مدت کے لیے سرگرمی ہوتی ہے، تب بھی لیک ہو سکتے ہیں۔
پری ٹریٹمنٹ کے دوران رساو کو روکیں۔
رساو اس وقت بھی ہو سکتا ہے جب پری پروسیسنگ ریکارڈز سے معلومات سیکھتی ہے جسے جانچ کے لیے رکھنا ضروری ہے۔ ٹیسٹ سیٹ سے حاصل کردہ معلومات تربیت کے عمل کو متاثر کر سکتی ہیں، مثال کے طور پر، اگر آپ تقسیم کرنے سے پہلے اسکیلنگ کے پیرامیٹرز کی گنتی کرتے ہیں، یا اگر آپ غائب اقدار کو پُر کرنے کے لیے پورے ڈیٹا سیٹ کا استعمال کرتے ہیں۔
ایک محفوظ نمونہ یہ ہے کہ صرف تربیتی ڈیٹا کا استعمال کرتے ہوئے ایک پری پروسیسنگ مرحلے کو فٹ کیا جائے اور پھر سیکھی ہوئی تبدیلی کو ٹیسٹ ڈیٹا پر لاگو کیا جائے۔ اسکِٹ لرن پائپ لائنز اس علیحدگی کو نافذ کرنے میں مدد کر سکتی ہیں۔
وقت پر منحصر پیشین گوئی کے مسائل کے لیے، جب مناسب ہو وقت پر مبنی تقسیم کا استعمال کریں۔ یعنی، یہ پچھلے مشاہدات کا استعمال کرتے ہوئے تربیت دیتا ہے اور بعد کے مشاہدات کا استعمال کرتے ہوئے تشخیص کرتا ہے۔ یہ اس وقت دستیاب معلومات کی بہتر عکاسی کرتا ہے جب مستقبل کے تخمینے لگائے جاتے ہیں۔
عملی لیک چیک لسٹ
ماڈل کی تشخیص پر بھروسہ کرنے سے پہلے، درج ذیل سوالات پوچھیں:
- کیا تمام ان پٹ خصوصیات مطلوبہ پیشین گوئی کے وقت پر دستیاب تھیں؟
- کون سی خصوصیات خود ہدف یا نتیجہ کے لیے براہ راست پراکسی پر مشتمل ہیں؟
- کیا صرف تربیتی ڈیٹا کا استعمال کرتے ہوئے پری پروسیسنگ مرحلہ کافی تھا؟
- کیا ٹرین/ٹیسٹ کی تقسیم اصل پیشین گوئی سیٹ اپ کی عکاسی کرتی ہے؟
- کیا ریکارڈز یا گاہک اس طرح سے تقسیم کیے گئے ہیں جو کارکردگی کو بڑھا سکتے ہیں؟
- کیا اعداد و شمار پر مبنی تشخیصات ہیں جو حقیقت میں نظر نہیں آتے ہیں؟
حیرت انگیز طور پر اعلی سکور خود بخود لیک ہونے کا ثبوت نہیں ہے، لیکن یہ آپ کی صلاحیتوں، ڈیٹا اکٹھا کرنے کے عمل، اور تشخیص کے ڈیزائن کا بغور جائزہ لینے کی ایک وجہ ہے۔
یہاں اہم سبق یہ ہے کہ آپ کو اپنے ماڈل کا اندازہ صرف ان معلومات کا استعمال کرتے ہوئے کرنا چاہیے جس تک آپ کو قانونی طور پر رسائی حاصل ہے جب یہ پیشین گوئیاں کرتا ہے۔ لیک کو روکنے سے اس بات کو یقینی بنانے میں مدد ملتی ہے کہ رپورٹ شدہ کارکردگی مصنوعی طور پر فلائی کی بجائے معنی خیز ہے۔
حصہ 8: مارکیٹنگ انٹیلی جنس سسٹم کی تعمیر
اس مقام پر آپ نے بہت سی انفرادی مہارتیں سیکھی ہیں۔ اب ہم ان کو جوڑ سکتے ہیں۔
ایک مارکیٹنگ انٹیلی جنس نظام صرف غیر متعلقہ Python اسکرپٹس کا مجموعہ نہیں ہونا چاہیے۔ ایک منطقی ورک فلو ہونا چاہیے۔
مرحلہ 1: کاروباری سوال کی وضاحت کریں۔
سسٹم لکھنے سے پہلے، آپ کو اس بات کی وضاحت کرنے کی ضرورت ہے کہ اسے کیا جواب دینے کی ضرورت ہے۔
حتمی فیصلے کے بارے میں، ہم درج ذیل سوالات پوچھیں گے:
- مارکیٹنگ مہمات کتنی آمدنی پیدا کرتی ہیں؟
- کون سے چینلز سب سے زیادہ موثر ہیں؟
- کون سی مہمات بہترین کارکردگی کا مظاہرہ کر رہی ہیں؟
- کن مہمات پر توجہ کی ضرورت ہے؟
- کون سے گاہک سب سے زیادہ قیمتی ہیں؟
- کن صارفین کو دوبارہ مشغولیت کی ضرورت ہو سکتی ہے؟
- وقت کے ساتھ کارکردگی کیسے بدلتی ہے؟
- آپ کے گاہک آپ کے فنل سے کہاں نکل رہے ہیں؟
- کیا آپ کے پاس بامعنی کسٹمر سیگمنٹ ہیں؟
- کیا مشین لرننگ آپ کو ایسے صارفین کی شناخت کرنے میں مدد دے سکتی ہے جو مٹنے کے خطرے میں ہیں؟
- کیا نظام خود بخود رپورٹس بنا سکتا ہے؟
- کیا آپ کا سسٹم آپ کی مارکیٹنگ ٹیم کو مطلع کر سکتا ہے جب اہم میٹرکس تبدیل ہوتے ہیں؟
یہ سوالات آپ کے پروجیکٹ کے فن تعمیر کا تعین کرتے ہیں۔
مرحلہ 2: پروجیکٹ کا ڈھانچہ
ایک عملی پروجیکٹ پر مشتمل ہو سکتا ہے:
marketing_intelligence/
    data/
        raw/
        processed/

    reports/

    notebooks/

    models/

    src/
        data_loader.py
        cleaning.py
        metrics.py
        customer_analysis.py
        campaign_analysis.py
        segmentation.py
        reporting.py
        alerts.py

    tests/

    main.py

    requirements.txt
آپ کو پہلے دن اس پورے ڈھانچے کو بنانے کی ضرورت نہیں ہے۔ مقصد یہ بتانا ہے کہ آخر کار ایک بڑے منصوبے کو کس طرح تشکیل دیا جا سکتا ہے۔
مرحلہ 3: ڈیٹا لوڈنگ ماڈیول
بنانا:
src/data_loader.py
پھر:
import pandas as pd


def load_marketing_data(path):
    return pd.read_csv(path)
اب آپ اسے اپنے مرکزی پروگرام سے درآمد کر سکتے ہیں۔
from src.data_loader import (
    load_marketing_data
)

df = load_marketing_data(
    "data/raw/marketing_data.csv"
)
یہ ڈیٹا لوڈنگ منطق کو تجزیہ منطق سے الگ رکھتا ہے۔
مرحلہ 4: ڈیٹا کلیننگ ماڈیول
بنانا:
src/cleaning.py
پھر:
import pandas as pd


def clean_marketing_data(df):
    df = df.copy()

    df = df.drop_duplicates()

    df["date"] = pd.to_datetime(
        df["date"],
        errors="coerce"
    )

    numeric_columns = [
        "impressions",
        "clicks",
        "conversions",
        "cost",
        "revenue"
    ]

    for column in numeric_columns:
        df[column] = pd.to_numeric(
            df[column],
            errors="coerce"
        )

    df["channel"] = (
        df["channel"]
        .str.strip()
        .str.lower()
    )

    return df
یہ فنکشن عام صفائی کے کام انجام دیتا ہے۔
مرحلہ 5: میٹرکس ماڈیول
بنانا:
src/metrics.py
پھر:
def calculate_metrics(df):
    df = df.copy()

    df["ctr"] = (
        df["clicks"]
        .div(
            df["impressions"]
            .replace(0, None)
        )
        .mul(100)
    )

    df["conversion_rate"] = (
        df["conversions"]
        .div(
            df["clicks"]
            .replace(0, None)
        )
        .mul(100)
    )

    df["cpc"] = (
        df["cost"]
        .div(
            df["clicks"]
            .replace(0, None)
        )
    )

    df["cpa"] = (
        df["cost"]
        .div(
            df["conversions"]
            .replace(0, None)
        )
    )

    df["roas"] = (
        df["revenue"]
        .div(
            df["cost"]
            .replace(0, None)
        )
    )

    return df
اب آپ دوبارہ قابل استعمال جگہ پر حسابات کر سکتے ہیں۔
مرحلہ 6: مہم کا تجزیہ ماڈیول
بنانا:
src/campaign_analysis.py
پھر:
def analyze_campaigns(df):
    summary = (
        df.groupby("campaign")
        .agg({
            "impressions": "sum",
            "clicks": "sum",
            "conversions": "sum",
            "cost": "sum",
            "revenue": "sum"
        })
    )

    summary["roas"] = (
        summary["revenue"] /
        summary["cost"]
    )

    summary["cpa"] = (
        summary["cost"] /
        summary["conversions"]
    )

    return summary.sort_values(
        "roas",
        ascending=False
    )
یہ دوبارہ قابل استعمال مہم کی کارکردگی کی میز بناتا ہے۔
مرحلہ 7: چینل کا تجزیہ
def analyze_channels(df):
    summary = (
        df.groupby("channel")
        .agg({
            "impressions": "sum",
            "clicks": "sum",
            "conversions": "sum",
            "cost": "sum",
            "revenue": "sum"
        })
    )

    summary["roas"] = (
        summary["revenue"] /
        summary["cost"]
    )

    summary["cpa"] = (
        summary["cost"] /
        summary["conversions"]
    )

    return summary.sort_values(
        "roas",
        ascending=False
    )
مہم کے تجزیات اور چینل کے تجزیات کو اب الگ کر دیا گیا ہے۔ یہ آپ کے پروجیکٹ کو برقرار رکھنے میں آسان بنائے گا۔
مرحلہ 8: کم کارکردگی دکھانے والی مہمات کا پتہ لگائیں۔
دوبارہ قابل استعمال اصول بنائیں۔
def identify_underperforming_campaigns(
    campaign_summary,
    roas_threshold=1,
    conversion_threshold=2
):
    return campaign_summary[
        (campaign_summary["roas"] < roas_threshold) &
        (
            campaign_summary["conversion_rate"]
            < conversion_threshold
        )
    ]
لیکن کیا آپ کو کوئی مسئلہ ملا؟ مہم کا خلاصہ فی الحال تبادلوں کی شرحوں کا حساب نہیں لگاتا ہے۔
یہ ایک اچھی مثال ہے کہ سافٹ ویئر بنانے کے لیے مفروضے کی جانچ کی ضرورت کیوں ہے۔
آپ سمری میں ترمیم کر سکتے ہیں۔
def analyze_campaigns(df):
    summary = (
        df.groupby("campaign")
        .agg({
            "impressions": "sum",
            "clicks": "sum",
            "conversions": "sum",
            "cost": "sum",
            "revenue": "sum"
        })
    )

    summary["conversion_rate"] = (
        summary["conversions"] /
        summary["clicks"] *
        100
    )

    summary["roas"] = (
        summary["revenue"] /
        summary["cost"]
    )

    summary["cpa"] = (
        summary["cost"] /
        summary["conversions"]
    )

    return summary.sort_values(
        "roas",
        ascending=False
    )
یہ ترقی کی ایک اہم عادت ہے۔ اس کے اوپر اگلا قدم بنانے سے پہلے ہر قدم کی جانچ کریں۔
مرحلہ 9: کسٹمر انٹیلی جنس پرت بنائیں
گاہک کے درجہ بندی کو گاہک کی سطح کے رویے کا خلاصہ کرنا چاہیے۔
def analyze_customers(df):
    summary = (
        df.groupby("customer_id")
        .agg({
            "revenue": "sum",
            "conversions": "sum",
            "campaign": "count"
        })
        .rename(
            columns={
                "campaign":
                "purchase_activity"
            }
        )
    )

    summary["average_order_value"] = (
        summary["revenue"] /
        summary["purchase_activity"]
    )

    return summary
یہ نظام کو کسٹمر کی سطح کا نقطہ نظر فراہم کرتا ہے۔
مرحلہ 10: اعلی قیمت والے صارفین کی شناخت کریں۔
آپ آسان اصول بنا سکتے ہیں۔
def identify_high_value_customers(
    customer_summary,
    threshold=5000
):
    return customer_summary[
        customer_summary["revenue"]
        >= threshold
    ]
ایک بار پھر، حد آفاقی نہیں ہے.
$5,000 کی حد ایک کمپنی کے لیے مناسب اور دوسری کے لیے اشتعال انگیز ہو سکتی ہے۔
ایک مضبوط مارکیٹنگ انٹیلی جنس نظام آپ کو اہم حدوں کو ترتیب دینے کی اجازت دیتا ہے۔
مرحلہ 11: تجویز کرنے والا انجن
اب آپ سفارشات دے سکتے ہیں۔
def generate_channel_recommendation(
    row
):
    if row["roas"] >= 4:
        return (
            "Strong performance. "
            "Investigate opportunities "
            "to scale efficiently."
        )

    if row["roas"] >= 2:
        return (
            "Moderate performance. "
            "Continue monitoring and "
            "test optimization opportunities."
        )

    return (
        "Low return. Review targeting, "
        "creative, costs, and conversion "
        "performance before increasing spend."
    )
درخواست دیں:
channel_summary[
    "recommendation"
] = channel_summary.apply(
    generate_channel_recommendation,
    axis=1
)
یہ بنیادی اصول پر مبنی انٹیلی جنس پرت ہے۔
ازگر کامل مارکیٹنگ کی حکمت عملی کو جاننے کا بہانہ نہیں کرتا۔
اس کے بجائے، یہ پہلے سے طے شدہ تجزیہ کی شرائط کو انسانی فیصلہ سازوں کے لیے مفید اشارے میں ترجمہ کرتا ہے۔
کیپ اسٹون پروجیکٹ: ازگر کی مارکیٹنگ انٹیلی جنس پلیٹ فارم کی تعمیر
کیپ اسٹون پروجیکٹ حتمی ایپلی کیشن ہے جو پوری کتاب کو ایک ساتھ جوڑتی ہے۔
آپ ایک ازگر پر مبنی نظام بنائیں گے جو خام مارکیٹنگ ڈیٹا لے سکتا ہے اور اسے ساختی انٹیلی جنس رپورٹس میں تبدیل کر سکتا ہے۔
مکمل نظام کو یکجا کرتا ہے:
- ازگر کی بنیادی باتیں
- پانڈا
- ڈیٹا کی صفائی
- مارکیٹنگ KPIs
- مہم کے تجزیات
- چینل تجزیہ
- کسٹمر تجزیہ
- آر ایف ایم سیگمنٹیشن
- کوہورٹ تجزیہ
- فنل کا تجزیہ
- تصویر
- خودکار اطلاع
- مشین لرننگ
- رپورٹ بنائیں
- آٹومیشن
مقصد ایک فرضی 'AI مارکیٹنگ پلیٹ فارم' بنانا نہیں ہے جو جادوئی طور پر جانتا ہے کہ صارفین کیا چاہتے ہیں۔ مقصد ایک حقیقت پسندانہ تجزیاتی پائپ لائن بنانا ہے۔
کیپ اسٹون گول
نظام کو مندرجہ ذیل جواب دینے کے قابل ہونا چاہئے:
"آپ کے مارکیٹنگ کے اعداد و شمار میں کیا ہو رہا ہے، کن شعبوں پر توجہ کی ضرورت ہے، اور آپ اپنے اگلے فیصلوں کی حمایت کے لیے کیا ثبوت فراہم کر سکتے ہیں؟"
یہ پورے منصوبے کا بنیادی سوال ہے۔
مرحلہ 1: ڈیٹاسیٹ بنائیں
تربیتی مقاصد کے لیے، آپ مصنوعی ڈیٹا تیار کر سکتے ہیں جیسے:
import random
import pandas as pd

random.seed(42)

campaigns = [
    "Spring Sale",
    "Summer Sale",
    "Back to School",
    "Holiday Sale"
]

channels = [
    "Email",
    "Search",
    "Social Media",
    "Display"
]

rows = []

for _ in range(5000):
    impressions = random.randint(
        1000,
        50000
    )

    clicks = random.randint(
        20,
        5000
    )

    conversions = random.randint(
        0,
        500
    )

    cost = round(
        random.uniform(
            100,
            5000
        ),
        2
    )

    revenue = round(
        random.uniform(
            100,
            15000
        ),
        2
    )

    rows.append({
        "customer_id": random.randint(
            1,
            1000
        ),
        "campaign": random.choice(
            campaigns
        ),
        "channel": random.choice(
            channels
        ),
        "impressions": impressions,
        "clicks": clicks,
        "conversions": conversions,
        "cost": cost,
        "revenue": revenue
    })

df = pd.DataFrame(rows)

df.to_csv(
    "marketing_data.csv",
    index=False
)
یہ ایک ابتدائی ڈیٹا سیٹ فراہم کرتا ہے۔
مرحلہ 2: ڈیٹا لوڈ کریں۔
df = pd.read_csv(
    "marketing_data.csv"
)
فوری معائنہ کریں۔
print(df.head())
print(df.shape)
print(df.info())
مرحلہ 3: ڈیٹا کی تصدیق
گمشدہ اقدار کی جانچ کریں۔
print(
    df.isnull().sum()
)
نقلیں چیک کریں:
print(
    df.duplicated().sum()
)
چینلز دیکھیں:
print(
    df["channel"].value_counts()
)
مہم دیکھیں:
print(
    df["campaign"].value_counts()
)
مقصد یہ سمجھنا ہے کہ سسٹم میں کیا داخل ہے۔
مرحلہ 4: اپنا ڈیٹا صاف کریں۔
df = df.drop_duplicates()

numeric_columns = [
    "impressions",
    "clicks",
    "conversions",
    "cost",
    "revenue"
]

for column in numeric_columns:
    df[column] = pd.to_numeric(
        df[column],
        errors="coerce"
    )

df["channel"] = (
    df["channel"]
    .str.strip()
    .str.lower()
)
ڈیٹا اب تجزیاتی پرت کے لیے تیار ہے۔
مرحلہ 5: KPIs کا حساب لگائیں۔
df["ctr"] = (
    df["clicks"] /
    df["impressions"] *
    100
)

df["conversion_rate"] = (
    df["conversions"] /
    df["clicks"] *
    100
)

df["cpc"] = (
    df["cost"] /
    df["clicks"]
)

df["cpa"] = (
    df["cost"] /
    df["conversions"]
)

df["roas"] = (
    df["revenue"] /
    df["cost"]
)
پروڈکشن ورژن میں، تمام حصوں کو صفر اقدار سے محفوظ رکھنا ضروری ہے۔
مرحلہ 6: ایک چینل رپورٹ بنائیں
channel_summary = (
    df.groupby("channel")
    .agg({
        "impressions": "sum",
        "clicks": "sum",
        "conversions": "sum",
        "cost": "sum",
        "revenue": "sum"
    })
)
پھر:
channel_summary["ctr"] = (
    channel_summary["clicks"] /
    channel_summary["impressions"] *
    100
)

channel_summary["conversion_rate"] = (
    channel_summary["conversions"] /
    channel_summary["clicks"] *
    100
)

channel_summary["roas"] = (
    channel_summary["revenue"] /
    channel_summary["cost"]
)

channel_summary["cpa"] = (
    channel_summary["cost"] /
    channel_summary["conversions"]
)
صف:
channel_summary = (
    channel_summary
    .sort_values(
        "roas",
        ascending=False
    )
)
مرحلہ 7: مہم کی رپورٹ بنائیں
campaign_summary = (
    df.groupby("campaign")
    .agg({
        "impressions": "sum",
        "clicks": "sum",
        "conversions": "sum",
        "cost": "sum",
        "revenue": "sum"
    })
)
پھر حساب لگائیں:
campaign_summary["ctr"] = (
    campaign_summary["clicks"] /
    campaign_summary["impressions"] *
    100
)

campaign_summary["conversion_rate"] = (
    campaign_summary["conversions"] /
    campaign_summary["clicks"] *
    100
)

campaign_summary["roas"] = (
    campaign_summary["revenue"] /
    campaign_summary["cost"]
)

campaign_summary["cpa"] = (
    campaign_summary["cost"] /
    campaign_summary["conversions"]
)
اب آپ کارکردگی کے لحاظ سے اپنی مہمات کی درجہ بندی کر سکتے ہیں۔
campaign_summary.sort_values(
    "roas",
    ascending=False
)
مرحلہ 8: کسٹمر رپورٹ بنائیں
customer_summary = (
    df.groupby("customer_id")
    .agg({
        "revenue": "sum",
        "conversions": "sum",
        "campaign": "count"
    })
)
سرگرمی کالم کا نام تبدیل کریں۔
customer_summary = (
    customer_summary
    .rename(
        columns={
            "campaign":
            "purchase_activity"
        }
    )
)
اوسط قدر کا حساب لگائیں:
customer_summary[
    "average_order_value"
] = (
    customer_summary["revenue"] /
    customer_summary[
        "purchase_activity"
    ]
)
مرحلہ 9: کسٹمر سیگمنٹیشن
RFM طرز کی پیمائش بنائیں۔
rfm = customer_summary.copy()

rfm["frequency"] = (
    rfm["purchase_activity"]
)

rfm["monetary"] = (
    rfm["revenue"]
)
اگر آپ کے ڈیٹاسیٹ میں حقیقی خریداری کی تاریخیں شامل ہیں تو تازہ کاری شامل کریں۔
today = pd.Timestamp(
    "2026-09-05"
)

last_purchase = (
    df.groupby("customer_id")[
        "purchase_date"
    ].max()
)

rfm["recency"] = (
    today -
    last_purchase
).dt.days
اس کے بعد ہم اپنے صارفین کی درجہ بندی کرتے ہیں۔
rfm["monetary_score"] = pd.qcut(
    rfm["monetary"],
    5,
    labels=False,
    duplicates="drop"
) + 1
اسی تصور کو تعدد اور تجدید پر لاگو کیا جا سکتا ہے۔
مرحلہ 10: گاہک کے حصے بنائیں
آپ سادہ ایکشن گروپس کی وضاحت کر سکتے ہیں۔
مثال کے طور پر:
def classify_customer(row):
    if (
        row["monetary"] >= 5000 and
        row["frequency"] >= 5
    ):
        return "High Value"

    if row["frequency"] >= 5:
        return "Frequent"

    if row["monetary"] >= 5000:
        return "High Spending"

    return "Developing"
پھر:
rfm["segment"] = (
    rfm.apply(
        classify_customer,
        axis=1
    )
)
خلاصہ:
segment_summary = (
    rfm.groupby("segment")
    .agg({
        "monetary": "mean",
        "frequency": "mean"
    })
)
اب آپ کی مارکیٹنگ ٹیم ہر طبقہ کی خصوصیات دیکھ سکتی ہے۔
مرحلہ 11: اپنا فنل بنائیں
اپنے ڈیٹا سیٹ میں فنل کی معلومات شامل کریں۔
مثال کے طور پر:
funnel = {
    "Visitors": 50000,
    "Product Views": 32000,
    "Cart Adds": 9000,
    "Checkouts": 4500,
    "Purchases": 2700
}
مرحلہ وار تبدیلی کا حساب کتاب:
funnel_rates = {}

previous = None

for stage, value in funnel.items():

    if previous is None:
        funnel_rates[stage] = 100
    else:
        funnel_rates[stage] = (
            value /
            previous *
            100
        )

    previous = value
یہ ایک سادہ فنل تجزیہ بناتا ہے۔
مرحلہ 12: ایک تصور بنائیں
چینل کے ذریعہ آمدنی:
import matplotlib.pyplot as plt

channel_summary[
    "revenue"
].plot(
    kind="bar"
)

plt.title(
    "Revenue by Marketing Channel"
)

plt.xlabel("Channel")
plt.ylabel("Revenue")

plt.tight_layout()
plt.show()
ROAS بذریعہ چینل:
channel_summary[
    "roas"
].plot(
    kind="bar"
)

plt.title(
    "ROAS by Marketing Channel"
)

plt.xlabel("Channel")
plt.ylabel("ROAS")

plt.tight_layout()
plt.show()
کسٹمر ویلیو کی تقسیم:
plt.hist(
    rfm["monetary"],
    bins=30
)

plt.title(
    "Customer Monetary Value"
)

plt.xlabel("Customer Revenue")
plt.ylabel("Customers")

plt.tight_layout()
plt.show()
مرحلہ 13: کارکردگی کے انتباہات تیار کریں۔
آئیے کہتے ہیں کہ 1 سے کم ROAS کو وارننگ سمجھا جاتا ہے۔
alerts = []

for channel, row in (
    channel_summary.iterrows()
):

    if row["roas"] < 1:
        alerts.append(
            f"{channel}: ROAS is below 1."
        )
ایک انتباہ دکھاتا ہے۔
for alert in alerts:
    print(alert)
آپ تبادلوں کی شرح یا آمدنی میں اچانک تبدیلیوں کی نشاندہی کرنے کے قابل بھی ہو سکتے ہیں۔
مرحلہ 14: سفارشات تیار کریں۔
recommendations = []

for channel, row in (
    channel_summary.iterrows()
):

    if row["roas"] >= 4:
        recommendations.append(
            f"{channel}: Strong ROAS. "
            "Investigate whether the channel "
            "can be scaled efficiently."
        )

    elif row["roas"] < 1:
        recommendations.append(
            f"{channel}: ROAS is below break-even. "
            "Review targeting, creative, "
            "costs, and conversion performance."
        )

    else:
        recommendations.append(
            f"{channel}: Moderate performance. "
            "Continue testing and optimization."
        )
یہ حتمی رپورٹ کو تشریح کی ایک پرت فراہم کرتا ہے۔
مرحلہ 15: مشین لرننگ شامل کریں۔
آپ کے تجزیاتی نظام کے فعال ہونے کے بعد، آپ پیشین گوئی کی تہیں شامل کر سکتے ہیں۔
فرض کریں کہ آپ کے ڈیٹا سیٹ پر مشتمل ہے: churned گرمی
خصوصیات منتخب کریں:
features = [
"purchase_frequency",
"total_spend",
"email_opens",
"website_sessions"
]
X = df[features]
y = df["churned"]
تقسیم:
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = (
train_test_split(
X,
y,
test_size=0.2,
random_state=42
)
)
ٹرین:
from sklearn.linear_model import LogisticRegression
model = LogisticRegression(
max_iter=1000
)
model.fit(
X_train,
y_train
)
پیشن گوئی:
predictions = model.predict(
X_test
)
اندازہ لگانا:
from sklearn.metrics import classification_report
print(
classification_report(
y_test,
predictions
)
)
اب ماڈل ذہانت کی ایک اضافی پرت بن جاتا ہے۔
مرحلہ 16: رپورٹ برآمد کریں۔
with pd.ExcelWriter(
"marketing_intelligence_report.xlsx"
) as writer:
df.to_excel(
writer,
sheet_name="Processed Data",
index=False
)
channel_summary.to_excel(
writer,
sheet_name="Channels"
)
campaign_summary.to_excel(
writer,
sheet_name="Campaigns"
)
customer_summary.to_excel(
writer,
sheet_name="Customers"
)
rfm.to_excel(
writer,
sheet_name="Segments"
)
سسٹم اب دوبارہ قابل استعمال رپورٹس تیار کرتا ہے۔
مرحلہ 17: پروجیکٹ کو پائپ لائن میں تبدیل کریں۔
آخری مرحلہ ہر چیز کو یکجا کرنا ہے۔
بنیادی پروگرام کو تصوراتی طور پر اس طرح ختم کرنا چاہئے:
from src.data_loader import (
load_marketing_data
)
from src.cleaning import (
clean_marketing_data
)
from src.metrics import (
calculate_metrics
)
from src.campaign_analysis import (
analyze_campaigns
)
from src.channel_analysis import (
analyze_channels
)
from src.customer_analysis import (
analyze_customers
)
def main():
df = load_marketing_data(
"data/raw/marketing_data.csv"
)
df = clean_marketing_data(df)
df = calculate_metrics(df)
campaigns = analyze_campaigns(
df
)
channels = analyze_channels(
df
)
customers = analyze_customers(
df
)
print(
"Marketing intelligence analysis "
"completed."
)
if __name__ == "__main__":
main()
یہ وہ سمت ہے جسے ہم Capstone تک پہنچنا چاہتے ہیں۔
سیکڑوں الگ الگ خلیات پر مشتمل ایک بڑے لیپ ٹاپ کی بجائے، نظام دوبارہ قابل استعمال اجزاء کا مجموعہ بن جاتا ہے۔
اس کو مارکیٹنگ انٹیلی جنس سسٹم کیا بناتا ہے؟
اس وقت یہ ایک قدم پیچھے ہٹنے کے قابل ہو سکتا ہے۔ ہم نے صرف رپورٹ نہیں بنائی۔ یہ نظام متعدد کام انجام دے سکتا ہے، بشمول:
- ڈیٹا اکٹھا کرنا
- ڈیٹا کی تصدیق
- ڈیٹا کی صفائی
- ڈیٹا کی تبدیلی
- کے پی آئی کا حساب کتاب
- چینل تجزیہ
- مہم کے تجزیات
- کسٹمر تجزیہ
- سیگمنٹ کسٹمر
- آمد کا معائنہ
- مسئلہ کا پتہ لگانا
- سفارشات بنائیں
- پیشن گوئی ماڈل چلائیں۔
- رپورٹ برآمد کریں۔
یہ مجموعہ ہے جو آپ کے پروجیکٹ کو صرف ایک تجزیہ اسکرپٹ کے بجائے ایک انٹیلی جنس سسٹم بناتا ہے۔
نظام خام معلومات لیتا ہے اور اس معلومات کو فیصلوں میں بدلنے کے لیے ایک منظم عمل تخلیق کرتا ہے۔
جو نظام ابھی تک نہیں کر سکتا
یہاں تک کہ جدید ترین مارکیٹنگ انٹیلی جنس سسٹم کی بھی حدود ہیں۔
- آپ اپنی مہم کے کامیاب ہونے کی تمام وجوہات کو خود بخود نہیں سمجھ سکتے۔
- آپ کبھی نہیں جانتے کہ آیا کوئی گاہک صرف اس وجہ سے مطمئن ہے کہ اس نے خریداری کی۔
- ہم اس بات کی ضمانت نہیں دے سکتے کہ مشین لرننگ کی پیشین گوئیاں درست ہوں گی۔
- آپ کاروباری سیاق و سباق کے بغیر کامل مارکیٹنگ کی حکمت عملی کا تعین نہیں کر سکتے۔
- مارکیٹرز کے لیے کوئی متبادل نہیں ہے۔
اس کے بجائے، یہ ثبوت فراہم کرتا ہے. یہ فرق اس منصوبے کے مرکز میں رہنا چاہیے۔
آخری چیلنج
ایک بار جب آپ بنیادی Capstone مکمل کر لیتے ہیں، تو اسے بہتر بنانے کے بہت سے طریقے ہیں۔ آپ کر سکتے ہیں:
- ڈیٹا بیس شامل کریں۔
- API کنکشن
- خودکار شیڈول شامل کریں۔
- ڈیش بورڈ بنائیں
- کوہورٹ تجزیہ شامل کریں۔
- بہتر RFM سیگمنٹیشن
- چرن ماڈل ٹریننگ
- ماڈل کی تشخیص شامل کریں۔
- خودکار اطلاعات بنائیں
- پی ڈی ایف رپورٹ بنائیں
- منظور شدہ اطلاعات بھیجیں۔
- یونٹ ٹیسٹ شامل کریں۔
- ایک کنفیگریشن فائل بنائیں تاکہ آپ سورس کوڈ میں ترمیم کیے بغیر حد کو تبدیل کر سکیں۔
بالآخر، پروجیکٹ کچھ ایسا ہونا چاہیے جو درحقیقت اندرونی مارکیٹنگ کے تجزیاتی ٹول کی بنیاد کے طور پر کام کر سکے۔
Capstone کا اصل مقصد یہی ہے۔ یہ ظاہر کرتا ہے کہ پوری کتاب میں سیکھی گئی انفرادی مہارتوں کو ایک مربوط نظام میں ملایا جا سکتا ہے۔
نتیجہ / اگلے اقدامات
مارکیٹنگ کے لیے Python سیکھنے کا لازمی طور پر مطلب یہ نہیں ہے کہ آپ کو Python کو حفظ کرنا ہوگا۔ اس کا مطلب صرف یہ ہے کہ آپ کو مارکیٹنگ کے مسائل کے بارے میں مختلف طریقے سے سوچنا سیکھنا ہوگا۔
اسپریڈ شیٹس آپ کو بتا سکتی ہیں کہ کیا ہوا، لیکن ازگر آپ کو اس کی وجہ جاننے میں مدد کر سکتا ہے۔ تجزیاتی ڈیش بورڈ سیلز میں کمی کو ظاہر کر سکتا ہے، لیکن ایک Python ورک فلو آپ کو یہ تعین کرنے میں مدد کر سکتا ہے کہ کون سا چینل، مہم، کسٹمر سیگمنٹ، یا ٹائم پیریڈ اس تبدیلی میں معاون ہے۔ دستی رپورٹیں ماضی کا خلاصہ کر سکتی ہیں، لیکن خودکار انٹیلی جنس سسٹم مسلسل نگرانی کر سکتا ہے کہ اب کیا ہو رہا ہے اور کسی کی توجہ میں اہم تبدیلیاں لا سکتے ہیں۔
یہ ترقی ایک حقیقی موقع ہے۔
کیپ اسٹون سے آگے جاری رکھیں
حتمی منصوبہ حتمی منصوبہ نہیں ہونا چاہئے۔ یہ ایک ایسا پروجیکٹ ہونا چاہیے جو آپ کو اپنا اگلا پروجیکٹ بنانے کے لیے کافی اعتماد فراہم کرے۔
سسٹم کو توڑیں، اس کی تمام خصوصیات کو سمجھیں، میٹرکس کو تبدیل کریں، اور جان بوجھ کر کوڈ کو توڑ دیں۔
مختلف ڈیٹا سیٹس کو آزمائیں، خصوصیات شامل کریں، خصوصیات کو ہٹا دیں۔
اپنے مفروضوں کی جانچ کریں اور دوبارہ تعمیر کریں۔ مقصد یہ ہے کہ آپ نئے مسائل کو حل کرنے کی صلاحیت پیدا کریں۔
ایک مارکیٹنگ تجزیہ پورٹ فولیو کی تعمیر
جیسے جیسے آپ Python کے ساتھ زیادہ آرام دہ ہو جاتے ہیں، کئی چھوٹے پروجیکٹس بنانے پر غور کریں۔
مثال کے طور پر:
- مہم کی کارکردگی کا تجزیہ کار: ایک ایسا پروگرام بنائیں جو مہم کا ڈیٹا لے اور خود بخود KPIs کا حساب لگائے۔
- کسٹمر سیگمنٹیشن ٹولز: ایک RFM تجزیہ نظام بنائیں جو صارفین کو ان کے رویے کی بنیاد پر درجہ بندی کرے۔
- مارکیٹنگ فنل تجزیہ کار: تجزیہ کریں کہ صارفین تبادلوں کے عمل سے کہاں نکل جاتے ہیں۔
- A/B ٹیسٹنگ کیلکولیٹر: دو تجرباتی گروپس کا موازنہ کرنے اور متعلقہ شماریاتی اقدامات کی اطلاع دینے کے لیے ایک ٹول بنائیں۔
- مارکیٹنگ رپورٹ جنریٹر: خودکار طور پر بار بار چلنے والی مارکیٹنگ رپورٹس بنائیں۔
- گاہک کے منھ کی پیشن گوئی کرنے والا: ایک مشین لرننگ ماڈل کو تربیت دیں تاکہ گاہکوں کی نشاندہی کی جا سکے جو مٹانے کے خطرے میں ہیں۔
ہر پروجیکٹ ایک مختلف مہارت کا مظاہرہ کرتا ہے۔ لیکن وہ مل کر ایک پورٹ فولیو بناتے ہیں جو دکھاتا ہے کہ آپ Python نحو سے زیادہ سمجھتے ہیں۔
اپنے کاروباری سوالات کو پہلے رکھیں
ہنر سیکھتے وقت سب سے آسان غلطیوں میں سے ایک ٹولز سے شروع کرنا ہے۔
آپ سوچ رہے ہوں گے، "میں نے پانڈا سیکھا ہے۔ میں پانڈوں کے ساتھ کیا کر سکتا ہوں؟"
اس کے بجائے، سوالات پوچھیں جیسے: "پانڈا مارکیٹنگ کے کن مسائل کو حل کرنے میں مدد کر سکتا ہے؟"
یہی بات مشین لرننگ پر بھی لاگو ہوتی ہے۔
یہ کہہ کر شروع نہ کریں کہ "میں مشین لرننگ استعمال کرنا چاہتا ہوں۔"
اس کے ساتھ شروع کریں، "مجھے یہ پیشین گوئی کرنے کی ضرورت ہے کہ کون سے گاہک ممکنہ طور پر منتشر ہوں گے۔"
پھر اس بات کا تعین کریں کہ آیا مشین لرننگ دراصل مناسب ہے۔
ٹیکنالوجی کو اس مسئلے کی حمایت کرنی چاہیے۔ مسئلہ صرف ٹیکنالوجی کا جواز پیش کرنے کے لیے موجود نہیں ہونا چاہیے۔
ڈیٹا لٹریسی ایک مارکیٹنگ کی مہارت ہے۔
ڈیٹا لٹریسی سے فائدہ اٹھانے کے لیے آپ کو ڈیٹا سائنسدان بننے کی ضرورت نہیں ہے۔
آپ سوالات پوچھنے میں آرام محسوس کر سکتے ہیں جیسے:
- یہ نمبر کہاں سے آتا ہے؟
- یہ میٹرک بالکل کیا پیمائش کرتا ہے؟
- فرق کیا ہے؟
- ڈیٹا کیسے اکٹھا کیا گیا؟
- کیا غائب ہے؟
- کیا تعصب ہو سکتا ہے؟
- کیا یہ تعلق ہے یا وجہ؟
- کیا نمونہ کافی بڑا ہے؟
- کیا یہ نتائج واقعی آپ کے کاروبار کے لیے اہم ہیں؟
یہ سوالات اکثر دیگر Python لائبریریوں کو جاننے سے زیادہ اہم ہوتے ہیں۔
ازگر افادیت فراہم کرتا ہے۔
مارکیٹرز جو دستی طور پر ڈیٹا سیٹ کا تجزیہ کر سکتے ہیں تجزیات تیار کر سکتے ہیں۔ لیکن مارکیٹرز جو Python لکھ سکتے ہیں ممکنہ طور پر اس تجزیے کو دوبارہ قابل استعمال عمل میں تبدیل کر سکتے ہیں۔
ایک رپورٹ کا تجزیہ کرنے کے بجائے، آپ سینکڑوں رپورٹس کا تجزیہ کر سکتے ہیں۔ میٹرکس کو دستی طور پر شمار کرنے کے بجائے، آپ فنکشنز بنا سکتے ہیں۔ ہر صبح دستی طور پر کارکردگی کو چیک کرنے کے بجائے، آپ خودکار نگرانی کا نظام بنا سکتے ہیں۔ جو کچھ ہوا اس کی محض اطلاع دینے کے بجائے، آپ ایسے ماڈل بنا سکتے ہیں جو اس بات کی پیشین گوئی کرنے میں مدد کریں کہ آگے کیا ہوگا۔
یہ لیوریج ہے۔
مارکیٹنگ تجزیات کا مستقبل
مارکیٹنگ ٹیکنالوجی بدلتی رہے گی، نئے پلیٹ فارمز ابھریں گے، اور موجودہ APIs بدلیں گے۔
مشین لرننگ کے ماڈلز بہتر ہوں گے، اور مصنوعی ذہانت تیزی سے مارکیٹنگ کے کام کے بہاؤ میں ضم ہو جائے گی۔
لیکن بنیادی مہارتیں جیسے ڈیٹا کو سمجھنا، اچھے سوالات پوچھنا، تجربات کو ڈیزائن کرنا، نتائج کی ترجمانی کرنا، قابل اعتماد کوڈ لکھنا، بصیرت کا اظہار کرنا، پیشین گوئیوں کے بارے میں تنقیدی سوچنا، اور گاہک کی معلومات کی حفاظت کرنا اب بھی قیمتی ہیں۔
یہ ٹیکنالوجیز ایک مخصوص پلیٹ فارم سے منسلک نہیں ہیں۔
حتمی خیالات
Python استعمال کرنے سے پہلے آپ کو پروگرامر بننے کی ضرورت نہیں ہے۔ ایک مسئلہ کے ساتھ شروع کریں، ڈیٹا تلاش کریں، ایک چھوٹا پروگرام لکھیں، غلطیاں کریں، اور انہیں ٹھیک کریں۔ پھر پروگرام کو بہتر بنانے کی کوشش کریں۔
آخر کار، یہ چھوٹے پروگرام ورک فلو بن جاتے ہیں، اور یہ ورک فلو سسٹم بن جاتے ہیں، اور یہ سسٹمز آپ کے صارفین کو سمجھنے، آپ کی مہمات کو بہتر بنانے، دہرائے جانے والے کاموں کو خودکار بنانے اور بہتر فیصلے کرنے کے لیے طاقتور ٹولز ہو سکتے ہیں۔
ازگر ٹول ہے، مارکیٹنگ سیاق و سباق ہے، اور ڈیٹا ثبوت ہے۔ اصل ہنر تینوں کو جوڑنا ہے۔
مبارک کوڈنگ!