
اگر آپ ڈیٹا کے تجزیہ میں نئے ہیں، تو یہ پیچیدہ معلوم ہو سکتا ہے۔ آپ بڑے ڈیٹا بیس، جدید ریاضی، اور پیچیدہ مشین لرننگ الگورتھم کا تصور کر سکتے ہیں۔
لیکن ڈیٹا کے تجزیہ کے بہت سے مفید کام کچھ آسان سے شروع ہوتے ہیں: ڈیٹا سیٹ لوڈ کرنا، اس کے بارے میں سوال پوچھنا، اور ازگر کا استعمال کرتے ہوئے جواب تلاش کرنا۔
اس ٹیوٹوریل میں، ہم Python اور Pandas کا استعمال کرتے ہوئے ایک سادہ ڈیٹا اینالائزر بناتے ہیں۔ فرضی طالب علم کی کارکردگی کے ڈیٹاسیٹ کا استعمال کرتے ہوئے، آپ سیکھیں گے کہ ڈیٹا کیسے لوڈ کرنا، معائنہ کرنا، شماریات شمار کرنا، فلٹر ریکارڈز، گروپ کی معلومات، اور بنیادی تصورات بنانا۔
آخر میں، آپ کے پاس مختلف قسم کے CSV ڈیٹا سیٹس کا تجزیہ کرنے کے لیے دوبارہ قابل استعمال بنیاد ہوگی۔
شرائط
اس ٹیوٹوریل پر عمل کرنے سے پہلے، آپ کو ازگر کی کچھ بنیادی مہارتیں اور ٹولز کی ضرورت ہوگی۔ آپ کو جدید پروگرامنگ یا ڈیٹا تجزیہ کے تجربے کی ضرورت نہیں ہے، لیکن آپ کو درج ذیل سے واقف ہونا چاہیے:
- Python متغیرات اور ڈیٹا کی ابتدائی اقسام جیسے تار اور نمبر۔
- لائبریریوں کو درآمد کرنا اور فنکشنز کال کرنا۔
- ڈیٹا پر بنیادی آپریشنز کی فہرست اور آپریشن۔
اگر آپ Python میں نئے ہیں، تو ہم جاری رکھنے سے پہلے یہ بنیادی باتیں سیکھنے کی تجویز کرتے ہیں۔ اگر آپ گہرائی میں جانا چاہتے ہیں، تو ہمارے پاس شروع کرنے میں آپ کی مدد کے لیے ایک انٹرایکٹو Python کورس ہے۔
یہ بھی یقینی بنائیں کہ آپ کے پاس درج ذیل انسٹال ہیں:
- ازگر: Python 3 یا ایک ہم آہنگ Python انسٹالیشن۔
- پانڈا: ڈیٹا کو لوڈ کرنے، فلٹر کرنے، گروپ بندی کرنے اور تجزیہ کرنے کے لیے استعمال کرنے کے لیے ایک Python لائبریری۔
- Matplotlib: تصورات تخلیق کرنے کے لیے استعمال کرنے کے لیے لائبریری۔
- کوڈ ایڈیٹر یا IDE: ٹرمینل تک رسائی کے ساتھ، VS Code، PyCharm، یا ایک سادہ ٹیکسٹ ایڈیٹر جیسی چیزیں۔
آپ اپنے ٹرمینل میں درج ذیل کمانڈ کو چلا کر پانڈوں اور میٹپلوٹلیب کو انسٹال کر سکتے ہیں۔
pip install pandas matplotlib
اس کے علاوہ، ازگر اسکرپٹ اور students.csv یہ وہ ڈیٹاسیٹ ہے جسے ہم اس ٹیوٹوریل میں بنائیں گے۔
ایک بار جب سب کچھ تیار ہو جائے تو، آپ Python کے ساتھ اپنے ڈیٹا کا تجزیہ شروع کر سکتے ہیں!
ہم کیا احاطہ کریں گے:
ترجیحات
پانڈوں کی تنصیب
اگر آپ نے ابھی تک پانڈا انسٹال نہیں کیا ہے، تو ٹرمینل کھولیں اور چلائیں:
pip install pandas matplotlib
میں ڈیٹا کے تجزیہ کے لیے پانڈاس اور سادہ تصور کے لیے Matplotlib استعمال کرتا ہوں۔
آپ اپنی تنصیب کی تصدیق کر سکتے ہیں:
import pandas as pd
import matplotlib.pyplot as plt

print(pd.__version__)
ایک بار جب Python ورژن نمبر پرنٹ کرتا ہے، آپ شروع کرنے کے لیے تیار ہو جاتے ہیں۔
ڈیٹاسیٹ بنائیں
CSV فائل بنائیں
آئیے درج ذیل فائلیں بنا کر شروع کریں: students.csv اور کچھ ڈیٹا شامل کریں۔
ہم یہاں جس ڈیٹاسیٹ کے ساتھ کام کریں گے فرضی ہے اور اس میں گریڈ 9 سے 12 تک کے طلباء کے 12 ریکارڈ شامل ہیں۔ ہر قطار ایک طالب علم کی نمائندگی کرتی ہے اور ہر کالم ایک مختلف وصف بیان کرتا ہے۔
name: طالب علم کا نام۔grade: طالب علم کا موجودہ اسکول گریڈ لیول۔study_hours: یہ وہ وقت ہے جب طالب علم پڑھتا تھا۔attendance: طلباء کی حاضری کی شرح۔score: ایک طالب علم کا ٹیسٹ سکور 0 سے 100 تک ریکارڈ کیا جاتا ہے۔
مثال کے طور پر، Ava 9ویں جماعت میں ہے، اس نے 4.5 گھنٹے تعلیم حاصل کی ہے، 95% حاضری ہے، اور ٹیسٹ کا اسکور 82 ہے۔ یہ نمونے کے ریکارڈز آپ کو سوالات دریافت کرنے کی اجازت دیتے ہیں جیسے کہ آیا مطالعہ کا وقت ٹیسٹ کے اسکور سے وابستہ ہے اور گریڈوں میں اوسط اسکور کا موازنہ کیسے ہوتا ہے۔
چونکہ ڈیٹا فرضی اور چھوٹا ہے، اس لیے جو بھی نمونے ہم دیکھتے ہیں وہ محض وضاحتی ہوتے ہیں اور اسے عام طور پر طلبہ کے بارے میں ثبوت کے طور پر نہیں سمجھا جانا چاہیے۔
تاہم، ہمارا ڈیٹا کچھ مفید تجزیہ کرنے کے لیے کافی معلومات فراہم کرتا ہے۔ یہ یہ ہے:
name,grade,study_hours,attendance,score
Ava,9,4.5,95,82
Liam,9,6.0,98,91
Sophia,10,3.5,89,76
Noah,10,7.0,99,94
Emma,11,5.5,93,88
Oliver,11,8.0,97,96
Mia,12,4.0,91,79
Ethan,12,6.5,96,90
Isabella,9,7.5,100,97
Lucas,10,2.5,85,68
Amelia,11,6.0,94,92
James,12,5.0,90,84
پانڈوں کا استعمال کرتے ہوئے ڈیٹاسیٹ لوڈ کریں۔
CSV فائل پڑھیں
اپنا Python پروگرام شروع کرنے کے لیے پانڈا درآمد کریں۔
import pandas as pd
پھر CSV فائل لوڈ کریں۔
data = pd.read_csv("students.csv")
کہ read_csv() فنکشن ایک CSV فائل کو پڑھتا ہے اور اسے پانڈاس ڈیٹا فریم میں تبدیل کرتا ہے۔
ڈیٹا فریم قطاروں اور کالموں سے بنا ٹیبل جیسا ڈیٹا ڈھانچہ ہے۔ اسے ایک قابل پروگرام اسپریڈشیٹ کے طور پر سوچیں۔
آئیے ڈیٹا سیٹ ڈسپلے کرتے ہیں۔
print(data)
آپ ٹرمینل پر پرنٹ شدہ طلباء کے ریکارڈ دیکھ سکتے ہیں۔
ڈیٹا ایکسپلوریشن
ڈیٹا سیٹ کا تجزیہ کرنے سے پہلے، یہ سمجھنا مفید ہے کہ آپ کس چیز کے ساتھ کام کر رہے ہیں۔
پہلی قطار دیکھیں
کہ head() طریقہ پہلی پانچ قطاریں دکھاتا ہے۔
print(data.head())
آپ اپنی مطلوبہ قطاروں کی تعداد بھی بتا سکتے ہیں۔
print(data.head(3))
ڈیٹاسیٹ کا سائز چیک کریں۔
استعمال کریں shape قطاروں اور کالموں کی تعداد معلوم کرنے کے لیے:
print(data.shape)
نتائج درج ذیل ہیں:
(12, 5)
اس کا مطلب ہے کہ ڈیٹا سیٹ میں 12 قطاریں اور 5 کالم ہیں۔
کالم کا نام چیک کریں۔
آپ کالم کے نام استعمال کرکے دیکھ سکتے ہیں:
print(data.columns)
جب آپ کو اپنے پروگرام میں بعد میں کالم کا حوالہ دینے کی ضرورت ہو تو یہ مفید ہے۔
ڈیٹا کی قسم چیک کریں۔
استعمال کریں info() ہر کالم کے بارے میں معلومات دیکھنے کے لیے:
data.info()
یہ آپ کو یہ شناخت کرنے کی اجازت دیتا ہے کہ آیا کالم میں عدد، اعشاریہ نمبر، متن، یا ڈیٹا کی دیگر اقسام ہیں۔
بنیادی شماریاتی حسابات
پانڈا ریاضی کے فارمولوں کو دستی طور پر لکھے بغیر شماریات کا حساب لگانا آسان بناتا ہے۔
اوسط اسکور تلاش کریں۔
آپ اس کا استعمال کرتے ہوئے اوسط سکور کا حساب لگا سکتے ہیں:
average_score = data["score"].mean()

print(f"Average score: {average_score:.2f}")
کہ mean() طریقہ ریاضی کے اوسط کا حساب لگاتا ہے۔
کہ :.2f فارمیٹ ہونے پر، Python نتیجہ دو اعشاریہ کے ساتھ دکھاتا ہے۔
سب سے زیادہ اور سب سے کم اسکور تلاش کریں۔
استعمال کریں max() اور min():
highest_score = data["score"].max()
lowest_score = data["score"].min()

print(f"Highest score: {highest_score}")
print(f"Lowest score: {lowest_score}")
آپ میڈین بھی تلاش کر سکتے ہیں۔
median_score = data["score"].median()

print(f"Median score: {median_score}")
جب آپ اسکور کو ترتیب دیتے ہیں تو درمیانی قدر درمیان میں ہوتی ہے۔
شماریاتی خلاصے تیار کریں۔
پانڈا کچھ آسان خصوصیات بھی فراہم کرتے ہیں: describe() طریقہ:
print(data["score"].describe())
یہ مندرجہ ذیل اعداد و شمار تیار کرتا ہے:
- شمار
- اوسط
- معیاری انحراف
- کم از کم
- 25 فیصد
- درمیانی
- 75 واں پرسنٹائل
- بہترین
آپ کسی بھی عددی کالم کے لیے خلاصے بنا سکتے ہیں۔
print(data.describe())
یہ اکثر ان اولین کمانڈز میں سے ایک ہوتا ہے جو آپ کسی غیر مانوس ڈیٹا سیٹ کو دریافت کرتے وقت استعمال کرتے ہیں۔
ڈیٹا فلٹرنگ
پانڈوں کی سب سے مفید خصوصیات میں سے ایک شرائط کی بنیاد پر قطاروں کو منتخب کرنے کی صلاحیت ہے۔
اعلی اسکور والے طلباء کو تلاش کریں۔
فرض کریں کہ آپ ایسے طلباء کو تلاش کرنا چاہتے ہیں جنہوں نے 90 یا اس سے زیادہ نمبر حاصل کیے ہوں۔
high_scores = data[data["score"] >= 90]

print(high_scores)
اظہار:
data["score"] >= 90
ہر قطار کے لیے بولین کنڈیشن بناتا ہے۔ پانڈا صرف اس شرط کے ساتھ قطاریں رکھیں گے۔ True.
5 گھنٹے سے زیادہ مطالعہ کرنے والے طلباء کو تلاش کریں۔
آپ اپنے مطالعہ کے وقت کو اسی کام کے لیے استعمال کر سکتے ہیں۔
frequent_studiers = data[data["study_hours"] > 5]

print(frequent_studiers)
آپ متعدد شرائط کو بھی یکجا کر سکتے ہیں۔
مثال کے طور پر، ہم کہتے ہیں کہ آپ ایسے طلباء چاہتے ہیں جو 5 گھنٹے سے زیادہ پڑھتے ہوں اور ان کی حاضری کی شرح 95% یا اس سے زیادہ ہو۔
students = data[
    (data["study_hours"] > 5) &
    (data["attendance"] > 95)
]

print(students)
پانڈا میں حالات کو یکجا کرتے وقت، استعمال کریں: & AND اور کے لیے | OR کے لیے۔ ہر شرط کو قوسین میں بند کیا جانا چاہیے۔
ایک مخصوص طالب علم تلاش کریں۔
استعمال کریں idxmax()
کبھی کبھی آپ صرف سب سے زیادہ قیمت نہیں چاہتے ہیں۔ میں جاننا چاہوں گا کہ کون سا ریکارڈ مواد پر مشتمل ہے۔
مثال کے طور پر:
top_student_index = data["score"].idxmax()
top_student = data.loc[top_student_index]

print(top_student)
idxmax() سب سے بڑی قدر والی قطار کا اشاریہ لوٹاتا ہے۔
آپ مطالعہ کے دوران بھی ایسا ہی کر سکتے ہیں۔
most_studious_index = data["study_hours"].idxmax()
most_studious_student = data.loc[most_studious_index]

print(most_studious_student)
یہ آپ کو اپنے اعداد و شمار کو ان کے اصل ریکارڈ سے منسلک کرنے کی اجازت دیتا ہے۔
ڈیٹا گروپنگ
گروپ بندی خاص طور پر مفید ہے اگر آپ کے ڈیٹاسیٹ میں زمرے شامل ہوں۔
ہمارے ڈیٹاسیٹ میں طلباء کا تعلق مختلف درجات سے ہے۔
گریڈ کے لحاظ سے اوسط سکور
آپ ہر گریڈ کے لیے اوسط سکور کا حساب لگا سکتے ہیں۔
average_by_grade = data.groupby("grade")["score"].mean()

print(average_by_grade)
یہ آپ کو بتاتا ہے کہ اوسط سکور سطحوں پر کیسے مختلف ہوتے ہیں۔
یہ آؤٹ پٹ کو پڑھنے میں آسان بنا سکتا ہے۔
average_by_grade = (
    data.groupby("grade")["score"]
    .mean()
    .round(2)
)

print(average_by_grade)
متعدد اعداد و شمار
آپ ایک ہی وقت میں متعدد اعدادوشمار کا حساب لگا سکتے ہیں۔
grade_summary = data.groupby("grade")["score"].agg(
    ["mean", "min", "max", "count"]
)

print(grade_summary)
یہ ہر گریڈ کے لیے ایک خلاصہ بناتا ہے جس میں اوسط، کم از کم، زیادہ سے زیادہ، اور طلباء کی تعداد شامل ہوتی ہے۔
مطالعہ کے وقت کا تجزیہ
آپ مطالعہ کے وقت اور اسکور کے درمیان تعلق کا بھی جائزہ لے سکتے ہیں۔
ارتباط کا حساب کتاب
پانڈا corr() طریقہ:
correlation = data["study_hours"].corr(data["score"])

print(f"Correlation: {correlation:.2f}")
ارتباط کی قدریں عام طور پر -1 سے 1 تک ہوتی ہیں۔
1 کے قریب قدر ایک مضبوط مثبت لکیری تعلق کی نشاندہی کرتی ہے، اور -1 کے قریب قدر مضبوط منفی لکیری تعلق کی نشاندہی کرتی ہے۔ 0 کے قریب قدریں چھوٹے لکیری تعلق کی نشاندہی کرتی ہیں۔
لیکن تعلق ہے ~ نہیں ثابت کریں کہ ایک متغیر دوسرے متغیر کا سبب بنتا ہے۔ مثال کے طور پر، یہاں تک کہ اگر مطالعہ کا وقت اور اسکور اس ڈیٹاسیٹ میں باہم مربوط ہیں، تو یہ ثابت نہیں کرتا کہ زیادہ براہ راست مطالعہ کرنے سے اعلیٰ اسکور ہوتے ہیں۔
ایک تصور بنائیں
نمبرز مفید ہیں، لیکن تصور سے پیٹرن کو پہچاننا آسان ہو جاتا ہے۔
ایک سکیٹر پلاٹ بنائیں
آئیے مطالعہ کا وقت اور ٹیسٹ کے اسکور کو ظاہر کرنے والا ایک سکیٹر پلاٹ بنائیں۔
import matplotlib.pyplot as plt

plt.scatter(data["study_hours"], data["score"])

plt.xlabel("Study Hours")
plt.ylabel("Test Score")
plt.title("Study Hours vs. Test Scores")

plt.show()
ہر نقطہ ایک طالب علم کی نمائندگی کرتا ہے۔
x-axis مطالعہ کے وقت کی نمائندگی کرتا ہے، اور y-axis ٹیسٹ کے اسکور کی نمائندگی کرتا ہے۔
آپ دیکھ سکتے ہیں کہ تربیت کا وقت بڑھنے کے ساتھ پوائنٹس عموماً اوپر کی طرف بڑھتے دکھائی دیتے ہیں۔
یہ اس طرح نظر آنا چاہئے:
بار چارٹ بنائیں
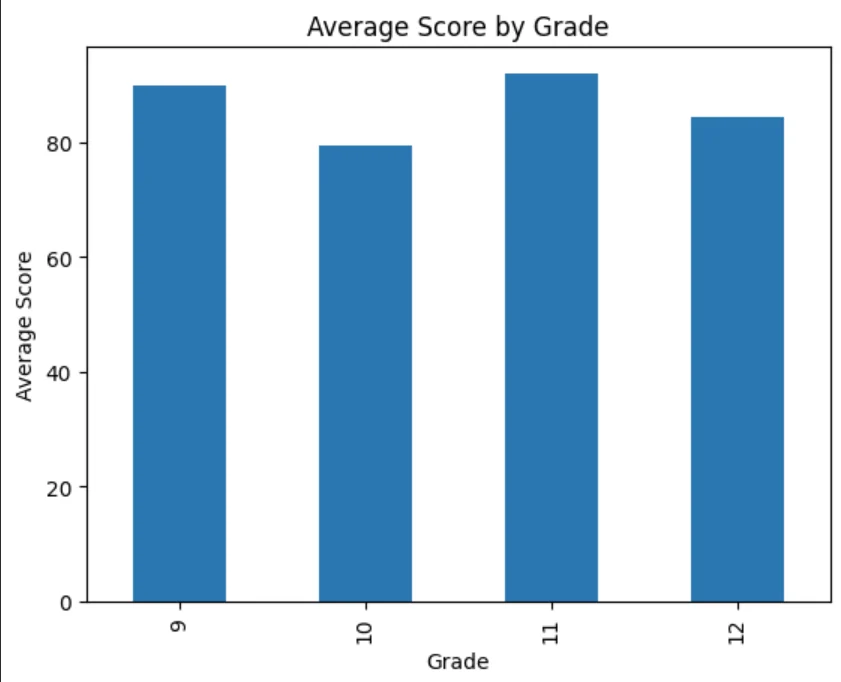
آپ ہر گریڈ کے لیے اوسط سکور بھی دیکھ سکتے ہیں۔
average_by_grade = data.groupby("grade")["score"].mean()

average_by_grade.plot(kind="bar")

plt.xlabel("Grade")
plt.ylabel("Average Score")
plt.title("Average Score by Grade")

plt.show()
بار چارٹس گروپوں کے درمیان ذرائع کا موازنہ کرنا آسان بناتے ہیں۔
بار چارٹ اس طرح لگتا ہے:
ایک مکمل تجزیہ کار بنانا
اب آئیے مرکزی خیالات کو ایک پروگرام میں جوڑتے ہیں۔
import pandas as pd
import matplotlib.pyplot as plt

# Load the dataset
data = pd.read_csv("students.csv")

# Basic information
print("Dataset shape:")
print(data.shape)

print("nFirst five rows:")
print(data.head())

# Score statistics
average_score = data["score"].mean()
median_score = data["score"].median()
highest_score = data["score"].max()
lowest_score = data["score"].min()

print("nScore Statistics")
print(f"Average: {average_score:.2f}")
print(f"Median: {median_score:.2f}")
print(f"Highest: {highest_score}")
print(f"Lowest: {lowest_score}")

# Students with scores of 90 or higher
high_scores = data[data["score"] >= 90]

print("nStudents with scores of 90 or higher:")
print(high_scores[["name", "score"]])

# Average score by grade
average_by_grade = (
    data.groupby("grade")["score"]
    .mean()
    .round(2)
)

print("nAverage Score by Grade:")
print(average_by_grade)

# Study hours and score correlation
correlation = data["study_hours"].corr(data["score"])

print(f"nStudy Hours vs. Score Correlation: {correlation:.2f}")

# Scatter plot
plt.scatter(data["study_hours"], data["score"])

plt.xlabel("Study Hours")
plt.ylabel("Test Score")
plt.title("Study Hours vs. Test Scores")

plt.show()
یہ پروگرام اب ایک چھوٹا لیکن مکمل ڈیٹا انیلیسیس ورک فلو انجام دیتا ہے۔
تجزیہ کاروں کو دوبارہ قابل استعمال بنانا
ایک مفید اگلا مرحلہ بار بار کاموں کو افعال میں تبدیل کرنا ہے۔
ایک تجزیاتی فنکشن بنائیں
اپنے مرکزی پروگرام میں خود سب کچھ لکھنے کے بجائے، آپ ایک فنکشن بنا سکتے ہیں:
def analyze_scores(data):
    average = data["score"].mean()
    median = data["score"].median()
    highest = data["score"].max()
    lowest = data["score"].min()

    print(f"Average score: {average:.2f}")
    print(f"Median score: {median:.2f}")
    print(f"Highest score: {highest}")
    print(f"Lowest score: {lowest}")
پھر اسے استعمال کرتے ہوئے کال کریں:
analyze_scores(data)
یہ دوسرے ڈیٹا فریمز میں کوڈ کو دوبارہ استعمال کرنا آسان بناتا ہے۔
اعلی درجے کے طالب علموں کے لئے افعال کی تخلیق
آپ ایک ایسا فنکشن بھی بنا سکتے ہیں جو طالب علم کو سب سے زیادہ اسکور کے ساتھ واپس کرے۔
def get_top_students(data, minimum_score=90):
    return data[data["score"] >= minimum_score][
        ["name", "grade", "score"]
    ]
اب آپ جب چاہیں حد کو تبدیل کر سکتے ہیں۔
print(get_top_students(data, 95))
جیسا کہ آپ کا تجزیہ کار بڑھتا ہے اس طرح کی خصوصیات خاص طور پر اہم ہو جاتی ہیں۔
گمشدہ ڈیٹا کو ہینڈل کرنا
حقیقی ڈیٹا سیٹ ہماری مثال کے طور پر صاف نہیں ہیں. کبھی کبھی لاپتہ اقدار واقع ہوسکتی ہیں۔
آپ لاپتہ اقدار کو استعمال کرکے چیک کرسکتے ہیں:
print(data.isnull().sum())
یہ آپ کو بتاتا ہے کہ ہر کالم میں کتنی قدریں غائب ہیں۔
مثال کے طور پر، آپ یہ استعمال کرکے لاپتہ اقدار والی قطاروں کو ہٹا سکتے ہیں:
clean_data = data.dropna()
متبادل طور پر، آپ اپنے ڈیٹا سیٹ اور گمشدہ اقدار کا کیا مطلب ہے، اس پر منحصر ہے کہ آپ گمشدہ اقدار کو تبدیل کر سکتے ہیں۔
data["score"] = data["score"].fillna(data["score"].mean())
تمام گمشدہ اقدار کو خود بخود وسط سے تبدیل نہیں کیا جانا چاہیے۔ مناسب نقطہ نظر اس بات پر منحصر ہے کہ گمشدہ ڈیٹا کس چیز کی نمائندگی کرتا ہے اور آپ کس چیز کا تجزیہ کرنا چاہتے ہیں۔
نتائج برآمد کریں۔
اپنے ڈیٹا سیٹ کا تجزیہ کرنے کے بعد، آپ نتائج کو محفوظ کر سکتے ہیں۔
مثال کے طور پر:
average_by_grade.to_csv("average_scores_by_grade.csv")
آپ فلٹر شدہ ریکارڈز کو بھی محفوظ کر سکتے ہیں۔
high_scores.to_csv("high_scoring_students.csv", index=False)
کہ index=False دلیل پانڈوں کو ڈیٹا فریم کے انڈیکس کو اضافی کالم کے طور پر شامل کرنے سے روکتی ہے۔
سے بچنے کے لیے عام غلطیاں
اگر آپ اپنی لائبریری کو درآمد کرنا بھول گئے ہیں۔
یقینی بنائیں کہ آپ نے مطلوبہ لائبریریاں درآمد کر لی ہیں۔
import pandas as pd
import matplotlib.pyplot as plt
بصورت دیگر ازگر کو معلوم نہیں ہوگا کہ کیا کرنا ہے۔ pd یا plt طریقہ
کالم کے نام کا غلط استعمال
کالم کے نام آپ کے ڈیٹاسیٹ سے مماثل ہونے چاہئیں۔
مثال کے طور پر، جب کالم کہا جاتا ہے۔ study_hoursیہ کام نہیں کرتا:
data["study time"]
آپ ہمیشہ کالم کے اصل ناموں کو استعمال کر کے چیک کر سکتے ہیں:
print(data.columns)
باہمی تعلق وجہ کے ساتھ الجھا ہوا ہے۔
ارتباط متغیرات کے درمیان تعلق کی نشاندہی کر سکتا ہے، لیکن یہ ثابت نہیں کرتا کہ ایک متغیر دوسرے کا سبب بنتا ہے۔
جیسے جیسے آپ بڑے اور پیچیدہ ڈیٹاسیٹس کے ساتھ کام کرتے ہیں، یہ فرق تیزی سے اہم ہوتا جاتا ہے۔
ڈیٹا کو سمجھنے سے پہلے اس کا تجزیہ کریں۔
یہ فوری طور پر اعدادوشمار کا حساب لگانا پرکشش ہے۔ لیکن پہلے، اپنے ڈیٹاسیٹ کا معائنہ کریں۔
کچھ مفید اسٹارٹ اپ کمانڈز ہیں:
data.head()
data.shape
data.info()
data.describe()
data.isnull().sum()
آپ کے ڈیٹا کی ساخت اور معیار کو سمجھنا غلط نتائج کو روکنے میں مدد کرتا ہے۔
میں یہاں سے کہاں جاؤں؟
اگرچہ ہم نے جو تجزیہ کار بنایا ہے وہ جان بوجھ کر آسان ہے، لیکن وہی ورک فلو بہت بڑے ڈیٹا سیٹس پر لاگو کیا جا سکتا ہے۔
آپ اسے اس طرح بڑھا سکتے ہیں:
- فروخت کے اعداد و شمار کا تجزیہ
- ویب سائٹ ٹریفک سے باخبر رہنا
- تحقیقی سروے کا جواب
- مارکیٹنگ مہم کا تجزیہ
- کھیلوں کے اعدادوشمار کی تحقیق
- مالیاتی ڈیٹا سیٹ دریافت کریں۔
- ایپلیکیشن یا کسٹمر ڈیٹا کو ٹریک کریں۔
آپ اعلی درجے کی خصوصیات جیسے انٹرایکٹو چارٹس، کمانڈ لائن آرگیومینٹس، خودکار رپورٹس، یا مشین لرننگ ماڈلز بھی شامل کر سکتے ہیں۔
مثال کے طور پر، CSV فائل کے نام کو سختی سے کوڈنگ کرنے کے بجائے، آپ صارف کو درج ذیل میں سے ایک فراہم کرنے کے لیے کہہ سکتے ہیں:
filename = input("Enter the CSV filename: ")

data = pd.read_csv(filename)

print(data.head())
اب آپ ایک ہی پروگرام کے ساتھ مختلف قسم کی CSV فائلوں کا تجزیہ کر سکتے ہیں۔
حتمی خیالات
آپ کو اپنے ڈیٹا کے ساتھ کام شروع کرنے کے لیے پیچیدہ الگورتھم کی ضرورت نہیں ہے۔ Python، Pandas، اور نسبتاً چھوٹے ڈیٹا سیٹس کا استعمال کرتے ہوئے، آپ پہلے سے ہی بامعنی تجزیہ کر سکتے ہیں۔
اس ٹیوٹوریل میں آپ نے سیکھا کہ کیسے:
- پانڈوں میں CSV ڈیٹا لوڈ کریں۔
- ڈیٹا فریم نیویگیشن
- شماریاتی حسابات
- قطار فلٹرنگ
- ایک مخصوص ریکارڈ تلاش کریں۔
- گروپ ڈیٹا
- ارتباط کا حساب کتاب
- ایک تصور بنائیں
- ویلیو ہینڈلنگ غائب ہے۔
- تجزیہ کے نتائج برآمد کریں۔
- افعال کے ساتھ تجزیہ کو منظم کرنا
سب سے اہم اگلا مرحلہ مختلف ڈیٹاسیٹس کے ساتھ مشق کرنا ہے۔ ایک بار جب آپ ڈیٹا کو لوڈ کرنے، دریافت کرنے، صاف کرنے اور تجزیہ کرنے کے لیے پانڈوں کا استعمال کرنے میں آسانی پیدا کر لیتے ہیں، تو آپ ڈیٹا کے تجزیہ کے اور بھی زیادہ نفیس منصوبے بنانا شروع کر سکتے ہیں۔
مبارک کوڈنگ!