
عصبی نیٹ ورکس کے کام کرنے کے طریقے کو سمجھنے کے لیے سیدھی لائن مساوات ایک اچھی جگہ ہے۔ یہ وہ چیز ہے جسے ہم نے پچھلے مضمون میں دیکھا تھا، نیورل نیٹ ورک کیسے کام کرتے ہیں – لائن مساوات (y=ax+b) کا استعمال کرتے ہوئے وضاحت کی گئی ہے۔
لیکن ان پٹ اور آؤٹ پٹ کے درمیان کیا تعلق ہے؟ کیا یہ لکیری نہیں ہے؟
ہم سب جانتے ہیں کہ حقیقی دنیا میں، ڈیٹا ہمیشہ لکیری نمونوں کی پیروی نہیں کرتا ہے۔ یہیں سے چیزیں دلچسپ ہونے لگتی ہیں۔ بعض اوقات صرف ایک ہی اصول متغیر کے درمیان تعلق کو بیان کرنے کے لیے کافی نہیں ہوتا۔
یہ وہ جگہ ہے جہاں غیر خطی پن کھیل میں آتا ہے۔ یہ نیورل نیٹ ورک کو ڈیٹا کے بدلتے ہوئے رویے کو پکڑنے کی اجازت دیتا ہے۔
اس مضمون میں، ہم نان لائنیرٹی کے تصور کو تلاش کریں گے، جو ڈیٹا میں پیچیدہ تعلقات کو حاصل کر سکتا ہے۔ آئیے ٹکڑا وار لکیری منحنی خطوط، ReLU فنکشنز، سگمائیڈ کروز، اور سگمائیڈ فنکشنز کو سمجھنے کے لیے سادہ مثالیں استعمال کریں، اور دیکھیں کہ وہ کس طرح عصبی نیٹ ورکس کو ایسے نمونوں کو سیکھنے میں مدد کرتے ہیں جنہیں سیدھی لکیریں بیان نہیں کرسکتیں۔
انڈیکس
شرائط
جب سیدھی لکیریں کافی ہوں۔
ایک سیدھی لائن مساوات کا مطلب ہے کہ ایک ہی اصول پورے رشتے میں لاگو ہوتے ہیں۔
y = کلہاڑی + b
y => Output variable
x => Input variable
a => Amount by which y changes when x changes (slope)
b => Value of y when x is 0 (y intercept)
ایک مثال آپ کو بہتر طور پر سمجھنے میں مدد دے گی۔
محترمہ پولی ایک ریاضی کی استاد ہیں جو اپنے طلباء کے لیے مطالعہ کے منصوبے بنانا چاہتی ہیں تاکہ ان کے آخری امتحانات میں اچھی کارکردگی دکھانے میں ان کی مدد کی جا سکے۔ وہ ایک عنصر کا استعمال کرتی ہے: انگوٹھے کا اصول بنانے کے لیے فی ہفتہ مطالعہ کے اوقات۔ دوسرے لفظوں میں، ایک طالب علم کو حاصل کردہ اسکور مطالعہ کے وقت کے براہ راست متناسب ہوتا ہے۔
اپنے مفروضوں کی بنیاد پر، وہ فارم y=ax+b کی ایک مساوات لے کر آئی۔
y => Marks scored
x => Number of hours studied
a => Increase in marks for every hour studied
b => Minimum marks every student is capable of scoring without studying.
اس لیے سہ ماہی امتحانات کے بعد، وہ طلبہ کا انٹرویو کرتی ہے اور اس بارے میں معلومات اکٹھی کرتی ہے کہ انھوں نے ہفتے میں کتنے گھنٹے ریاضی کا مطالعہ کیا۔ وہ دو کالموں کے ساتھ ایک ٹیبل بناتی اور دکھاتی ہے: فی ہفتہ مطالعہ کیے گئے گھنٹے (x) اور اسکور (y)۔
| وقت کا مطالعہ کیا | سکور سکور |
|---|---|
| 0 | 40 |
| 1 | 40 |
| 2 | 41 |
| 3 | 40 |
| 4 | 48 |
| 5 | 58 |
| 6 | 69 |
| 7 | 80 |
| 8 | 80 |
لیکن جب وہ اپنے سادہ فارمولے کو لاگو کرنے کی کوشش کرتی ہے، تو ایسا لگتا ہے کہ اس کے جمع کردہ ڈیٹا سے میل نہیں کھاتا، یہ ثابت کرتا ہے کہ اصل ڈیٹا اتنا آسان نہیں ہے۔
جب سیدھی لکیریں کافی نہیں ہیں۔
مسٹر پولی گراف کو قریب سے دیکھتے ہیں اور کئی نمونوں کی نشاندہی کرتے ہیں۔ جو طالب علم صرف چند گھنٹے پڑھتا ہے وہ زیادہ حاصل نہیں کر سکتا۔ ایک بار جب آپ ایک خاص نقطہ کو پاس کرتے ہیں، تو اضافی سیکھنے کے ذریعے آپ کا سکور بڑھنا شروع ہو جاتا ہے۔ اور پھر، نشانات ایک خاص نقطہ کے بعد کافی مستقل رہتے ہیں۔
لہذا، محترمہ پولی کی سادہ سیدھی لائن مساوات مطالعہ کے اوقات فی ہفتہ (x) اور اسکور (y) کے درمیان تعلق کو بیان کرنے کے لیے کافی نہیں ہے۔
اس کے بجائے، اسے تین حصوں میں تقسیم کیا جا سکتا ہے:
Less than t₁ hours: Marks remain constant
t₁ to t₂ hours: Marks increase with study time
More than t₂ hours: Marks remain constant
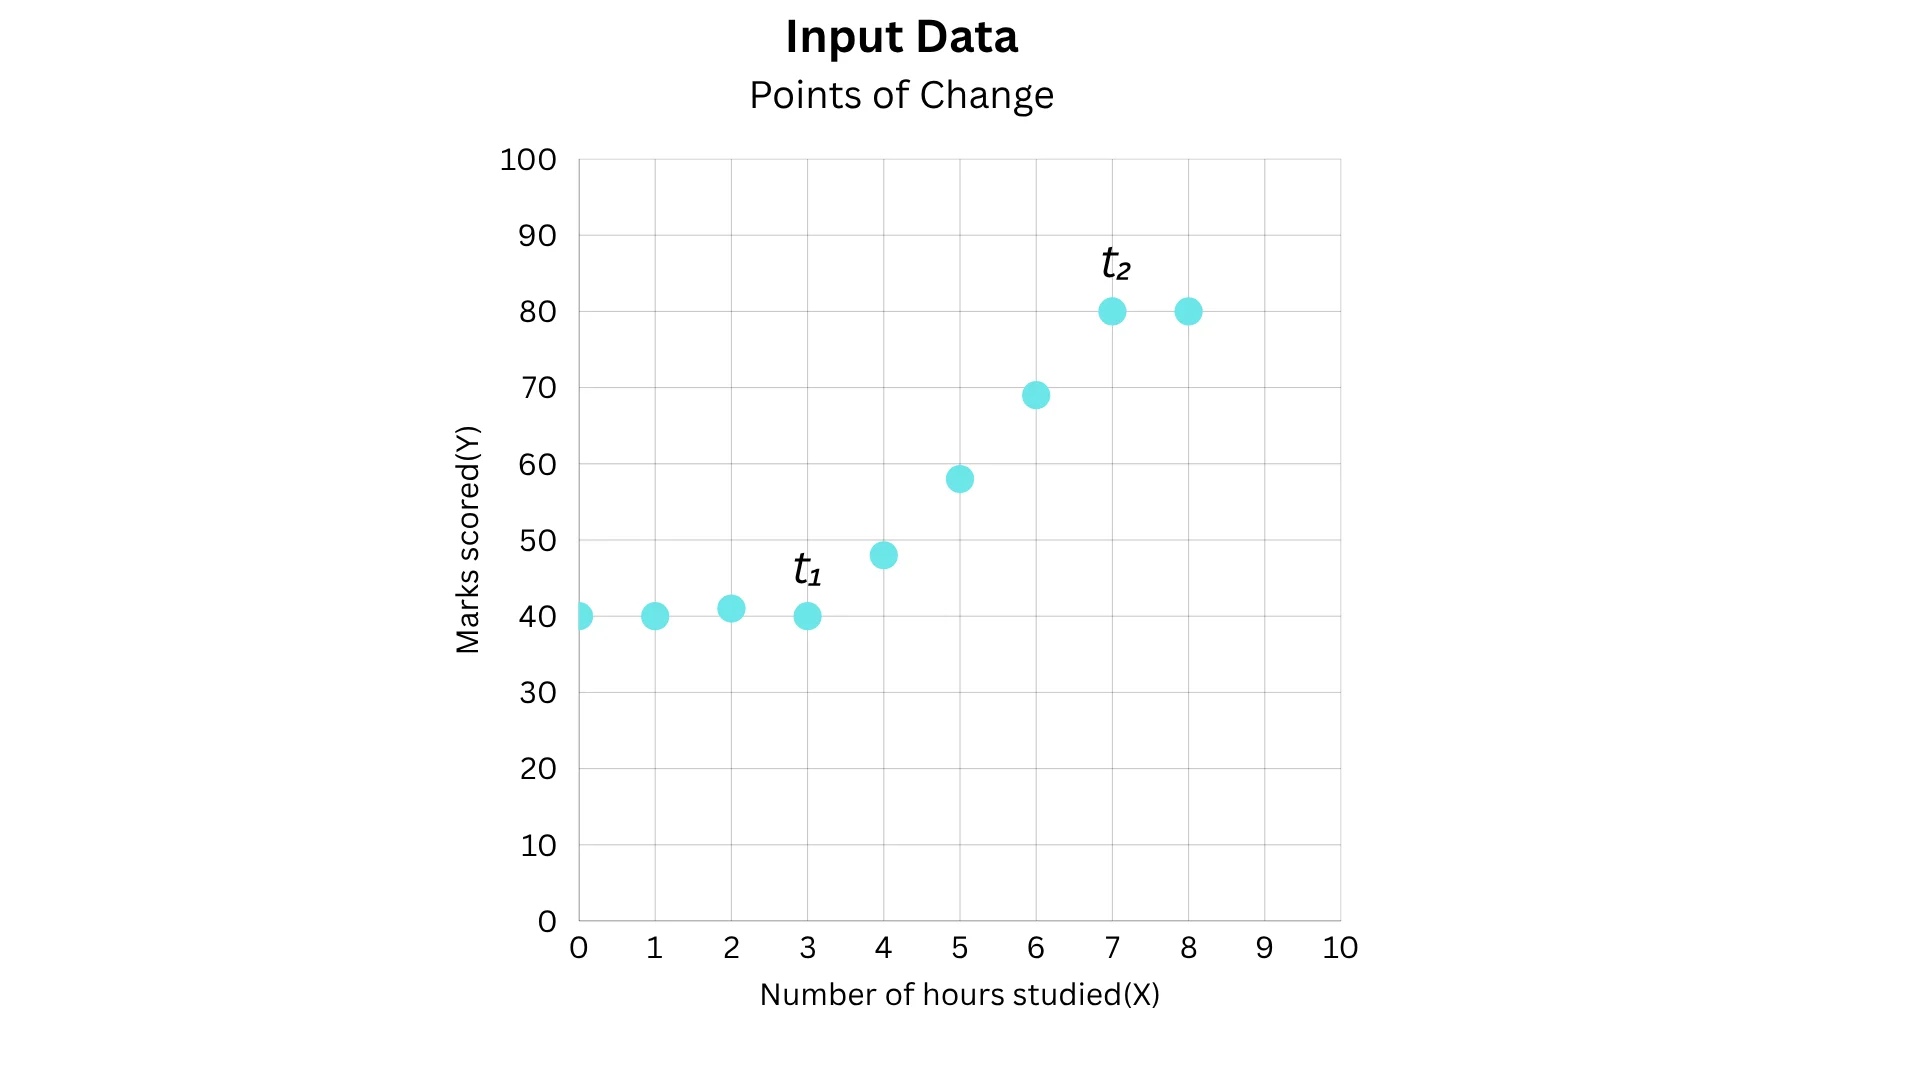
لہذا، وہ ہر رینج کے لیے الگ الگ مساوات رکھ سکتی ہے اور لکھ سکتی ہے:
y = 1st equation, x=t₂
یہ مثال ہمیں غیر خطوط پر ہماری پہلی جھلک دیتی ہے۔ ایک لکیری مساوات کافی نہیں ہے کیونکہ ایک خاص نقطہ پر تعلقات میں تبدیلی آتی ہے، جس کے لیے کسی دوسرے مقام پر رویے میں تبدیلی کی ضرورت ہوتی ہے۔
اس کو سنبھالنے کا ایک آسان طریقہ استعمال کرنا ہے: ٹکڑا وار لکیری فنکشن.
ٹکڑا وار لکیری وکر
سب سے پہلے، سادگی کی خاطر، محترمہ پولی نے صرف دو علاقوں پر غور کرنے کا فیصلہ کیا۔
Region1: Hours of study < t₁
Region2: Hours of study >= t₁
پہلے علاقے کی قدریں ایک مخصوص قدر کے گرد اشارہ کرتی ہیں۔ یہاں تک کہ اگر وہ بالکل سیدھے نہیں بولتے ہیں، تو ہم ایک تخمینہ حاصل کر سکتے ہیں اور ڈھلوان=0 کے ساتھ ایک لکیر کے طور پر علاقے کی نمائندگی کر سکتے ہیں۔ اس سے ظاہر ہوتا ہے کہ نشانات زیادہ تر ایک جیسے ہی رہتے ہیں۔
دوسرے خطے میں ایک مثبت ڈھلوان دکھائی دیتی ہے۔ لہذا وہ کھڑی اوپر کی طرف ڈھلوان لائن کے لیے ایک اور لکیری مساوات کا تعین کرتی ہے:
محترمہ چونکہ پولی کو ایک مساوات میں بیان نہیں کیا جا سکتا، اس لیے اوپر والے گراف کے لیے ہمارے پاس دو مساواتیں ہیں۔ جیسا کہ پیٹرن تبدیل ہوتا ہے، مختلف حدود کے اصول بدل جاتے ہیں۔
تو وہ لکھ سکتی ہے:
y = 1st equation, x=t₁
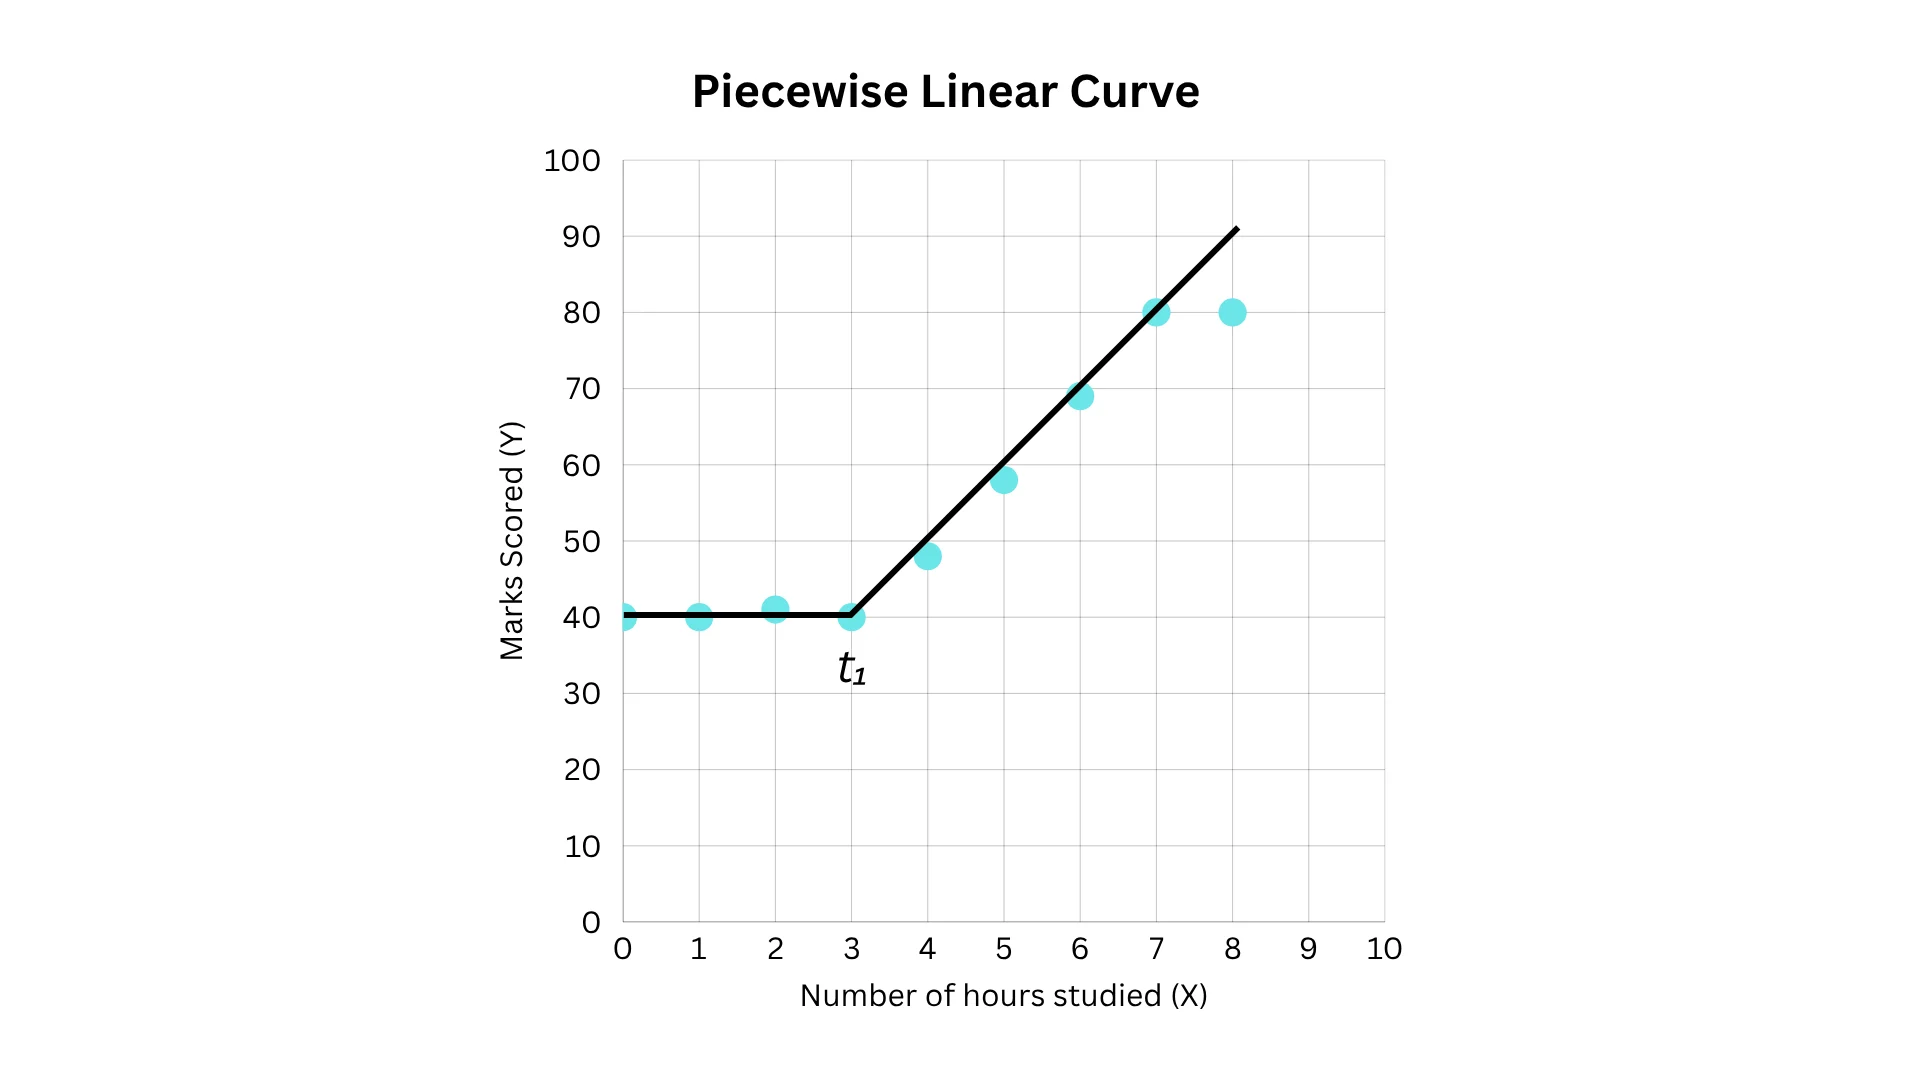
انفرادی طور پر، یہ ایک سیدھی لائن مساوات کی طرح نظر آسکتا ہے۔ لیکن جب ایک ساتھ لیا جائے تو مجموعی تعلق اب سیدھی لکیر نہیں رہا۔ جب x ایک خاص قدر سے تجاوز کرتا ہے تو مساوات بدل جاتی ہے۔ اسے کہتے ہیں۔ ٹکڑا لکیری فنکشن۔ مختلف ان پٹ رینجز کے لیے مختلف اصولوں پر مشتمل ایک فنکشن۔
یہ خیال نیورل نیٹ ورکس میں سب سے زیادہ استعمال ہونے والے ایکٹیویشن فنکشن میں ظاہر ہوتا ہے۔ دوبارہ شروع کریں.
ReLU فنکشن کیا ہے؟
ReLU کا مطلب Rectified Linear Unit ہے۔ ریاضیاتی طور پر یہ ہے:
y = ReLU(x) = max(0,x)
مثبت ان پٹ کو اسی طرح چھوڑ دیں اور منفی ان پٹ کو 0 سے بدل دیں۔
ایک بار پھر، انفرادی حصے لکیری ہیں، لیکن مجموعی فعل غیر خطی ہے۔ لہذا ReLU ایک ٹکڑا وار لکیری فنکشن ہے جو غیر خطوطی کو متعارف کرواتا ہے۔
نیچے کا گراف ReLU فنکشن کو دکھاتا ہے۔
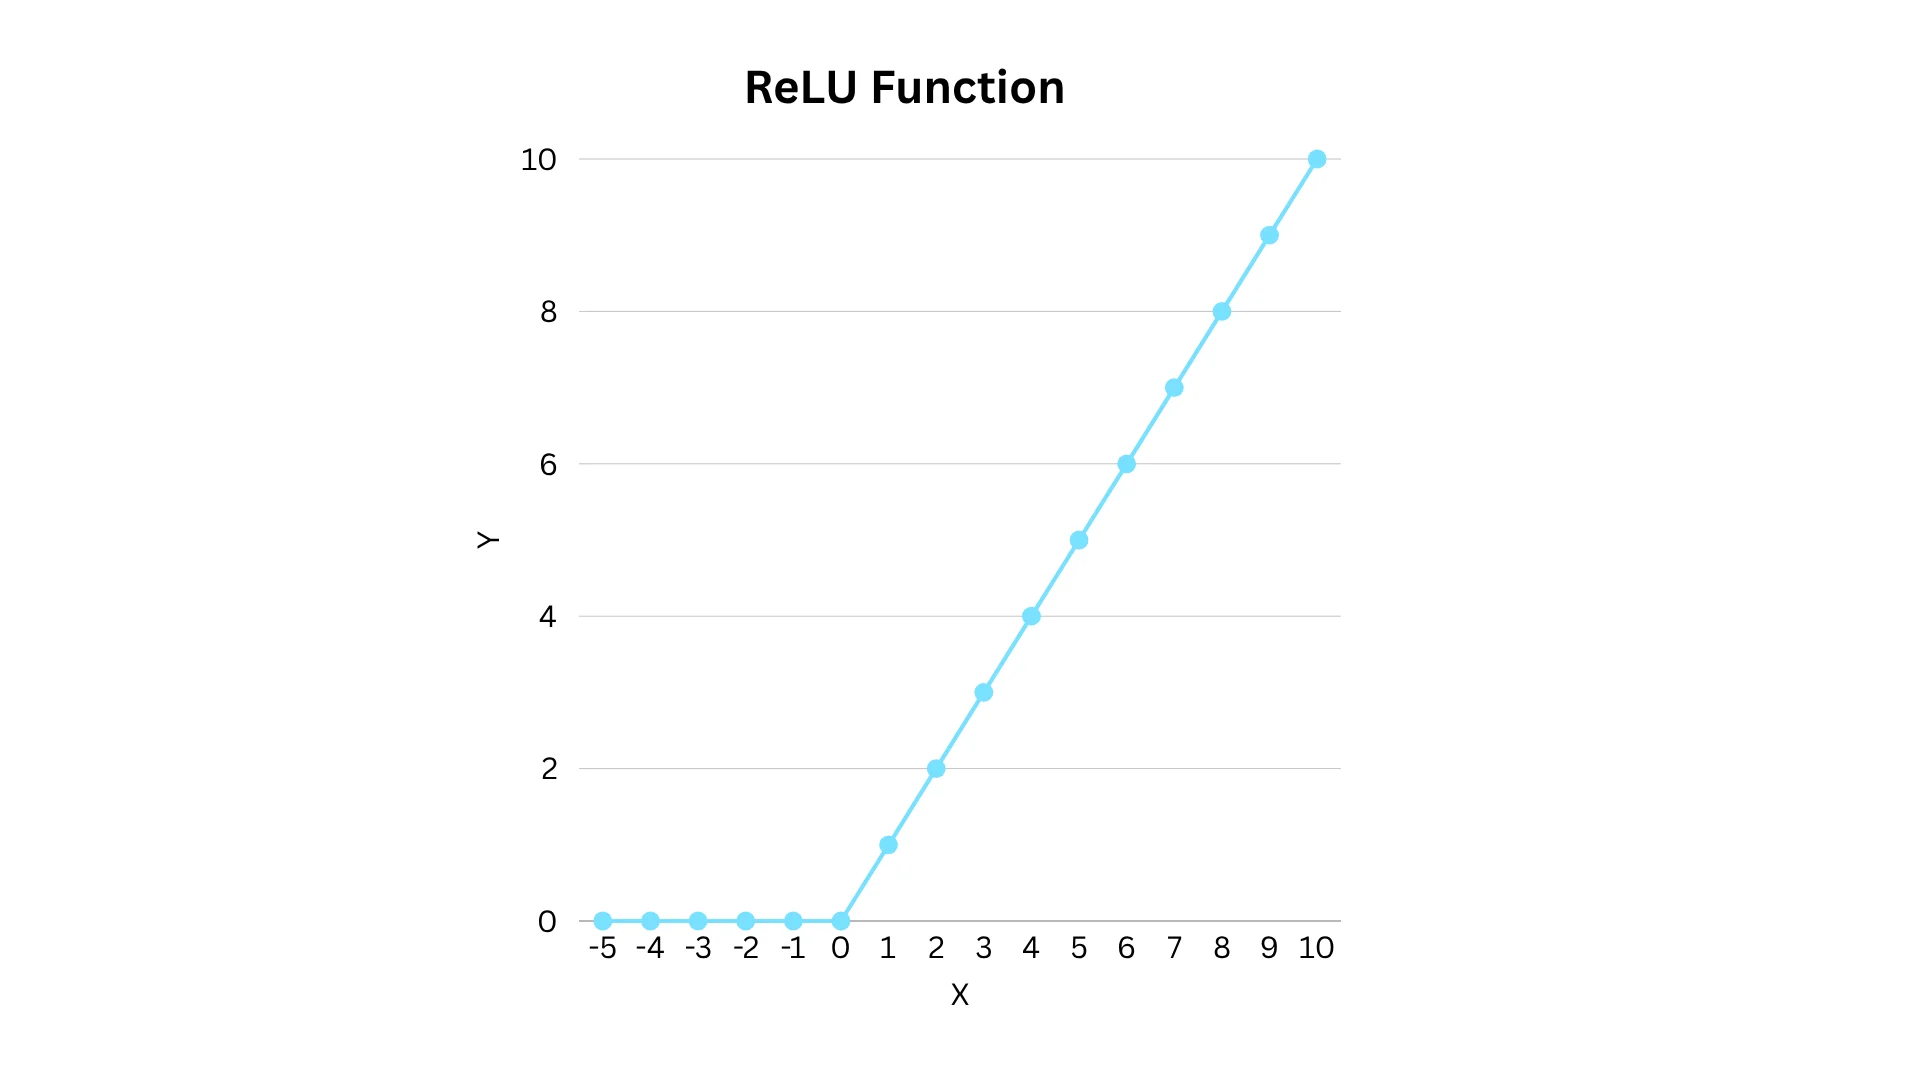
رویے میں یہ سادہ تبدیلیاں نیوران کو مختلف قسم کے آدانوں کے لیے مختلف طریقے سے جواب دینے کی اجازت دیتی ہیں، جس سے عصبی نیٹ ورک ایک ہی لکیری تعلق سے آگے بڑھ سکتے ہیں۔
S کی شکل کا وکر
اب ایک ٹکڑا لکیری وکر کام کرے گا، لیکن محترمہ پولی دیکھتی ہیں کہ ایک علاقے سے دوسرے علاقے میں کافی تیز تبدیلیاں ہیں۔ اگرچہ تقسیم کو تین خطوں میں تقسیم کیا جاسکتا ہے، لیکن اس نے سادگی کے لیے صرف دو خطوں پر غور کیا۔
تو وہ ایک ہموار وکر کھینچتی ہے جو تقریباً تمام پوائنٹس سے گزرتی ہے، جیسا کہ ذیل میں دکھایا گیا ہے۔
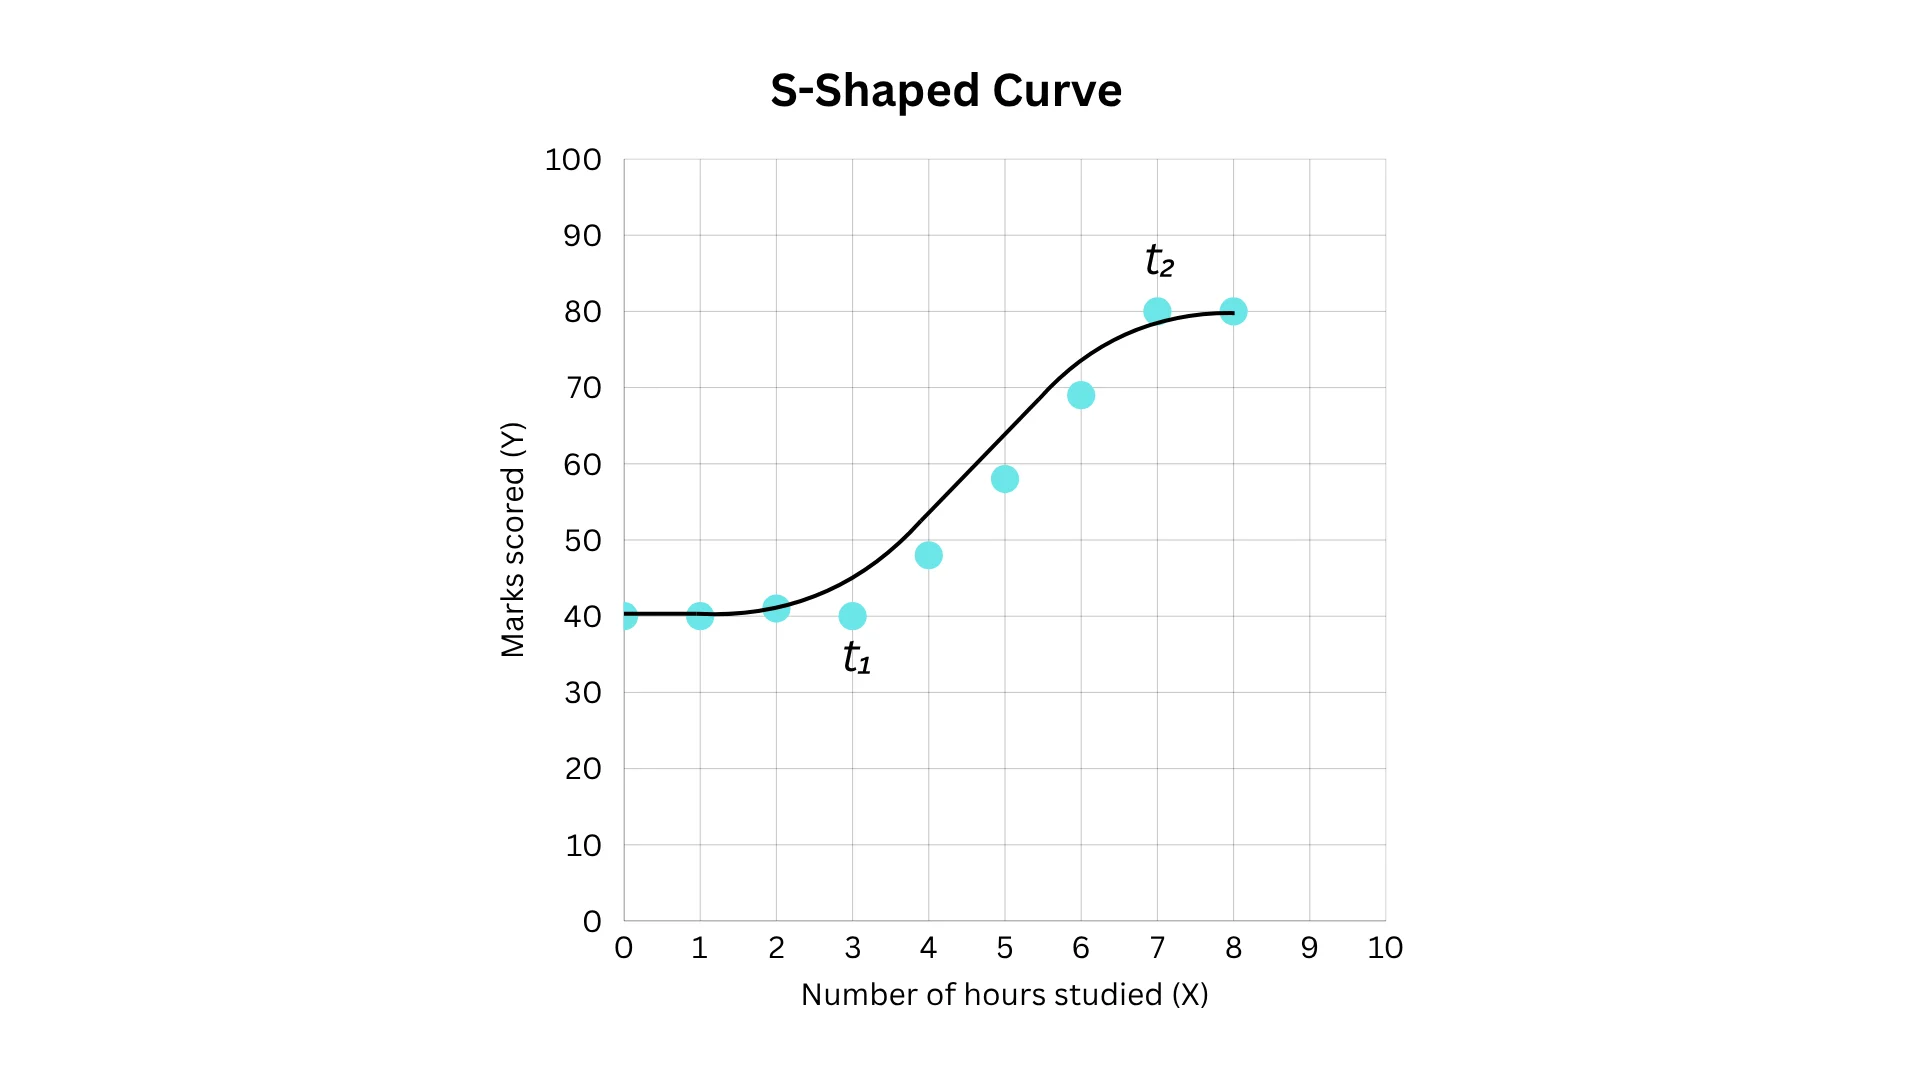
یہ شکل ظاہر کرتی ہے کہ جب کوئی طالب علم t₁ گھنٹے تک پڑھتا ہے، تو اسکور تقریباً ایک جیسا رہتا ہے۔ پھر ایک ڈھلوان ہے کیونکہ جیسے جیسے سیکھنے کا وقت t₁ سے t² تک بڑھتا ہے اسکور بڑھتا جاتا ہے۔ یہ آخر کار ٹی 2 پر دوبارہ سطح پر آجاتا ہے۔ یہ منتقلی بتدریج اور مسلسل ہوتی ہے، ٹکڑا وار لکیری منحنی خطوط کے برعکس جو سادہ سیدھی لکیروں کا استعمال کرتے ہوئے سمت بدلتی ہے۔
محترمہ پولی کے کھینچے ہوئے منحنی خطوط بے ترتیب نمونے نہیں ہیں۔ اس کا اظہار ریاضیاتی طور پر بھی کیا جا سکتا ہے۔ اس قسم کی شکل پیدا کرنے والی خصوصیات میں سے ایک ہے۔ سگمائڈ فنکشن
سگمائڈ فنکشن کیا ہے؟
سگمائیڈ فنکشن ایک ریاضیاتی فارمولہ ہے جو ایک حقیقی قدر والا ان پٹ لیتا ہے اور اسے 0 اور 1 کے درمیان کی قدر پر نقشہ بناتا ہے۔ یہ 0 کے قریب قدروں پر آہستہ آہستہ بڑھتا ہے، درمیانی قدروں پر تیزی سے بڑھتا ہے، اور آہستہ آہستہ 1 کے قریب اقدار پر سطح مرتفع ہوتا ہے۔
y = σ(x) = 1 / (1 + exp(-x))
نیچے کا گراف سگمائیڈ فنکشن کو ظاہر کرتا ہے۔
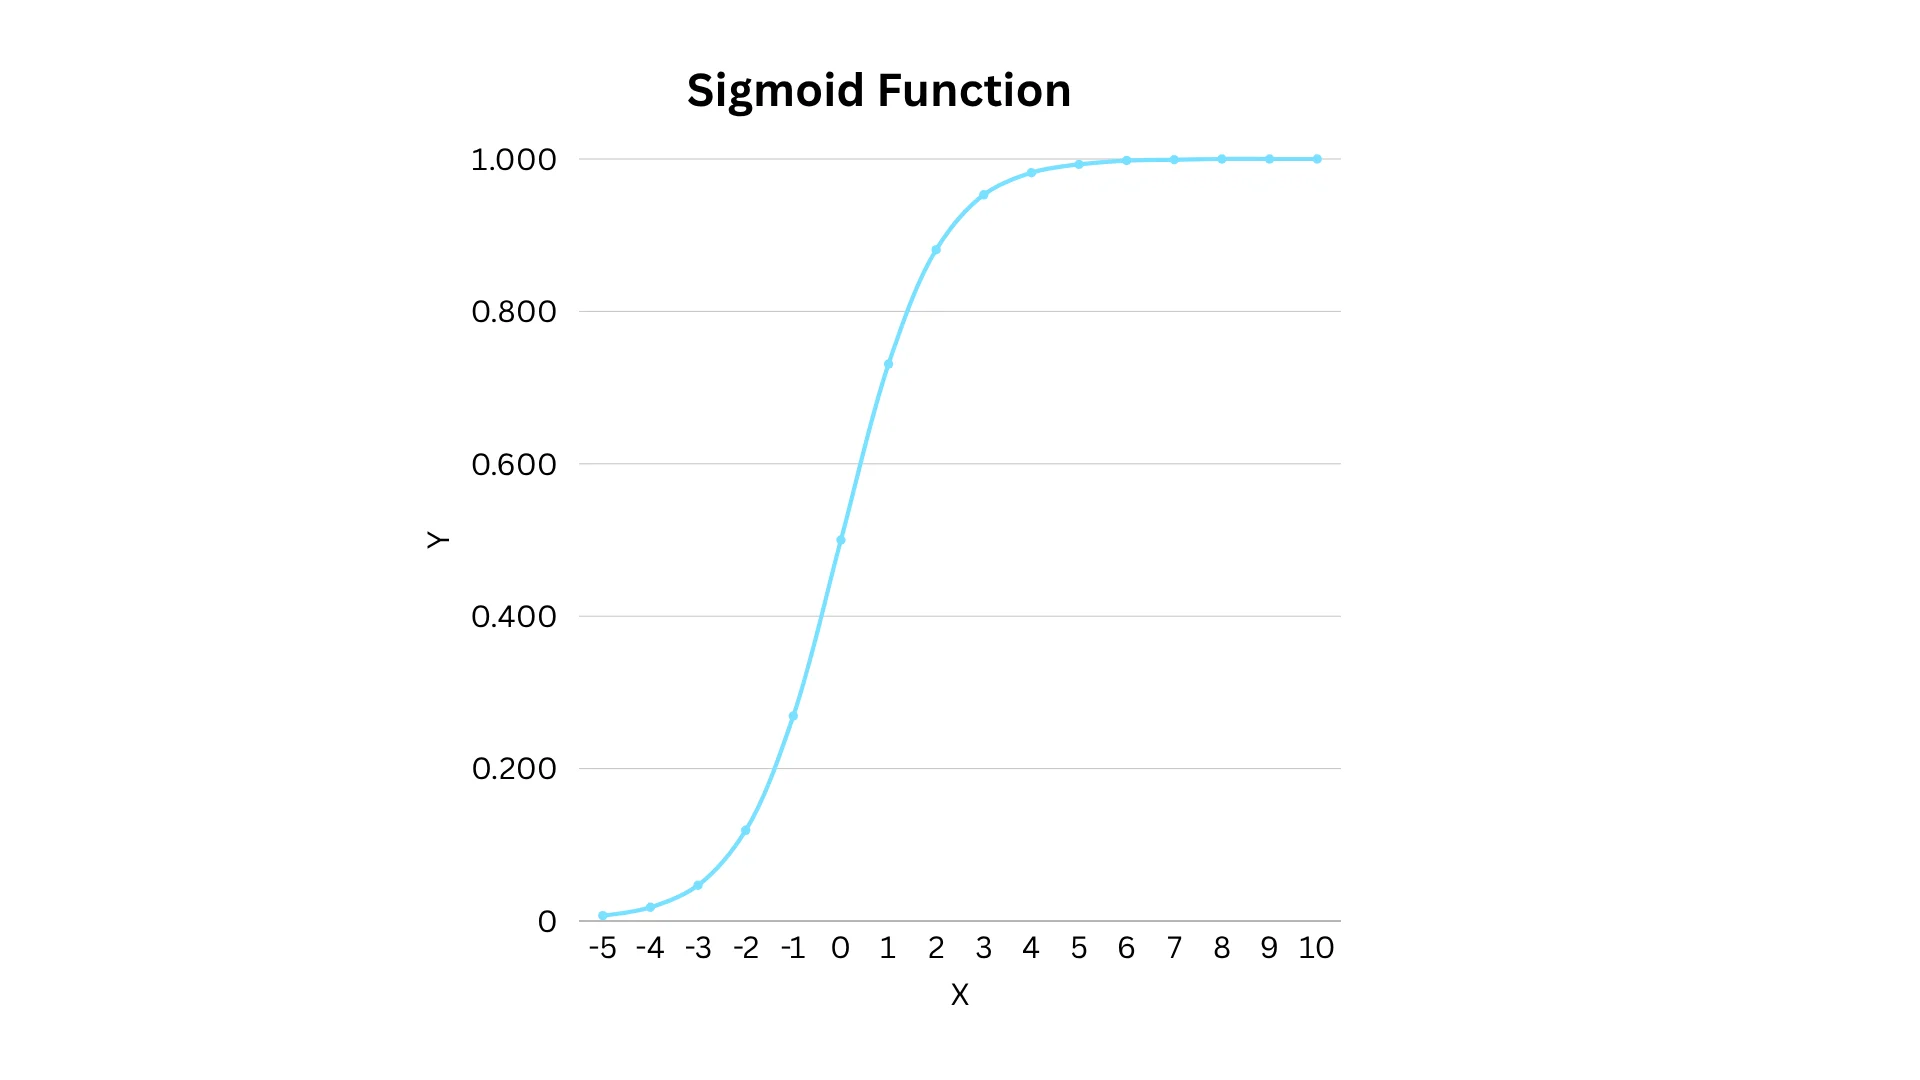
عصبی نیٹ ورکس میں سگمائیڈ فنکشن اہم ہے کیونکہ یہ نان لائنیرٹی کو متعارف کرواتے ہوئے آؤٹ پٹ کو 0 اور 1 کے درمیان محدود کرتا ہے۔ یہ اس وقت کارآمد ہوتا ہے جب آؤٹ پٹ کو کسی امکان کی نمائندگی کرنے کی ضرورت ہو، جیسے کہ طالب علم کے امتحان میں کامیاب ہونے کا امکان۔ زیادہ سگمائیڈ آؤٹ پٹ کا مطلب ہے کہ طالب علم کے پاس ہونے کا زیادہ امکان ہے، اور اس کے برعکس۔
گہری عصبی نیٹ ورک ماڈلنگ
محترمہ پولی کو اب گہرے نیورل نیٹ ورکس کو ماڈل بنانے کے لیے لکیری اور غیر لکیری مساوات کے تصورات کو یکجا کرنے کی ضرورت ہوگی۔ اسے دو الگ الگ طریقے اختیار کرنے چاہئیں۔
-
اپنے ٹیسٹ کے اسکور کی پیشن گوئی کریں۔
-
امتحان پاس/فیل کی پیشن گوئی
وہ دو انتہائی آسان غیر تربیت یافتہ نیورل نیٹ ورکس کا استعمال کرتی ہے جس میں ہر ایک کے لیے دستی طور پر منتخب وزن اور تعصبات ہوتے ہیں۔ وہ یہ بتانے کی کوشش کر رہی ہے کہ حساب کیسے کام کرتا ہے۔ حقیقت میں، اس نے خود پیرامیٹرز کا انتخاب نہیں کیا۔ اس نے تربیت کے دوران سیکھے گئے وزن اور تعصبات کے ساتھ نیٹ ورک قائم کیا جس میں پیش گوئی شدہ اقدار کا حقیقی قدروں سے بار بار موازنہ کیا گیا اور غلطیوں کو کم کرنے کے لیے پیرامیٹرز کو ایڈجسٹ کیا۔
ReLU کا استعمال کرتے ہوئے پیشین گوئی کو نشان زد کریں۔
مرحلہ 1: نیٹ ورک سیٹ اپ
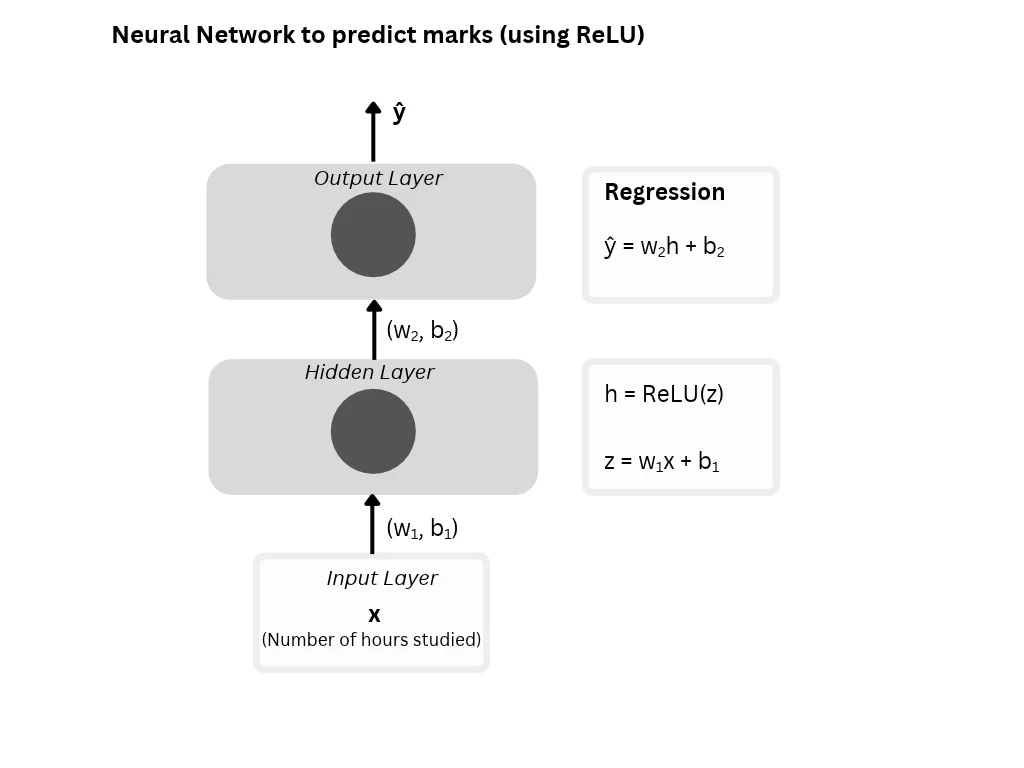
محترمہ پولی نے درج ذیل سادہ مساوات کا استعمال کرتے ہوئے ایک گہرا نیورل نیٹ ورک قائم کیا:
-
ان پٹ پرت: مطالعہ کیے گئے گھنٹوں کی تعداد (x) یہاں موصول ہوئی ہے۔
-
پوشیدہ پرت: لکیری تبدیلی اور ReLU ان پٹ پر لاگو ہوتے ہیں۔
z = w₁x + b₁, = x - 3 (w₁=1, b₁=-3) h = ReLU(z) = max(0, z) -
آؤٹ پٹ پرت: پوشیدہ پرت کے آؤٹ پٹ (h) پر ایک لکیری تبدیلی کا اطلاق کریں اور پھر اسکور کیے گئے اسکور کی پیشین گوئی کریں۔
ŷ = w₂h + b₂ = 10h + 40 (w₂=10, b₂=40)
مرحلہ 2: پیش گوئی شدہ نشانات کا حساب لگائیں۔
فرض کریں کہ وہ ایک طالب علم کے اسکور کا حساب لگاتی ہے جس نے 5 گھنٹے تک مطالعہ کیا۔ یہاں وہ یہ کیسے کرتی ہے:
z = w₁x + b₁, = x - 3 = 5 - 3 = 2
h = ReLU(z) = max(0, z) = max(0, 2) = 2
آخر میں، ہم پیشن گوئی کے اسکور کا حساب لگاتے ہیں۔
ŷ = w₂h + b₂ = 10h + 40 = 10(2) + 40 = 60
نیورل نیٹ ورک 60 نمبروں کی پیش گوئی کرتا ہے، جبکہ ڈیٹا سیٹ میں اصل نمبر 58 ہیں۔
مرحلہ 3: پیشین گوئی اور حقیقی اسکورز کا موازنہ کریں۔
محترمہ پولی عصبی نیٹ ورک کے ذریعہ پیش گوئی کی گئی تمام نمائندگی حاصل کرتی ہے اور پھر نیچے دیے گئے جدول میں اصل ڈیٹا سے ان کا موازنہ کرتی ہے۔
| وقت کا مطالعہ کیا | سکور سکور | پیشن گوئی کا نشان |
|---|---|---|
| 0 | 40 | 40 |
| 1 | 40 | 40 |
| 2 | 41 | 40 |
| 3 | 40 | 40 |
| 4 | 48 | 50 |
| 5 | 58 | 60 |
| 6 | 69 | 70 |
| 7 | 80 | 80 |
| 8 | 80 | 90 |
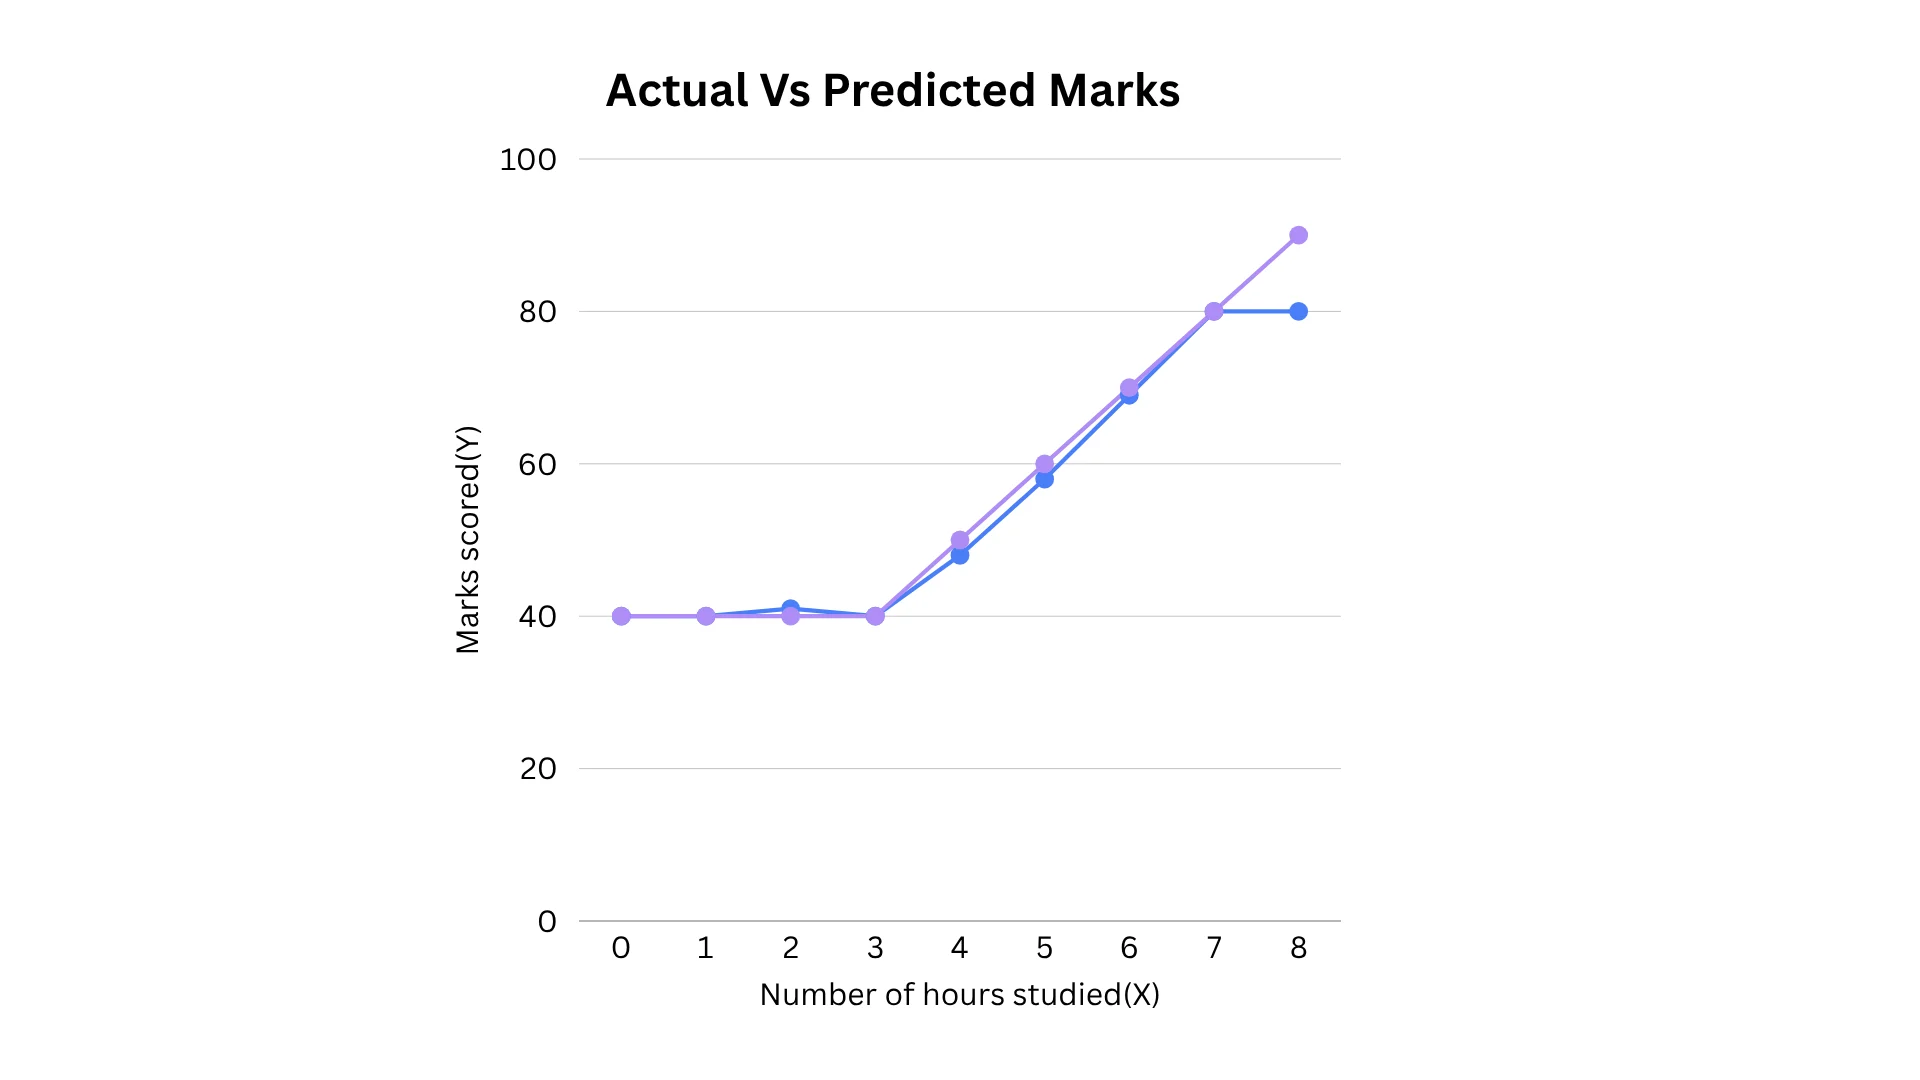
ہو سکتا ہے کہ اصل اور پیشین گوئی کے اشارے بالکل ایک جیسے نہ ہوں، لیکن وہ قریب ہیں۔ چونکہ ری ایل یو تھریشولڈ کے بعد قدر میں مسلسل اضافہ ہوتا رہتا ہے، اس لیے ڈسپلے میں اضافہ ہوتا رہتا ہے اور آخر کار برابر نہیں ہوتا۔
اس مثال کے ذریعے، محترمہ پولی نے دکھایا کہ کس طرح ReLU ڈیٹا میں غیر لکیری تعلقات کو ماڈل کرنے میں مدد کر سکتا ہے۔
ReLU اور Sigmoid کا استعمال کرتے ہوئے پاس/فیل کی پیشن گوئی
یہاں، محترمہ پولی ایک عصبی نیٹ ورک کا استعمال کرتے ہوئے یہ پیشین گوئی کرتی ہیں کہ آیا کوئی طالب علم فائنل امتحان پاس کرے گا یا فیل ہوگا۔ وہ فرض کرتی ہے کہ ایک طالب علم کو پاس ہونے کے لیے کم از کم 50 پوائنٹس اسکور کرنے چاہئیں۔ یہ نیٹ ورک امتحان پاس کرنے کے امکان کی پیش گوئی کرنے کے لیے استعمال ہوتا ہے۔
مرحلہ 1: نیٹ ورک سیٹ اپ
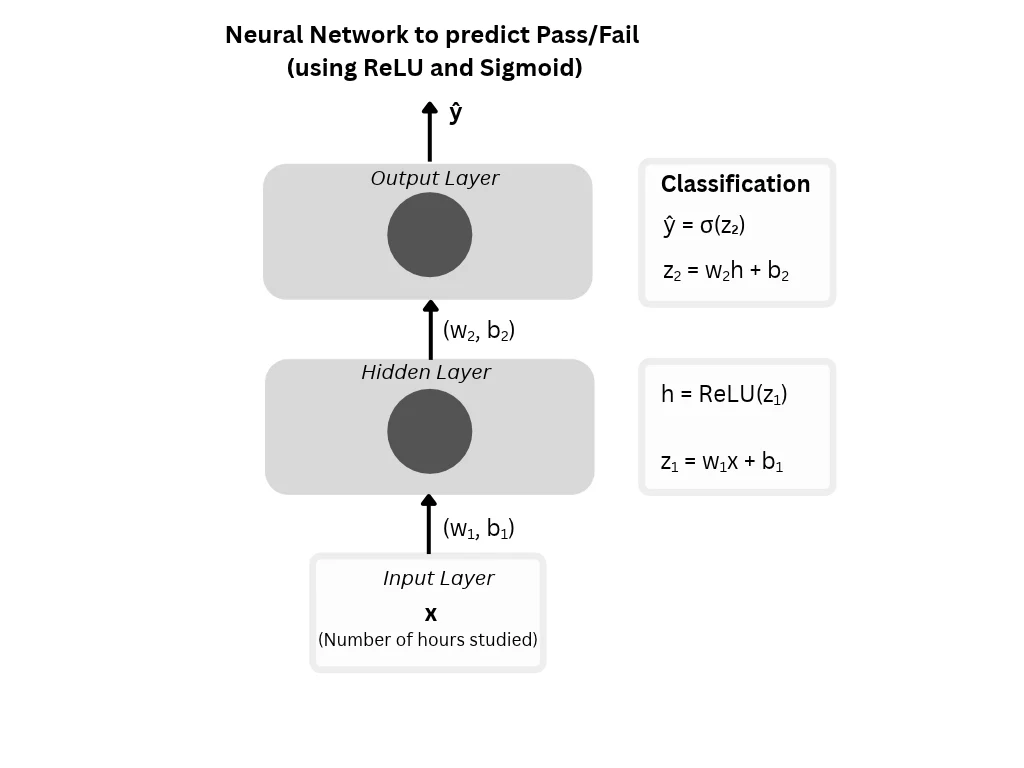
محترمہ پولی نے درج ذیل سادہ مساوات کا استعمال کرتے ہوئے ایک گہرا نیورل نیٹ ورک قائم کیا:
-
ان پٹ پرت: مطالعہ کیے گئے گھنٹوں کی تعداد (x) یہاں موصول ہوئی ہے۔
-
پوشیدہ پرت: لکیری تبدیلی اور ReLU ان پٹ پر لاگو ہوتے ہیں۔
z₁ = w₁x + b₁, = x - 4 (w₁=1, b₁=-4) h = ReLU(z₁) = max(0, z₁) -
آؤٹ پٹ لیئر: پوشیدہ پرت کے آؤٹ پٹ (h) کی لکیری تبدیلی پر سگمائڈ ایکٹیویشن کا اطلاق کریں اور پھر پاس/فیل کی پیشین گوئی کریں۔
z₂ = w₂h + b₂ = 2h - 1      (w₂=2, b₂=-1)
p = σ(z₂) = 1 / (1 + exp(-z₂))
ŷ = Pass, if p >= 0.5
ŷ = Fail, if p < 0.5
مرحلہ 2: پاس/فیل پیشین گوئی کا حساب لگائیں۔
فرض کریں کہ وہ ایک طالب علم کے نتائج کی پیشین گوئی کرنا چاہتی ہے جس نے 3 گھنٹے تک مطالعہ کیا۔ یہاں وہ یہ کیسے کرتی ہے:
z₁ = w₁x + b₁, = x - 4 = 3 - 4 = -1
h = ReLU(z₁) = max(0, z₁) = max(0, -1) = 0
پیشن گوئی کریں کہ آیا کوئی طالب علم پاس/فیل ہوگا:
z₂ = w₂h + b₂ = 2h - 1 = 2(0) - 1 = -1
p = σ(z₂) = 1 / (1 + exp(-z₂)) = 1 / (1 + exp(-(-1))) ≈ 0.269
0.269<0.5 سے، طالب علم کا نتیجہ یہ ہے: ناکام.
اب، 5 گھنٹے مطالعہ کرنے کے بعد، طالب علم کے نتائج درج ذیل ہیں:
z₁ = w₁x + b₁, = x - 4 = 5 - 4 = 1
h = ReLU(z₁) = max(0, z₁) = max(0, 1) = 1
پیشن گوئی کریں کہ آیا کوئی طالب علم پاس/فیل ہوگا:
z₂ = w₂h + b₂ = 2h - 1 = 2(1) - 1 = 1
p = σ(z₂) = 1 / (1 + exp(-z₂)) = 1 / (1 + exp(-1)) ≈ 0.731
0.731>0.5 سے، طالب علم کا نتیجہ یہ ہے: پاس.
مرحلہ 3: پیشین گوئیوں اور حقیقی نتائج کا موازنہ کریں۔
| وقت کا مطالعہ کیا | سکور سکور | حقیقی نتائج | متوقع سکور | متوقع نتیجہ |
|---|---|---|---|---|
| 0 | 40 | ناکام | 0.269 | ناکام |
| 1 | 40 | ناکام | 0.269 | ناکام |
| 2 | 41 | ناکام | 0.269 | ناکام |
| 3 | 40 | ناکام | 0.269 | ناکام |
| 4 | 48 | ناکام | 0.269 | ناکام |
| 5 | 58 | پاس | 0.731 | پاس |
| 6 | 69 | پاس | 0.953 | پاس |
| 7 | 80 | پاس | 0.993 | پاس |
| 8 | 80 | پاس | 0.999 | پاس |
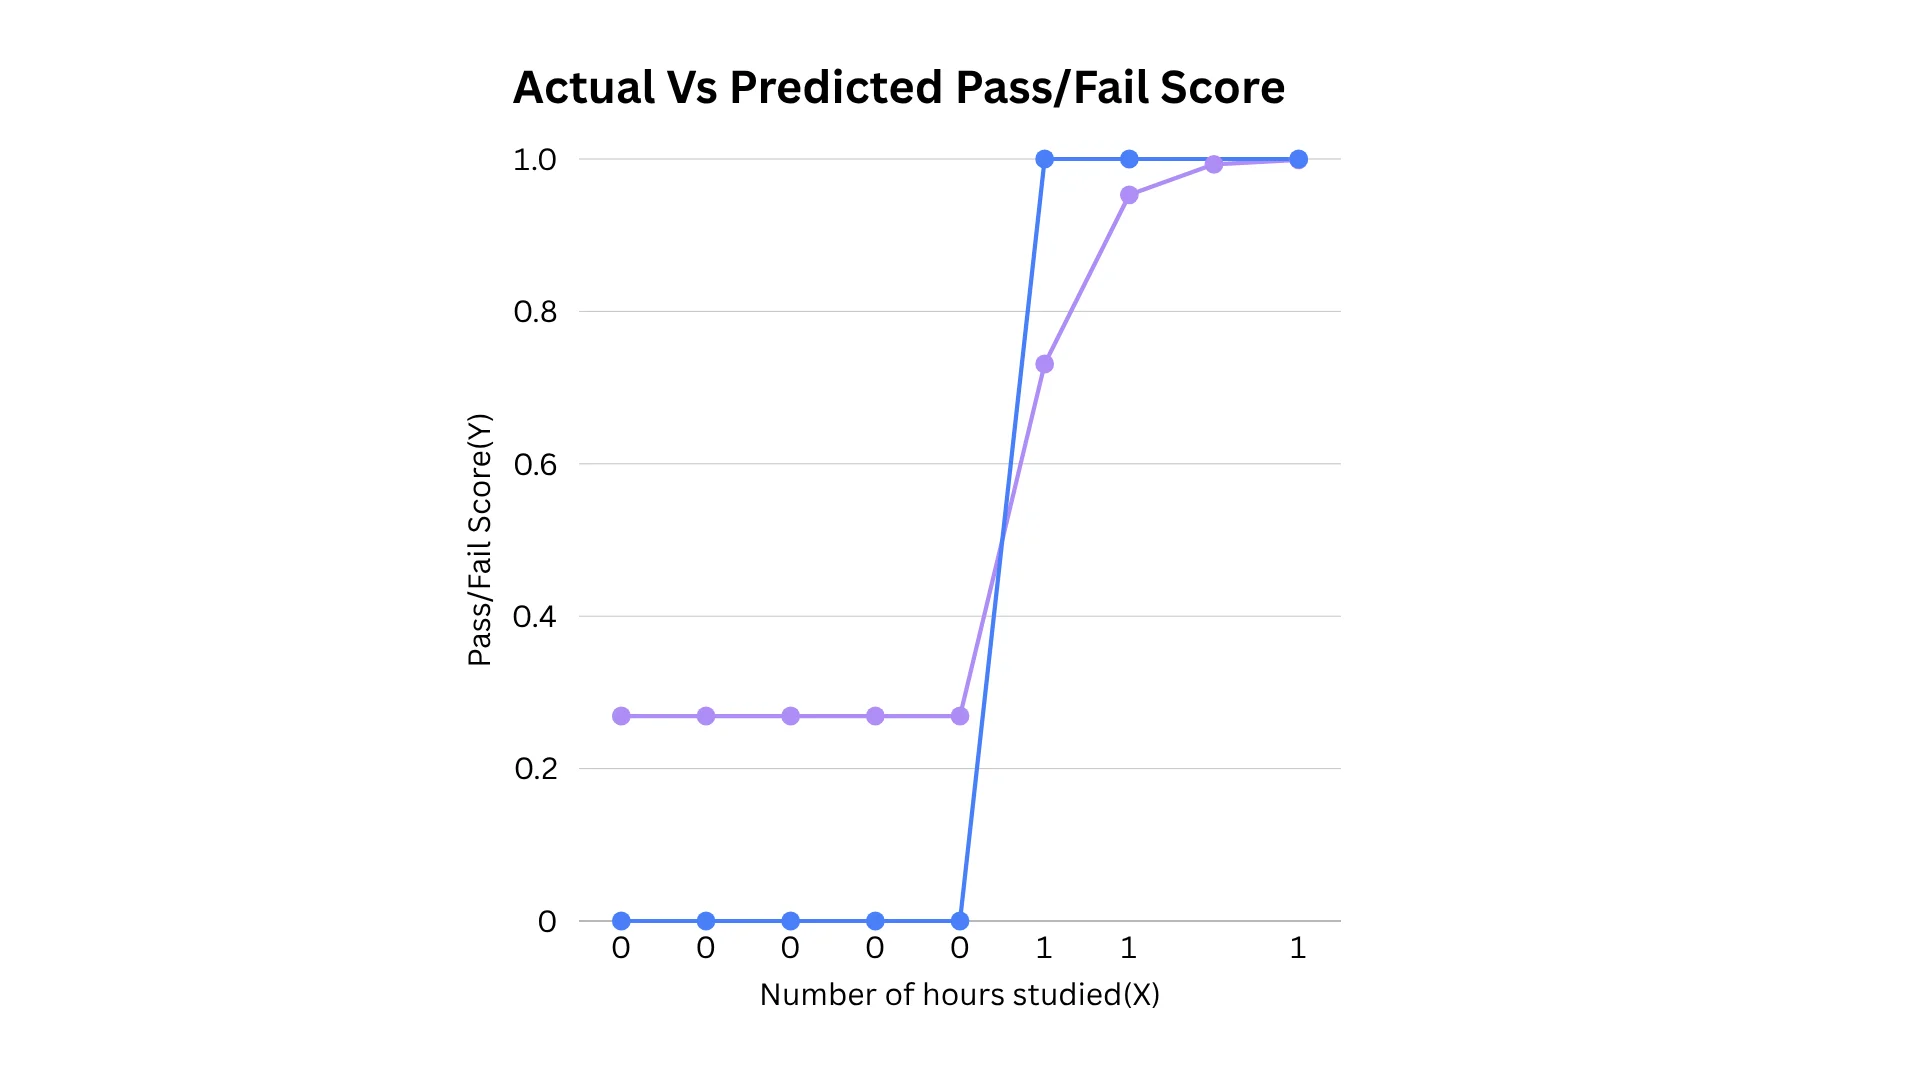
نیٹ ورک اس مثال میں تمام طلباء کے نتائج کی صحیح درجہ بندی کرتا ہے۔ جیسے جیسے مطالعہ کا وقت 4 گھنٹے سے زیادہ بڑھتا ہے، پیشین گوئی شدہ سکور بڑھتا ہے، جس سے گزرنا زیادہ قابلِ پیشگوئی ہوتا ہے۔
اس مثال کے ذریعے، محترمہ پولی نے دکھایا کہ کس طرح ReLU اور sigmoid ایک ساتھ کام کرتے ہیں۔ ReLU پوشیدہ پرت کے ان پٹ کو تبدیل کرتا ہے اور سگمائڈ آؤٹ پٹ کو اسکور میں تبدیل کرنے میں مدد کرتا ہے جسے پاس/فیل کی پیشن گوئی کے لیے استعمال کیا جا سکتا ہے۔
حتمی خیالات
اوپر دکھائی گئی سادہ مثال آپ کو عصبی نیٹ ورکس کے بارے میں اہم اصولوں کو سمجھنے میں مدد دے گی۔ آؤٹ پٹ اور ان پٹ کے درمیان تعلق ان پٹ کے مختلف حصوں میں مختلف طریقے سے برتاؤ کر سکتا ہے۔ حقیقی ڈیٹا سے بامعنی نتائج پیدا کرنے کے لیے، آپ کو اسے حاصل کرنے کی ضرورت ہے۔
اگر آپ کے ڈیٹا میں رشتے سادہ اور مستقل ہیں تو ایک سیدھی لائن مساوات کافی ہے۔ لیکن حقیقی ڈیٹا ہمیشہ اتنا آسان نہیں ہوتا ہے۔ غیر خطوطی کو متعارف کروا کر، عصبی نیٹ ورک لکیری تعلقات سے آگے بڑھ سکتے ہیں اور ڈیٹا میں چھپے پیچیدہ تعلقات کو سیکھ سکتے ہیں۔