
کلیدی ٹیک ویز
- چاروں بڑے AI انجن ایک جیسے تربیتی طریقوں (پری ٹریننگ، کمانڈ ٹیوننگ، اور افیونٹی آپٹیمائزیشن) کا اشتراک کرتے ہیں، لیکن ہر ایک کو مختلف نتائج کی طرف دیکھتے ہیں۔
- عوامی ترجیحات کی تربیت کا ڈیٹاسیٹ ایک دستاویزی تبدیلی کو ظاہر کرتا ہے کہ فیصلوں کو قبول یا مسترد کرنے سے پانچ محور والے درجہ بندی کے روبرک میں، نئے rubrics مزید ساختی فہرست جیسے جوابات کو انعام دینے کے لیے ظاہر ہوتے ہیں۔
- پریشانی اصل وقت کی تلاشوں اور حوالوں پر انحصار کرتی ہے۔ Claude کی خوبیاں گہری، طویل طرز کے استدلال سے آتی ہیں، ChatGPT استعمال کے کیسز کی وسیع ترین رینج کا احاطہ کرتا ہے، اور Gemini کی خوبیاں Google کے اپنے ماحولیاتی نظام تک مقامی رسائی سے آتی ہیں۔
- فریق ثالث کے بینچ مارک ٹیسٹ ہر چند مہینوں میں تبدیل ہوتے ہیں، اس لیے سنگل موازنہ کو مستقل درجہ بندی کے بجائے سنیپ شاٹس کے طور پر سمجھیں۔
- AI کی مرئیت کی پیمائش کا مطلب مطلوبہ الفاظ کی درجہ بندی کے ساتھ ساتھ حوالہ کی تعدد، برانڈ کا تذکرہ، اور ماخذ کے تنوع کو دیکھنا ہے۔
آپ پہلے ہی جان چکے ہیں کہ GEO کیا ہے۔ آپ نے تعریفیں پڑھی ہیں، LLMO موازنہ کا جائزہ لیا ہے، اور یہ بیان دیکھا ہے: "AI Search ہر چیز کو بدل رہی ہے۔” جو چیز اب بھی زیادہ تر مواد سے غائب ہے وہ پلیٹ فارم کے لیے مخصوص GEO ہے۔ یعنی، ChatGPT، Claude، Gemini، اور Perplexity یہ فیصلہ کرتے ہیں کہ کس چیز کو ظاہر کرنا ہے اس میں حقیقی مکینیکل فرق۔ کلائنٹ یہ سوال براہ راست پوچھ رہے ہیں، اور زیادہ تر رہنمائی "AI Search Optimization” کو چار کے بجائے ایک حکمت عملی کے طور پر مانتی ہے۔
اس سے پہلے کہ ہم مزید آگے بڑھیں، یہ بنیادی اصول ہیں: OpenAI، Anthropic، Google، اور Perplexity سے باہر کوئی بھی موجودہ درست فارمولوں کو نہیں جانتا جو یہ انجن مواد کی درجہ بندی کرنے یا منتخب کرنے کے لیے استعمال کرتے ہیں۔ یہ نظام ملکیتی ہیں اور رولنگ کی بنیاد پر چلتے ہیں۔ ہم جو کچھ کر سکتے ہیں وہ یہ ہے کہ ان نظاموں کے اشتراک کردہ دستاویزی میکانزم کو دیکھیں، جہاں وہ اصل میں مختلف ہیں، اور پلیٹ فارم بہ پلیٹ فارم کی بنیاد پر حکمت عملی اور پیمائش کے لیے اس کا کیا مطلب ہے۔
AI انجن ایک جیسے کیوں نہیں ہیں؟
مارکیٹ میں موجود تمام بڑے AI انجن اسی ترکیب کا ایک ورژن چلاتے ہیں۔ اس کا مطلب یہ ہے کہ متن کی بڑی مقدار پر پہلے سے تربیت، ماڈل کی سمت کی پیروی کو یقینی بنانے کے لیے کمانڈز کو ٹیوننگ کرنا، طرز عمل کی شکل دینے کے لیے ترجیحات کو بہتر بنانا، اور جب کوئی سوال پوچھے تو کیا تلاش کرنا اور درجہ بندی کرنا ہے اس بارے میں پروڈکٹ کی سطح کے فیصلے کرنا۔ یہ مشترکہ فاؤنڈیشن یہی وجہ ہے کہ پلیٹ فارم کے مشورے کے ذریعہ بہت سے GEO کی اصلاح قابل تبادلہ ہے۔ یہی وجہ ہے کہ جب کسی مخصوص انجن پر اصل میں تجربہ کیا جاتا ہے تو مشورہ کم کارکردگی کا مظاہرہ کرتا ہے۔
ہر انجن مشترکہ ترکیب کو ایک مختلف کام میں بدل دیتا ہے۔ چونکہ Perplexity نے اپنے مصنوع کو ماخذ پر مبنی تلاش کے ارد گرد بنایا ہے، اس لیے جوابات چیٹ بوٹ سے زیادہ ریسرچ اسسٹنٹ کی طرح پڑھتے ہیں۔ اس کا مطلب ہے کہ اس کا بہت زیادہ حوالہ دیا گیا ہے اور فی الحال ویب پر شائع ہونے والی ہر چیز پر مبنی ہے۔ Claude کو گہرائی سے کام کرنے کے لیے بنایا گیا ہے، کئی مراحل کے مسائل کے ذریعے استدلال کرنا، طویل دستاویزات میں سیاق و سباق کو سمجھنا، اور ایجنٹ طرز کے ورک فلو کے اندر اچھی طرح سے کام کرنا جو متعدد مراحل میں درستگی کو بڑھاتا ہے۔ ChatGPT گروپ کے سب سے بڑے سطحی رقبے کا احاطہ کرتا ہے، جس میں سب سے بڑی نصب شدہ بنیاد اور آواز، وژن اور ملٹی موڈل صلاحیتیں عام مقصد کے کور کے اوپر رکھی گئی ہیں۔ جیمنی کا سب سے بڑا فائدہ یہ ہے کہ آپ کا کام گوگل کے اپنے ایکو سسٹم کے اندر کسی بھی چیز کو چھوتا ہے، بشمول Docs، Sheets، YouTube، اور Workspace کا ڈیٹا جسے باقی تین نہیں دیکھ سکتے۔
اس میں سے کوئی بھی ذائقہ اچھا نہیں ہے۔ ایک عام "GEO بہترین پریکٹس” چیک لسٹ اسے مکمل طور پر یاد کرتی ہے۔ اس کی وجہ یہ ہے کہ ان سسٹمز کے درمیان فرق سطحی سطح کے طرز کے انتخاب سے نہیں، بلکہ اس بات سے آتا ہے کہ ہر سسٹم کیسے بنایا گیا ہے اور اسے انعامات کے لیے کیا بہتر بنایا گیا ہے۔
GenAI کس طرح فیصلہ کرتا ہے کہ اصل میں کیا کہنا ہے۔
ان نظاموں کے اندر فیصلے تین تہوں پر ہوتے ہیں، اور ان کو سمجھنے سے اس بات کی زیادہ تر وضاحت ہوتی ہے کہ باہر سے غیر متوقع رویہ ظاہر ہوتا ہے۔
تربیت کے وقت کی تشکیل یہ پہلے آتا ہے۔ ماڈل پری ٹریننگ کے دوران بھاری مقدار میں متن پڑھتا ہے، پھر انسٹرکشن ٹیوننگ کے ذریعے ہدایات پر عمل کرنے کا طریقہ سیکھتا ہے، اور پھر ترجیحی اصلاح (عام طور پر RLHF یا RLAIF) کے ذریعے، یہ سیکھتا ہے کہ انسان ریٹر دو جوابات میں سے کس کو ترجیح دے گا۔ یہ وہ مرحلہ ہے جہاں ماڈل کی بنیادی عادات قائم ہوتی ہیں۔ یعنی، یہ کتنا ہیجنگ کرتا ہے، کتنی تفصیل فراہم کرتا ہے، اور یہ بنیادی طور پر کتنا شائستہ لگتا ہے۔
تخمینہ وقت کا انتخاب اگلی بار جب آپ پرامپٹ بھیجیں گے تو ایسا ہوگا۔ ماڈل ایک چھانٹنے والی پرت یا انعامی ماڈل کے ذریعے امیدواروں کے جوابات کو اسکور اور وزن دیتا ہے، جو عام طور پر اوپر کے مراحل سے اسی انسانی ترجیحی فیصلوں پر تربیت یافتہ ہوتا ہے۔
پروڈکٹ ٹائم سرچ یہ وہ پرت ہے جو پلیٹ فارم کے لحاظ سے نمایاں طور پر مختلف ہوتی ہے۔ کچھ انجن اس وقت بیرونی ذرائع کو کھینچ لیتے ہیں جب صارف کوئی سوال پوچھتا ہے، ایک عمل جسے RAG کہا جاتا ہے یا تلاش میں اضافہ پیدا ہوتا ہے، جب کہ دوسرے ماڈل کے وزن پر پہلے سے لاگو نمونوں پر زیادہ انحصار کرتے ہیں۔ یہ پرت اس بارے میں بہت کچھ بتاتی ہے کہ کیوں کچھ پروڈکٹس سرچ انجن کی طرح محسوس ہوتے ہیں اور دوسروں کو بات چیت کی طرح۔
دو عوامی ڈیٹا سیٹ ترجیحی ٹیوننگ درجہ بندی کو نظریاتی کی بجائے ٹھوس بناتے ہیں۔ اینتھروپک نے 2022 میں hh-rlhf شائع کیا۔ یہاں 169,000 قطاریں ہیں، جن میں سے ہر قطار انسانی ریٹر کی طرف سے ترجیحی دو جوابات کے لیے بائنری کال ہے۔ Nvidia’s HelpSteer2، جو 2024 میں ریلیز ہوا، ایک نہیں بلکہ پانچ الگ الگ محوروں کے جوابات کا جائزہ لیتا ہے: افادیت، درستگی، مستقل مزاجی، پیچیدگی، اور لفظی۔
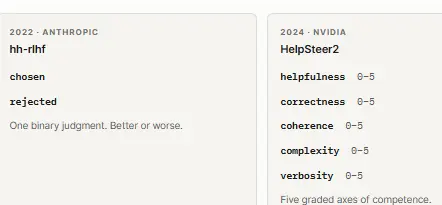
دونوں فائلوں کے آزادانہ تجزیے سے پتا چلا ہے کہ ہیلپ سٹیر2 کے پانچ محور والے روبرک سے پتہ چلتا ہے کہ فہرست کی طرح گنتی کے جوابات نے زیادہ تر جوڑوں کی جانچ کی ہے۔ یہ ایک قابل فہم جزوی وضاحت ہے کہ کیوں AI سے تیار کردہ جوابات کو بنیادی طور پر بلٹ پوائنٹس اور نمبر والے اقدامات کے طور پر پیش کیا جاتا ہے، لیکن یہ ان کے ساتھ سخت حقائق کے بجائے باخبر نتائج کے طور پر برتاؤ کرنے کے قابل ہے۔ تجزیہ کرنے والے محقق نے تجزیہ کو یکساں انداز میں ترتیب دینے میں محتاط تھا۔
ایک انتباہ خود ڈیٹا سے زیادہ اہم ہے۔ کوئی بھی فائل اس بات کی عکاسی نہیں کرتی ہے کہ انتھروپک یا Nvidia آج اپنے ماڈلز کو کس طرح تربیت دیتے ہیں۔ یہ موجودہ انجن کی درجہ بندی کی منطق کا حقیقی وقت کا نقشہ نہیں ہے، بلکہ ایک مخصوص لیب میں ایک مخصوص سال کا تاریخی تصویر ہے۔ اسے جو کچھ ہو رہا ہے اس کے لیے ایک مخصوص شیٹ کے طور پر نہیں، بلکہ کم از کم ان دستاویزی صورتوں میں، affinity ٹیوننگ کے کام کرنے کے لیے ایک مفید اور قابل اقتباس ونڈو کے طور پر سمجھیں۔
انجن کے ذریعے تبدیلیاں
الجھن: ذرائع کے ساتھ جوابی جوابات کے لیے بنایا گیا ہے۔
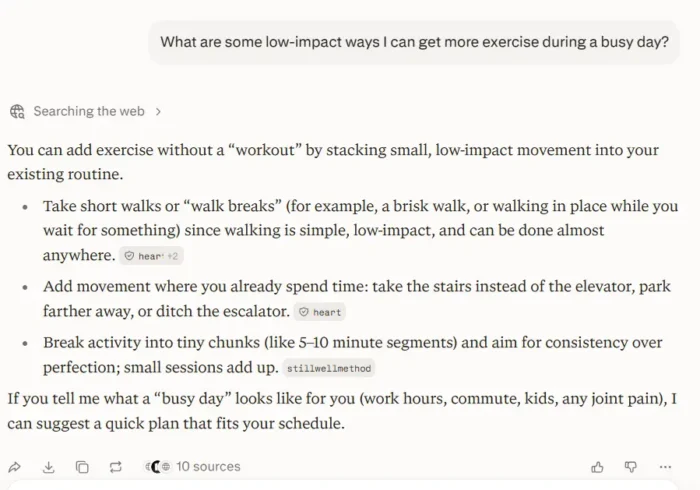
Perplexity کا پورا پراڈکٹ حوالہ جات اور نئی تلاشوں کے ارد گرد ہوتا ہے، جو آؤٹ پٹ میں دکھائے جاتے ہیں۔ یکساں پرامپٹ پلیسمنٹ کے ذریعے ChatGPT، Claude، Gemini، اور Perplexity کو چلانے والے آزاد ٹیسٹ حوالہ جات کی درستگی اور حقیقی وقت کی بنیاد پر مسلسل Perplexity کو اعلیٰ درجہ دیتے ہیں۔ یہ بنیادی طور پر تربیتی ڈیٹا پر انحصار کرنے کے بجائے استفسار کے وقت لائیو ویب سے کیا نکالا جاتا ہے اس کا پتہ لگاتا ہے۔ جہاں یہ مختصر ہوتا ہے وہ تخلیقی یا طویل شکل میں ہوتا ہے۔ جب آپ کسی مکمل مضمون کے مسودے کی درخواست کرتے ہیں، تو آؤٹ پٹ پالش کے بجائے فعال پڑھنے کا رجحان رکھتا ہے۔
کلاڈ: گہرائی کے لیے بنایا گیا ہے۔
کلاڈ ان کاموں میں سب سے زیادہ مضبوط ہوتا ہے جس میں بہت زیادہ سیاق و سباق اور محتاط استدلال کی ضرورت ہوتی ہے۔ ٹیسٹ راؤنڈ جو انشانکن کو ٹریک کرتے ہیں، جس کا مطلب ہے کہ ماڈل کا اعتماد کتنی بار درست ہے، نے بار بار کلاڈ کو فیلڈ سے آگے رکھا ہے، خاص طور پر ان دعووں میں جہاں غلط ہونا حقیقت میں اہمیت رکھتا ہے۔ گہرائی اور توجہ کا یہ امتزاج ایک بڑی وجہ ہے کہ ٹیمیں فوری جوابات کے بجائے طویل شکل والے مواد اور کثیر مرحلہ ایجنٹ ورک فلو کے لیے Claude پر انحصار کرتی ہیں۔
ChatGPT: بڑے پیمانے پر استعمال کے لیے بنایا گیا ہے۔
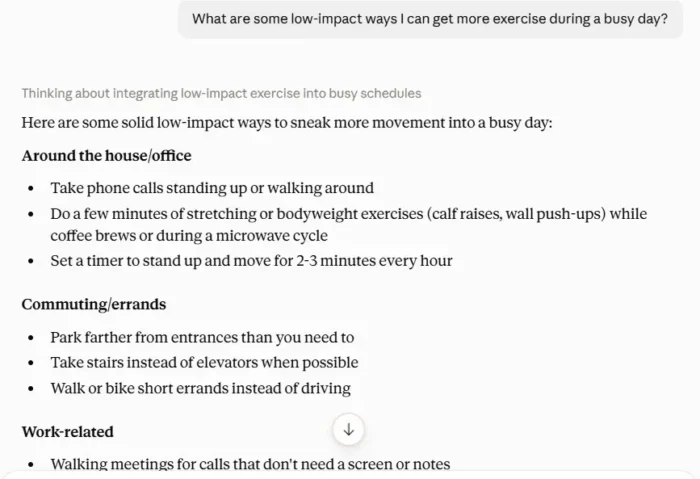
چیٹ جی پی ٹی کے پاس اب بھی گروپ کا سب سے بڑا انسٹال بیس اور وسیع ترین فیچر سیٹ ہے، آواز، وژن، تصویر کی تخلیق، نیویگیشن، اور عام مقصد کے کور پر پرتوں والے پلگ انز کی ایک لمبی فہرست۔ یہ وسعت ایک حقیقی فائدہ ہے۔ کئی آزاد ٹیسٹرز نوٹ کرتے ہیں کہ آؤٹ پٹ کا معیار دیگر تینوں سے زیادہ اتار چڑھاؤ آتا ہے، یہاں تک کہ تفصیلی پیغامات کے بغیر۔ یہ یہاں سب سے زیادہ لچکدار ٹول ہے، اور لچک دونوں طریقوں سے چلتی ہے۔

Gemini: Google Ecosystem کے لیے بنایا گیا ہے۔
جیمنی کے فوائد شاذ و نادر ہی خام ماڈل کے معیار میں دیکھے جاتے ہیں۔ آپ کا کام اس وقت ظاہر ہوگا جب یہ Gmail، Docs، Sheets، یا YouTube سے ٹکرائے گا، اور Gemini دراصل آپ کے ڈیٹا کو پڑھ سکتا ہے اور صرف خلاصہ میں اس کے بارے میں بات کرنے کے بجائے اس پر عمل کرسکتا ہے۔ Google Workspace میں پہلے سے رہنے والی ٹیموں کے لیے، رسائی معمول کے مطابق بینچ مارک سکور سے زیادہ اہم ہے۔
بڑے ٹیک وے کو سادہ رکھیں۔ ان چاروں میں سے کوئی بھی مجموعی طور پر نہیں جیتتا، اور اس فیلڈ میں سب سے زیادہ قابل اعتماد ٹیسٹ کسی ایک فاتح کا انتخاب نہیں کرتے، بلکہ اس کے کسی ایسے ورژن پر پہنچتے ہیں جو کام کے لیے موزوں دو یا زیادہ ٹولز کا استعمال کرتا ہے۔ اس مفروضے کو ہر چند ماہ بعد دوبارہ دیکھیں۔ درجہ بندی بدل گئی ہے اور پچھلی سہ ماہی کا لیڈر بورڈ اب اس سہ ماہی کا لیڈر بورڈ نہیں ہے۔

حکمت عملی جو انجن کے لحاظ سے مختلف ہوتی ہے۔
یہ وہ جگہ ہے جہاں یہ واقعی لاگو ہوتا ہے۔ مندرجہ بالا میکانکس اور پوزیشن کے فرق کو سمجھنا حکمت عملی کی تبدیلیوں کو من مانی محسوس کرنے سے روکتا ہے۔ وہ براہ راست اس کی پیروی کرتے ہیں جو ہر انجن اصل میں معاوضہ دیتا ہے۔
شرمندگی: ماخذ کے ساتھ رہنمائی کریں۔
چونکہ Perplexity تلاش پر مرکوز ہے، اس لیے ہم حقائق پر مبنی، ماخذ سے بھرپور مواد کو ترجیح دیتے ہیں جو براہ راست آپ کے استفسار سے میل کھاتا ہے۔ اصل تحقیق، حوالہ کردہ اعداد و شمار، اور واضح طور پر منسوب دلائل قائل نقل سے بہتر کارکردگی کا مظاہرہ کرتے ہیں۔ اپنے مواد کو منظم کریں تاکہ ریئل ٹائم جوابات کی بازیافت کرنے والے سسٹم آس پاس کے سیاق و سباق کے بغیر صاف، خود ساختہ وضاحتیں حاصل کر سکیں۔
کلاڈ: ساخت اور پی او وی کے ساتھ معروف
کلاڈ سطح کی چوڑائی سے زیادہ گہرائی کو انعام دیتا ہے، لہذا مضبوط عنوانات، واضح دلائل، اور تجرباتی نقطہ نظر کے ساتھ طویل شکل کا مواد یہاں ایک ہی علاقے کا احاطہ کرنے والی اتلی فہرستوں سے زیادہ کرشن حاصل کرتا ہے۔ اگر آپ کو اس حکمت عملی کو عملی جامہ پہنانے کا حقیقی تجربہ ہے جس کے بارے میں آپ لکھ رہے ہیں، تو براہ کرم براہِ راست بتائیں۔ یہ اس قسم کے سگنلز ہیں جن کے بارے میں اس انجن کا اندازہ ہے۔ [Internal link suggestion: long-form content / E-E-A-T guide]
ChatGPT: لچک کے ساتھ قیادت کریں۔
چیٹ جی پی ٹی وسیع ترین سطح پر جوابات فراہم کرتا ہے، اس لیے مواد جو مکمل وضاحت کے طور پر کام کرتا ہے اور مختصر میں، زیادہ دانے دار ٹکڑوں کا یہاں زیادہ سفر ہوتا ہے۔ بات چیت کی فریمنگ سے بھی مدد ملتی ہے، کیونکہ ChatGPT ٹریفک کا ایک اہم حصہ ایک سوال کے بجائے فالو اپ سوالات سے آتا ہے۔
Gemini: مادہ اور ساخت کے ساتھ سیسہ
جیمنی کا فائدہ گوگل کے ماحولیاتی نظام سے آتا ہے۔ اسی لیے گوگل کے اپنے سسٹمز خاص طور پر اندرونی مرئیت کو بہتر بناتے ہیں، بشمول کلین آبجیکٹ کی تعریفیں، سٹرکچرڈ ڈیٹا، اور اسکیما مارک اپ جو آپ کو یہ سمجھنے میں مدد کرتے ہیں کہ آپ کا مواد اصل میں کیا ہے۔ یہ قائل کرنے والی تحریر کے بارے میں کم اور آپ کے مواد کو ان سسٹمز کے ذریعے پڑھنے کے قابل بنانے کے بارے میں زیادہ ہے جو پہلے سے ہی Google کی دیگر مصنوعات میں آپ کے برانڈ ڈیٹا کو اسٹور کرتے ہیں۔
یہاں ایک اور فرق یہ ہے کہ حقیقی اسپیس ویلیو ہے۔ کیونکہ یہ اس ٹکڑے کے سب سے زیادہ عملی نکات میں سے ایک ہے۔ یہ انجن اسی طرح ذرائع کا وزن نہیں کرتا ہے۔ کچھ برانڈ کی اپنی سائٹ کے مواد پر زیادہ انحصار کرتے ہیں۔ دوسرے تیسرے فریق کے تذکروں اور آؤٹ لیٹس کے حوالہ جات پر زیادہ انحصار کرتے ہیں جن پر برانڈ کنٹرول نہیں کرتا ہے۔ اس سے قطع نظر کہ پبلشر کون ہے، سادہ نثر کے مقابلے ڈیٹا کی زیادہ ساختی اسکیما نمائندگی ہے۔ یہ جاننا کہ دیئے گئے انجن کے لیے کون سے لیور سب سے اہم ہیں اس بات پر منحصر ہے کہ آپ اپنا وقت کہاں گزارتے ہیں۔ اس کا مطلب ہے کہ آپ کے اپنے ڈومین پر مزید شائع کرنے، فریق ثالث کے مزید حوالہ جات حاصل کرنے، یا اپنے موجودہ مواد کو پارس کرنا آسان بنانے کے لیے سٹرکچرڈ ڈیٹا میں سرمایہ کاری کریں۔
انجن کی وسیع کارکردگی کو ٹریک کرنے کے لیے KPIs
روایتی رینک ٹریکنگ AI جوابات کو صاف ستھرا نقشہ نہیں بناتی، لہذا SEO کے بجائے GEO کو پلیٹ فارم کے ذریعے بہتر بنانے کے لیے پیمائش کے مختلف سیٹ کی ضرورت ہوتی ہے۔
حوالہ فریکوئنسی کے ساتھ شروع کریں۔ اس طرح اکثر آپ کے مواد کا صرف تذکرہ نہیں کیا جاتا بلکہ اصل میں ان انجنوں میں ایک ذریعہ کے طور پر حوالہ دیا جاتا ہے۔ ہم برانڈ کے تذکروں کو الگ سے ٹریک کرتے ہیں کیونکہ اگر وہ AI جوابات میں نام کے ساتھ ظاہر ہوتے ہیں تو وہ بغیر اقتباس کے بھی قیمتی ہوتے ہیں۔ یقینی بنائیں کہ آپ کا مواد براہ راست جواب کے خلاصے میں شامل ہے یا کسی ثانوی لنک کی طرف دھکیل دیا گیا ہے جسے تلاش کرنے کے لیے صارفین کو کلک کرنا چاہیے۔ اس کی وجہ یہ ہے کہ تقرری کے فرق یہاں روایتی تلاشوں کی نسبت زیادہ اہم ہیں۔
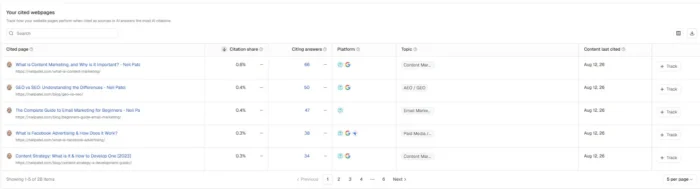
ماخذ کا تنوع استفسار کی سطح پر ٹریک کرنے کے قابل ہے۔ یعنی، ایک خاص انجن دلچسپی کے موضوعات کے لیے کتنے انفرادی ڈومینز کھینچتا ہے، اور آیا آپ کا برانڈ مستقل طور پر ان میں سے ایک ہے۔ یہاں، مطلوبہ الفاظ کی مماثلت سے زیادہ اہم تلاش کی اصطلاح میچ کا معیار ہے۔ دیکھیں کہ آپ کا مواد اصل پیغامات کے کتنے قریب سے نقشہ بناتا ہے جو لوگ ٹائپ کر رہے ہیں، نہ کہ صرف ان مطلوبہ الفاظ کو جن کو آپ نشانہ بنا رہے ہیں۔
مواد کی تازگی، خاص طور پر تلاش کے بھاری انجنوں جیسے Perplexity، متاثر کر سکتی ہے کہ آپ کو جواب ملتا ہے یا نہیں، اس بات پر منحصر ہے کہ آپ نے اپنے صفحہ کو کتنی حال میں اپ ڈیٹ کیا ہے۔ ان میٹرکس میں سے کوئی بھی KPIs کی جگہ نہیں لیتا ہے جنہیں آپ پہلے سے ٹریک کر رہے ہیں۔ وہ آپ کو ایک مکمل تصویر دینے کے لیے ساتھ ساتھ بیٹھتے ہیں کہ آیا آپ کا مواد وہیں دکھائی دے رہا ہے جہاں خریدار درحقیقت سوالات پوچھ رہے ہیں۔
اکثر پوچھے گئے سوالات
کیا ChatGPT، Claude، Gemini اور Perplexity ایک ہی درجہ بندی الگورتھم استعمال کرتے ہیں؟
نہیں چاروں ایک جیسی ٹریننگ بیس، پری ٹریننگ، گائیڈنس ٹیوننگ، اور افیونٹی آپٹیمائزیشن کا اشتراک کرتے ہیں، لیکن ہر پروڈکٹ ان سب سے اوپر مختلف تلاش اور درجہ بندی کے انتخاب پیش کرتا ہے۔ یہی وجہ ہے کہ ایک ہی سوال مختلف پلیٹ فارمز پر مختلف جوابات دے سکتا ہے۔
RLHF کیا ہے اور GEO کے لیے یہ کیوں ضروری ہے؟
RLHF کا مطلب ہے Reinforcement Learning with Human Feedback۔ ایک انسانی ریٹر ممکنہ ردعمل کی درجہ بندی کرتا ہے، اور ماڈل کو ان اشیاء کے حق میں ترتیب دیا جاتا ہے جو ریٹر کو ترجیح دیتے ہیں۔ یہ GEO کے لیے اہم ہے کیونکہ یہ ماڈل کو ایک "اچھا” جواب سمجھتا ہے، جس میں کم از کم کچھ دستاویزی صورتوں میں، زیادہ ساختی فہرست طرز کے مواد کی ترجیح شامل ہے۔
کیا GEO AI پلیٹ فارمز کے درمیان مختلف ہے؟
جی ہاں، نمایاں طور پر. چونکہ ہر انجن مختلف نتائج کے لیے بہتر بناتا ہے اور مختلف ذرائع سے حاصل کرتا ہے، اس لیے ایک واحد عام GEO چیک لسٹ پلیٹ فارم کے لیے مخصوص نقطہ نظر سے بدتر کارکردگی کا مظاہرہ کرے گی۔
نتیجہ
میکانزم انجن سے دوسرے انجن میں مختلف ہوتے ہیں، اور یہ تبدیل نہیں ہوگا کیونکہ یہ مصنوعات تیار ہوتی رہتی ہیں۔ لیکن مقصد چار بلیک باکسز پر عبور حاصل کرنا کبھی نہیں تھا۔ خیال یہ ہے کہ باخبر، پلیٹ فارم کے لیے مخصوص شرط لگانے کے لیے مشترکہ بنیاد کو اچھی طرح سمجھ لیا جائے، اور پھر حالات کے بدلتے ہی ان شرطوں کو دوبارہ دیکھیں۔
یہ بالکل وہی ہے جو ہم NP ڈیجیٹل میں کرتے ہیں۔ خیال یہ ہے کہ یہ انجن عملی طور پر کیسے کارکردگی کا مظاہرہ کرتے ہیں، حقیقی دنیا کے اشارے کے خلاف آپ کے مواد کی جانچ کریں، اور ہر پلیٹ فارم کی تازہ کاری کے ساتھ اپنی حکمت عملی کو ایڈجسٹ کریں۔ ایک پلیٹ فارم کے ساتھ شروع کریں جہاں آپ کے خریدار پہلے ہی وقت گزار رہے ہیں، اوپر کا اطلاق کریں، اور اس کی پیمائش کریں۔ پھر وہاں سے پھیلائیں۔