
وقت گزرنے کے ساتھ، علم بہت سی مختلف شکلوں میں منتقل ہوتا رہا ہے۔ قدیم میسوپوٹیمیا (جدید دور کے عراق) میں تحریر کی ایجاد سے پہلے، قوانین، تاریخ، افسانے، گانے، اور دیگر معلومات نسل در نسل زبانی طور پر منتقل ہوتی تھیں۔ یہ ہدایات یا کہانی سنانے کے ذریعے کیا گیا تھا (خاص طور پر لوک کہانیوں اور وقت کے ساتھ پیش آنے والے واقعات)۔
تاہم، علم کی منتقلی کا ایک اور عام طریقہ استاد سے طالب علم تک ہے، رسمی یا غیر رسمی۔ ہم نے اسے سالوں میں دیکھا ہے۔ بائبل ریکارڈ کرتی ہے کہ یسوع نے اپنے مشن کے آغاز سے لے کر اپنی موت تک ہر روز 12 شاگردوں کو تعلیم دی۔ سقراط نے افلاطون کو پڑھایا۔ افلاطون نے ایتھنز میں ایک اکیڈمی قائم کی، جہاں اس نے 20 سال تک ارسطو کو پڑھایا۔ ارسطو نے سائنس، منطق اور سیاست میں انقلاب برپا کیا۔ اور فہرست جاری ہے۔
اس کی 21ویں صدی کی مثال گہری سیکھنے والی AI نسب ہے۔ 20 ویں صدی کے AI موسم سرما کے دوران، جب ہم سوچتے تھے کہ اعصابی نیٹ ورک ختم ہو چکے ہیں، اس استاد اور طالب علم کے سلسلے نے خواب کو زندہ رکھا۔
جیفری ہنٹن، جسے اے آئی کا باپ سمجھا جاتا تھا، ایک تجربہ گاہ چلاتا تھا اور یان لیکون، الیا سوٹسکیور اور دیگر کو پڑھاتا تھا۔ Yann LeCun نے convolutional neural networks (CNNs) ایجاد کیا، اور الیا سوٹسکیور نے سیف سپر انٹیلی جنس انکارپوریشن کے لیے روانہ ہونے سے پہلے OpenAI کی مشترکہ بنیاد رکھی۔
انسان سے انسان میں علم کی منتقلی کا تصور کافی واقف ہے، لیکن مشین سے مشین کے علم کی منتقلی کے بارے میں کیا خیال ہے؟ اسے "ماڈل ڈسٹلیشن” کہا جاتا ہے۔
اس مضمون میں، ہم تجزیہ کریں گے کہ ڈسٹلیشن کا ماڈل کیا ہے۔ ہم آپ کو یہاں استعمال ہونے والی تکنیکوں اور PyTorch کا استعمال کرتے ہوئے شروع سے لاگو کرنے کا طریقہ بتائیں گے۔
آخر تک، آپ سمجھ جائیں گے کہ چھوٹے، زیادہ موثر ماڈلز کو کیسے تربیت دی جائے اور کس طرح ڈسٹلیشن دیگر کمپریشن تکنیکوں جیسے کوانٹائزیشن اور پرننگ سے موازنہ کرتی ہے۔
جس کا ہم احاطہ کریں گے۔
شرائط
پیروی کرنے کے لیے آپ کو ضرورت ہو گی:
-
GitHub repository: پروجیکٹ کا مکمل نفاذ یہاں دستیاب ہے اور آپ کو اس پر عمل کرنے کے لیے اسے کلون کرنا ہوگا۔
-
ازگر کا بنیادی علم اور آبجیکٹ اورینٹڈ پروگرامنگ کے تصورات (جیسے کلاسز کے ساتھ کام کرنا)۔
-
گہری سیکھنے کے بنیادی اصولوں کا ایک جائزہ۔ آپ کو تصورات کو سمجھنے کی ضرورت ہے جیسے عہد، فارورڈ پروپیگیشن، نقصان کے افعال وغیرہ۔
-
PyTorch کی بنیادی باتیں: PyTorch ٹینسر اور ٹریننگ لوپس کا ایک بنیادی علم مددگار ثابت ہوگا جب ہم کوڈ کے ہر حصے کی وضاحت کرتے ہیں۔
-
ترقیاتی ماحول: آپ کے کمپیوٹر پر ازگر انسٹال ہونا ضروری ہے۔ میں اپنے ایڈیٹر کے بطور Visual Studio Code استعمال کروں گا، لیکن آپ اپنی پسند کا کوئی بھی ایڈیٹر یا IDE استعمال کر سکتے ہیں۔
-
ہارڈ ویئر: یہ پروجیکٹ نسبتاً چھوٹا ڈیٹا سیٹ استعمال کرتا ہے، لہذا ایک معیاری CPU اچھی طرح کام کرے گا۔
ماڈل ڈسٹلیشن کیا ہے؟
ماڈل ڈسٹلیشن (یا نالج ڈسٹلیشن) ایک ایسا طریقہ ہے جس کا مقصد ایک بڑے، انتہائی درست ماڈل کے سیکھے ہوئے رویے کو ایک چھوٹے، کمپیوٹیشنل طور پر موثر ماڈل میں منتقل کرنا ہے جو حقیقی دنیا کی تعیناتیوں کے لیے زیادہ موزوں ہے۔
ڈسٹلیشن ایک کمپریشن تکنیک ہے جس میں ایک چھوٹا ماڈل (جسے طالب علم کہا جاتا ہے) ایک بڑے، زیادہ پیچیدہ ماڈل (استاد) کے آؤٹ پٹ کی نقل کرنا سیکھتا ہے۔ طالب علم کے ماڈل کے لیے ہدف یہ ہے کہ وہ استاد کے قریب کارکردگی کی سطح کو حاصل کرے، جبکہ نمایاں طور پر کم پیرامیٹرز کا استعمال کرتے ہوئے، تعیناتی کو زیادہ موثر بنایا جائے۔ (ذریعہ)
ہمیں ماڈل کشید کی ضرورت کیوں ہے؟
اس تحریر کے وقت، بند اور اوپن سورس دونوں ماڈلز کو کھربوں پیرامیٹرز پر تربیت دی گئی ہے۔ یہ اندرونی ترتیب کے متغیرات ہیں جو ماڈل خود بخود تربیتی ڈیٹا سے سیکھتا ہے۔ پیرامیٹرز کی یہ بڑی تعداد مناسب فنڈنگ کے بغیر کام کرنا انتہائی مشکل اور مہنگا بنا دیتی ہے۔ ماڈل بڑی مقدار میں توانائی استعمال کرتا ہے اور اسے مہنگے ہارڈ ویئر کی ضرورت ہوتی ہے۔
ڈسٹلیشن ہمیں ان فرنٹیئر ماڈلز سے سیکھنے کو چھوٹے، زیادہ موثر ماڈلز میں تبدیل کرنے کی اجازت دیتا ہے جو استعمال میں آسان اور سستے ہیں۔
ماڈل کشید ٹیکنالوجی
استعمال شدہ کشید تکنیک کا انحصار فراہم کردہ علم پر ہوتا ہے۔ کچھ طریقے صرف حتمی پیشین گوئی بھیجتے ہیں۔ دوسرے داخلی نمائندگی، توجہ کے نقشے، تخمینہ کے مراحل، یا یہاں تک کہ استاد کے ماڈل کے پورے رویے کو منتقل کرتے ہیں۔
یہاں کچھ تکنیکیں ہیں:
رد عمل پر مبنی کشید
یہ استاد سے لے کر طالب علم تک کلاسک کشید ہے جسے جیفری ہنٹن نے اصل میں اپنے مقالے میں ڈسٹلنگ دی نالج ان اے نیورل نیٹ ورک میں متعارف کرایا تھا۔ اس سے پہلے کہ ہم یہ دیکھیں کہ یہ کیسے کام کرتا ہے، ماڈل ٹریننگ کے بارے میں آپ کو کچھ تصورات سمجھنے کی ضرورت ہے۔ یہ سخت لیبل اور نرم لیبل ہیں۔
سخت لیبل مقررہ، واضح اہداف کو سختی سے ہینڈل کرتا ہے۔ اگر آپ ماڈل میں کتے کی تصویر ڈالتے ہیں اور اس سے یہ پیشین گوئی کرنے کو کہتے ہیں کہ آیا یہ کتا، بلی، یا گھوڑا ہے، تو نتائج کتے (1)، گھوڑے (0) اور بلی (0) کو دیکھتے ہوئے یہ پیشین گوئی کرے گا کہ یہ کتا ہے۔ یہ ممکن نہیں ہے کہ اعداد و شمار کے تناسب یا خصوصیات ایک بلی یا گھوڑے کی طرح نظر آئیں گے.
لیکن ہم بھی نرم لیبلامکان کے ساتھ معاملہ کرتا ہے۔ اگر ہم نرم لیبلز کا استعمال کرتے ہوئے اسی تصویر کو ماڈل میں ڈالتے ہیں، تو ہم پیش گوئی کر سکتے ہیں کہ 0.85 امکان ہے کہ تصویر کتے کی ہے، 0.10 امکان ہے کہ یہ بلی ہے، اور 0.5 امکان ہے کہ یہ گھوڑا ہے۔
جواب پر مبنی کشید میں، طالب علم کے ماڈل کو سخت لیبلز کے ساتھ تربیت دینے کے بجائے، یہ ٹیچر ماڈل کے آؤٹ پٹ (سافٹ لیبل) امکانات سے بھی سیکھتا ہے۔ ایک طالب علم یہ سیکھ سکتا ہے کہ ڈرائنگ کتا ہے، لیکن وہ یہ بھی سیکھیں گے کہ ڈرائنگ تھوڑی سی بلی کی طرح دکھائی دیتی ہے اور زیادہ گھوڑے کی طرح نہیں۔
اس اضافی معلومات کو تاریک علم کہا جاتا ہے۔ یہ چھوٹے ماڈلز کو اعلی کارکردگی کو برقرار رکھتے ہوئے بڑے، زیادہ درست اساتذہ کے رویے کی نقل کرنے کی اجازت دیتا ہے۔
رد عمل پر مبنی کشید کے کچھ فوائد یہ ہیں کہ اس پر عمل درآمد آسان ہے، بہت قابل اعتماد، اور تصویر کی درجہ بندی کے ساتھ اچھی طرح کام کرتا ہے۔ تاہم، اس میں کچھ خرابیاں ہیں، سب سے بڑی یہ کہ یہ نیٹ ورک کے اندر جو کچھ ہو رہا ہے اسے نظر انداز کر دیتا ہے۔
یعنی رد عمل پر مبنی کشید صرف آؤٹ پٹ پرت (امکان) کو دیکھتی ہے، اس لیے طالب علم کا استاد کے ماڈل کے ساتھ "بلیک باکس” کا رشتہ ہوتا ہے۔ ہم سیکھتے ہیں کہ استاد کیا فیصلہ کرتا ہے، لیکن ہم یہ نہیں سیکھتے کہ اس نتیجے پر کیسے پہنچا ہے۔ پچھلی مثال کا استعمال کرتے ہوئے، ہم اس بات کے امکانات کو سیکھتے ہیں کہ کتے، بلی، یا گھوڑے کی خصوصیات کیا ہیں، لیکن ہم بنیادی اصول نہیں سیکھتے کہ اس نتیجے پر کیسے پہنچا یا یہ کیسے کام کرتا ہے۔
فنکشن پر مبنی کشید
صرف حتمی آؤٹ پٹ کو منتقل کرنے کے بجائے، یہ تکنیک بڑے ماڈل کی اندرونی خصوصیت کی نمائندگی کو منتقل کرتی ہے۔
اس کے بارے میں سوچنے کا ایک آسان طریقہ یہ ہے کہ آپ یہ تصور کریں کہ آپ ایک عظیم ریاضی کے استاد کے طالب علم ہیں۔ استاد ریاضی کا مسئلہ پیش کرتا ہے اور حتمی نتیجہ دکھاتا ہے۔ آپ بالآخر صحیح فارمولے کا اندازہ لگا سکتے ہیں، لیکن اس میں سے زیادہ تر صرف نتائج کو یاد رکھنے کا طریقہ سیکھ رہا ہے۔
لیکن اگر کوئی استاد آپ سے ان کی نوٹ بک کو دیکھنے اور ان کے کام کو دیکھنے کے لیے کہے، تو آپ استاد کے صحیح سوچنے کے عمل کو سیکھ رہے ہیں۔
فیچر پر مبنی ڈسٹلیشن میں، ٹریننگ کے دوران، طالب علم کے ماڈل کو لازمی طور پر چھپی ہوئی پرت ایکٹیویشنز پیدا کرنا ہوں گی جو مطلب مربع ایرر (MSE) کا استعمال کرتے ہوئے استاد سے مماثل ہوں۔ اوسط مربع غلطی کے لیے، طالب علم کے ماڈل کو نہ صرف حتمی آؤٹ پٹ کا صحیح اندازہ لگانے کے لیے انعام دیا جاتا ہے۔ اگر ان کا اندرونی فنکشنل سسٹم ٹیچر کے ماڈل کے فنکشنل سسٹم سے میل نہیں کھاتا ہے تو ان پر بھی جرمانہ عائد کیا جاتا ہے۔
یہ طریقہ بڑے پیمانے پر convolutional عصبی نیٹ ورکس، وژن ٹرانسفارمرز، آبجیکٹ کا پتہ لگانے وغیرہ میں استعمال ہوتا ہے۔
اس طریقہ کار کا منفی پہلو یہ ہے کہ میموری اور بجلی کی کھپت میں تیزی سے اضافہ ہو سکتا ہے کیونکہ طالب علم کو ہر تربیتی تکرار پر ٹیچر ماڈل کے اندرونی فیچر نقشے کو نکالنا اور ذخیرہ کرنا چاہیے۔ اس سے اسے چلانا بہت مہنگا پڑتا ہے۔
کشید
اس نقطہ نظر میں، طالب علم کے ماڈل کو ہر نیوران کی نقل کرنے کے بجائے، بڑا ماڈل مشاہدہ کرتا ہے کہ اس کی توجہ کہاں مرکوز ہے اور ان نیوران کو کاپی کرتا ہے۔
ٹرانسڈیوسر ماڈل میں، ایک ماڈل جو انفرادی الفاظ پر توجہ دینے کے بجائے جملوں کو سمجھنے کی کوشش کرتا ہے، توجہ کا نقشہ ان پٹ ٹوکنز یا خطوں کی نمائندگی کرتا ہے جنہیں ماڈل پیشین گوئی کرتے وقت سب سے اہم سمجھتا ہے۔ طلباء ان نقشوں یا اساتذہ کے ماڈلز کی تقسیم کو دوبارہ تیار کرنے کی کوشش کرتے ہیں۔ یہ طلباء کو دکھاتا ہے کہ مسئلہ کو حل کرنے کی کوشش کرتے وقت "دیکھنا” کہاں ہے۔
اٹینشن ڈسٹلیشن کا منفی پہلو یہ ہے کہ اس میں ٹریننگ ٹائم اور ہارڈ ویئر کے وسائل دونوں میں نمایاں اوور ہیڈ ہے۔ اس کی وجہ یہ ہے کہ Mean Squared Error (MSE) اور Kullback-Leibler (KL) ڈائیورجن جیسی میٹرکس کا حساب لگانے کی ضرورت ہے۔ یہ میٹرکس نقصان کے فنکشن کے طور پر کام کرتے ہیں جو ماڈل کو بالکل بتاتا ہے کہ اس کی پیشین گوئیاں یا اندرونی نمائندگی اساتذہ کے ماڈل سے کتنی مختلف ہیں۔ بڑے توجہ والے ٹینسر پر اس حساب کو انجام دینے سے وسائل کی کھپت میں نمایاں حصہ ہوتا ہے۔
گھر آسون
ماڈل خود بھی سیکھ سکتا ہے۔ اس میں پچھلے ورژن سے بعد کے ورژن میں علم کی منتقلی شامل ہے۔ اس میں نیٹ ورک کی مختلف پرتوں کے درمیان علم کی منتقلی بھی شامل ہو سکتی ہے۔
اس کا فائدہ یہ ہے کہ ماڈل اپنے سائز میں اضافہ کیے بغیر بہتر ہو سکتا ہے، بڑے ماڈلز کا استعمال کرتے ہوئے طلباء کے ماڈلز کی تربیت کی لاگت کو کم کر سکتا ہے۔
PyTorch میں علم کشید کو کیسے نافذ کیا جائے۔
یہ ظاہر کرنے کے لیے کہ ماڈل ڈسٹلیشن ریئل ٹائم میں کیسے کام کرتی ہے، ہم MNIST ڈیٹاسیٹ اور کلاسیفائر کو PyTorch کے ساتھ استعمال کرتے ہوئے استاد اور طالب علم کے ماڈلز کو تربیت دیں گے۔
ڈیٹاسیٹ میں ہاتھ سے لکھے ہوئے ہندسوں کی تقریباً 70,000 گرے اسکیل تصاویر ہیں۔ استاد کو تربیت دیں اور پھر اسے منجمد کریں جب آپ اساتذہ کے سخت لیبلز اور نرم اہداف کا استعمال کرتے ہوئے طلباء کو تربیت دیتے ہیں۔
MNIST ڈیٹاسیٹ نسبتاً چھوٹا ڈیٹاسیٹ ہے، اس لیے ڈسٹلیشن کے فوائد اہم نہیں ہو سکتے۔ تاہم، یہ پروجیکٹ ڈسٹلیشن ورک فلو کو ظاہر کرتا ہے اور بڑے ڈیٹا سیٹس کو چلانے کے لیے ایک اچھا پس منظر فراہم کرے گا۔
اس پروجیکٹ کو چلانے کے لیے آپ کو مندرجہ ذیل ازگر پیکجز کی ضرورت ہے۔
| پیکج | مقصد |
|---|---|
torch |
نیورل نیٹ ورکس کی تعمیر اور تربیت کے لیے ایک بنیادی گہری سیکھنے کا فریم ورک۔ |
torchvision |
ڈیٹا سیٹس فراہم کرتا ہے جیسے MNIST اور تصویری افادیت۔ |
numpy |
عددی حساب اور صف کے آپریشن۔ |
matplotlib |
گراف بنائیں اور بصری تصاویر/نتائج کو دیکھیں۔ |
tqdm |
تربیت کے دوران ایک پروگریس بار دکھاتا ہے۔ |
ہم اس پروجیکٹ کے لیے بصری اسٹوڈیو کوڈ ایڈیٹر استعمال کریں گے، لیکن آپ اپنی پسند کا کوئی دوسرا کوڈ ایڈیٹر استعمال کرسکتے ہیں۔
یہ ہمارا پروجیکٹ ڈھانچہ ہے۔ میں اپنے پروجیکٹ کے کوڈ کے ساتھ نیچے فولڈرز اور فائلوں کی وضاحت کروں گا۔
knowledge-distillation/
│
├── data/
│
├── models.py
│
├── engine.py
│
├── losses.py
│
├── train_teacher.py
│
├── train_student.py
│
├── train_distilled_student.py
│
├── evaluate.py
│
├── visualize.py
│
├── utils.py
│
├── plots.py
│
├── requirements.txt
│
└── README.md
فولڈر کی ساخت میں پہلی چیز ہے data فولڈر یہ MNIST ڈیٹاسیٹ پر مشتمل ہے۔
ہمارے models.py فائل پروجیکٹ میں استعمال ہونے والے تمام نیورل نیٹ ورکس کے فن تعمیر کی وضاحت کرتی ہے۔ ان میں ٹیچر نیٹ ورک کلاسز اور اسٹوڈنٹ نیٹ ورک کلاسز شامل ہیں۔ ہر کلاس درجہ بندی، آگے بڑھنے، اور نیٹ ورک کے ذریعے ڈیٹا کے بہاؤ کی وضاحت کرتا ہے۔
import torch
import torch.nn as nn
import torch.nn.functional as F

class TeacherNet(nn.Module):

    def __init__(self):
        super().__init__()

        self.flatten = nn.Flatten()

        self.fc1 = nn.Linear(28 * 28, 1024)
        self.fc2 = nn.Linear(1024, 512)
        self.fc3 = nn.Linear(512, 256)
        self.fc4 = nn.Linear(256, 128)
        self.fc5 = nn.Linear(128, 10)

    def forward(self, x):

        x = self.flatten(x)

        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = F.relu(self.fc3(x))
        x = F.relu(self.fc4(x))

        logits = self.fc5(x)

        return logits


class StudentNet(nn.Module):
    """
    Smaller neural network (Student)
    """

    def __init__(self):
        super().__init__()

        self.flatten = nn.Flatten()

        self.fc1 = nn.Linear(28 * 28, 128)
        self.fc2 = nn.Linear(128, 10)

    def forward(self, x):

        x = self.flatten(x)

        x = F.relu(self.fc1(x))

        logits = self.fc2(x)

        return logits
کہ utils.py ایک فائل ڈیٹا سیٹ تیار کرتی ہے اور اس سوال کا جواب دیتی ہے، "ڈیٹا سیٹ کہاں سے آتا ہے؟” یہاں ہم MNIST ڈیٹاسیٹ ڈاؤن لوڈ کرتے ہیں، تصاویر کو معمول پر لاتے ہیں، اور ٹریننگ اور ٹیسٹ لوڈرز بناتے ہیں۔
from torchvision import datasets, transforms
from torch.utils.data import DataLoader


def get_dataloaders(batch_size=64):
    """
    Downloads MNIST (if needed) and returns
    training and testing DataLoaders.
    """

    transform = transforms.ToTensor()

    train_dataset = datasets.MNIST(
        root="data",
        train=True,
        download=True,
        transform=transform
    )

    test_dataset = datasets.MNIST(
        root="data",
        train=False,
        download=True,
        transform=transform
    )

    train_loader = DataLoader(
        train_dataset,
        batch_size=batch_size,
        shuffle=True
    )

    test_loader = DataLoader(
        test_dataset,
        batch_size=batch_size,
        shuffle=False
    )

    return train_loader, test_loader
کہ engine.py فائلوں میں دوبارہ قابل استعمال سیکھنے کے الگورتھم ہوتے ہیں اور تربیت کی ترقی کے طریقہ کار کی رہنمائی میں مدد کرتے ہیں۔ model.py کوڈ حاصل کریں اور اسے تربیت دیں۔
import torch
from tqdm import tqdm


def train_one_epoch(
    model,
    dataloader,
    criterion,
    optimizer,
    device,
):
    model.train()

    running_loss = 0

    progress = tqdm(dataloader)

    for images, labels in progress:

        images = images.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()

        outputs = model(images)

        loss = criterion(outputs, labels)

        loss.backward()

        optimizer.step()

        running_loss += loss.item()

        progress.set_description(
            f"Loss {loss.item():.4f}"
        )

    return running_loss / len(dataloader)


def evaluate(model, dataloader, device):

    model.eval()

    correct = 0
    total = 0

    with torch.no_grad():

        for images, labels in dataloader:

            images = images.to(device)
            labels = labels.to(device)

            outputs = model(images)

            _, predicted = torch.max(outputs, dim=1)

            total += labels.size(0)

            correct += (predicted == labels).sum().item()

    accuracy = 100 * correct / total

    return accuracy


def predict(model, images, device):

    model.eval()

    with torch.no_grad():

        images = images.to(device)

        outputs = model(images)

        _, predictions = torch.max(outputs, dim=1)

    return predictions

def train_distillation_epoch(
    teacher,
    student,
    dataloader,
    optimizer,
    device,
    loss_fn,
    temperature=4.0,
    alpha=0.5,
):
    """
    Train the student using a frozen teacher.
    """

    teacher.eval()
    student.train()

    running_loss = 0

    progress = tqdm(dataloader)

    for images, labels in progress:

        images = images.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()

        # Teacher predictions (NO gradients)
        with torch.no_grad():
            teacher_logits = teacher(images)

        # Student predictions
        student_logits = student(images)

        # Combined loss
        loss = loss_fn(
            student_logits=student_logits,
            teacher_logits=teacher_logits,
            labels=labels,
            temperature=temperature,
            alpha=alpha,
        )

        loss.backward()

        optimizer.step()

        running_loss += loss.item()

        progress.set_description(
            f"Distill Loss {loss.item():.4f}"
        )

    return running_loss / len(dataloader)
کہ losses.py فائل اس بات کی وضاحت کرتی ہے کہ ماڈل حقیقی نمبروں کی پیمائش کیسے کرتا ہے۔ عصبی نیٹ ورک نقصان کو کم سے کم کرکے سیکھتے ہیں اور اس وجہ سے بیس لائن ویژولائزیشن کے لیے استعمال ہوتے ہیں۔ CrossEntropyLossاور علم کشید کے لیے ہم distillation_loss().
اس فائل کے اندر، ہم نے کراس اینٹروپی اور k1 ڈائیورجینس کا استعمال کرتے ہوئے سخت لیبلز اور نرم اہداف کو ملایا۔ یہ وہ جگہ ہے جہاں جیفری ہنٹن کا الگورتھم کام میں آتا ہے۔
import torch
import torch.nn as nn
import torch.nn.functional as F

cross_entropy = nn.CrossEntropyLoss()


def distillation_loss(
    student_logits,
    teacher_logits,
    labels,
    temperature=4.0,
    alpha=0.5,
):
    """
    Geoffrey Hinton's Knowledge Distillation Loss

    Parameters
    ----------
    student_logits : output from student model
    teacher_logits : output from teacher model
    labels         : ground-truth labels
    temperature    : controls softness of probability distribution
    alpha          : weight between hard and soft losses
    """

    # Hard Label Loss
    hard_loss = cross_entropy(student_logits, labels)

    # Teacher Soft Targets
    teacher_probs = F.softmax(
        teacher_logits / temperature,
        dim=1
    )

    # Student Soft Predictions
    student_log_probs = F.log_softmax(
        student_logits / temperature,
        dim=1
    )

    # KL Divergence
    soft_loss = F.kl_div(
        student_log_probs,
        teacher_probs,
        reduction="batchmean"
    )

    # Final Distillation Loss
    loss = (
        alpha * hard_loss
        +
        (1 - alpha)
        * (temperature ** 2)
        * soft_loss
    )

    return loss
کہ train_teacher.py فائل اساتذہ کے نیٹ ورک کو تربیت دینا ہے۔ ہم اس پہلے نفاذ کے بعد اساتذہ کو دوبارہ تربیت نہیں دیں گے۔
import torch
import torch.optim as optim

from models import TeacherNet
from utils import get_dataloaders
from engine import train_one_epoch, evaluate
from losses import cross_entropy

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

train_loader, test_loader = get_dataloaders()

teacher = TeacherNet().to(device)

optimizer = optim.Adam(
    teacher.parameters(),
    lr=0.001,
)

epochs = 10

for epoch in range(epochs):

    loss = train_one_epoch(
        teacher,
        train_loader,
        cross_entropy,
        optimizer,
        device,
    )

    accuracy = evaluate(
        teacher,
        test_loader,
        device,
    )

    print(
        f"Epoch {epoch+1}/{epochs}"
        f" | Loss: {loss:.4f}"
        f" | Accuracy: {accuracy:.2f}%"
    )

torch.save(
    teacher.state_dict(),
    "teacher.pth",
)

print("nTeacher saved successfully.")
کہ train_student.py فائل وہ جگہ ہے جہاں ہم اپنے طلباء کو تربیت دیتے ہیں۔ ٹرین_ٹیچر کی طرح، سوائے اس کے کہ نیٹ ورک چھوٹا ہے اور اساتذہ کی رہنمائی یہاں نافذ نہیں کی گئی ہے۔ یہ ایک بنیادی درستگی فراہم کرتا ہے کہ طالب علم استاد کے بغیر کیسے کارکردگی کا مظاہرہ کرے گا۔
import torch
import torch.optim as optim

from models import StudentNet
from utils import get_dataloaders
from engine import train_one_epoch, evaluate
from losses import cross_entropy

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

train_loader, test_loader = get_dataloaders()

student = StudentNet().to(device)

optimizer = optim.Adam(
    student.parameters(),
    lr=0.001,
)

epochs = 10

for epoch in range(epochs):

    loss = train_one_epoch(
        student,
        train_loader,
        cross_entropy,
        optimizer,
        device,
    )

    accuracy = evaluate(
        student,
        test_loader,
        device,
    )

    print(
        f"Epoch {epoch+1}/{epochs}"
        f" | Loss: {loss:.4f}"
        f" | Accuracy: {accuracy:.2f}%"
    )

torch.save(
    student.state_dict(),
    "student_baseline.pth",
)

print("nBaseline student saved.")
کہ train_distilled_student.py یہ کوڈ کا بنیادی حصہ ہے۔ یہ فائل طلباء کو پڑھانے کے لیے لیبلز اور استاد کے علم دونوں کا استعمال کرتی ہے۔ یہاں ہم ردعمل پر مبنی علم کشید کو نافذ کرتے ہیں۔
import torch
import torch.optim as optim

from models import TeacherNet, StudentNet
from utils import get_dataloaders
from engine import (
    train_distillation_epoch,
    evaluate,
)
from losses import distillation_loss

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

train_loader, test_loader = get_dataloaders()

# Load Teacher
teacher = TeacherNet().to(device)
teacher.load_state_dict(
    torch.load(
        "teacher.pth",
        map_location=device,
    )
)

teacher.eval()

# Student
student = StudentNet().to(device)

optimizer = optim.Adam(
    student.parameters(),
    lr=0.001,
)

epochs = 10

for epoch in range(epochs):

    loss = train_distillation_epoch(
        teacher,
        student,
        train_loader,
        optimizer,
        device,
        distillation_loss,
        temperature=3,
        alpha=0.7,
    )

    accuracy = evaluate(
        student,
        test_loader,
        device,
    )

    print(
        f"Epoch {epoch+1}/{epochs}"
        f" | Loss: {loss:.4f}"
        f" | Accuracy: {accuracy:.2f}%"
    )

torch.save(
    student.state_dict(),
    "student_distilled.pth",
)

print("nDistilled student saved.")
کہ evaluate.py پیمائش کرتا ہے کہ تربیت یافتہ ماڈل کتنی اچھی کارکردگی کا مظاہرہ کرتا ہے۔ یہاں ہم صرف ماڈل لوڈ کرتے ہیں، ٹیسٹ ڈیٹا لوڈ کرتے ہیں، پیشین گوئیاں کرتے ہیں، اور درستگی کا حساب لگاتے ہیں۔
import torch

from models import TeacherNet
from utils import get_dataloaders
from engine import evaluate

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

_, test_loader = get_dataloaders()

teacher = TeacherNet().to(device)

teacher.load_state_dict(
    torch.load(
        "teacher.pth",
        map_location=device,
    )
)

accuracy = evaluate(
    teacher,
    test_loader,
    device,
)

print(
    f"Teacher Accuracy: {accuracy:.2f}%"
)
کہ visualize.py فائلیں ہمارے نتائج کی بصری نمائندگی ہیں۔ ہم ٹیچر، بیس اسٹوڈنٹ، اور ڈسٹلیشن اسٹوڈنٹ کے نتائج کو دیکھنے کے لیے Python پیکج matplotlib کا استعمال کرتے ہیں۔
import matplotlib.pyplot as plt

models = [
    "Teacher",
    "BaselinenStudent",
    "DistillednStudent"
]

accuracy = [98.20, 97.86, 97.91]

plt.figure(figsize=(7,5))
plt.bar(models, accuracy)

plt.title("Knowledge Distillation Performance Comparison")
plt.ylabel("Accuracy (%)")

for i, v in enumerate(accuracy):
    plt.text(i, v + 0.02, f"{v:.2f}%", ha="center")

plt.ylim(97.5, 98.5)

plt.tight_layout()
plt.savefig("accuracy_comparison.png", dpi=300)
plt.show()
ذیل میں آپ پروگرام کا مکمل ورک فلو دیکھ سکتے ہیں تاکہ آپ سمجھ سکیں کہ یہ سب کیسے اکٹھا ہوتا ہے۔
                       utils.py
                          │
                 Load MNIST Dataset
                          │
                          ▼
                     models.py
             TeacherNet / StudentNet
                          │
                          ▼
                     losses.py
  Cross Entropy + Distillation Loss Function
                          │
                          ▼
                     engine.py
    Generic Training and Evaluation Functions
             ┌────────────┼────────────┐
             │            │            │
             ▼            ▼            ▼
  train_teacher.py  train_student.py  distilled_student.py
             │            │            │
             ▼            ▼            ▼
   teacher.pth  student_baseline.pth  distilled.pth
                          │
                          ▼
                     evaluate.py
              Compute Final Accuracy
                          │
                          ▼
                    visualize.py
     Generate Charts and Experimental Figures
اپنے نتائج کا اندازہ کیسے لگائیں۔
اب آئیے چیک کریں اور نتائج کا اندازہ کریں۔ یہ ہر نیٹ ورک کے لیے 10 دور چلانے کا اسکرین شاٹ ہے: استاد، طالب علم، اور ڈسٹلڈ اسٹوڈنٹ نیٹ ورک۔
ٹیچر نیٹ ورک: 10 مکمل چکروں کے بعد، ہم نے 98.20% کی درستگی حاصل کی۔
طلباء کا نیٹ ورک: 10 مکمل چکروں کے بعد 97.74% درستگی حاصل کی۔ ٹیچر ماڈل کے بغیر چھوٹے نیٹ ورکس کے لیے یہ کافی اچھی کارکردگی ہے۔
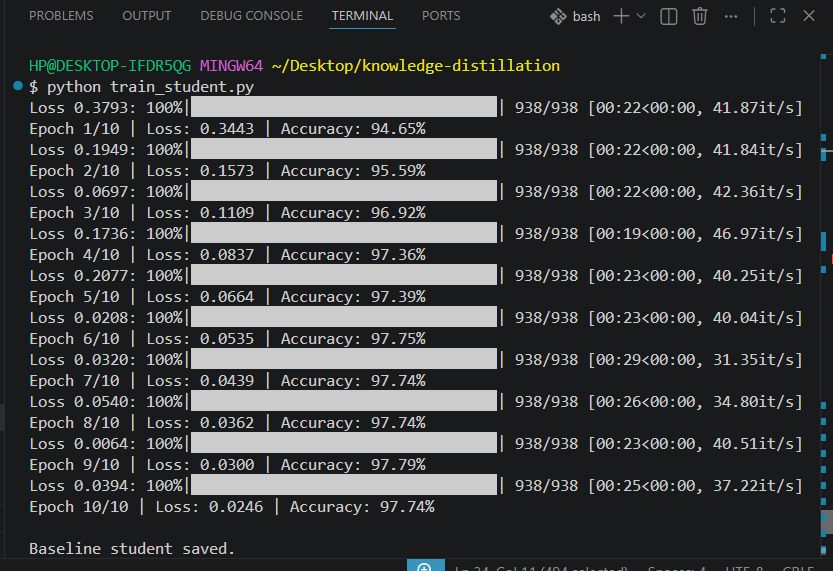
ڈسٹلڈ اسٹوڈنٹ نیٹ ورک: 10 مکمل چکروں کے بعد 98.20% درستگی حاصل کی۔ ماڈل کے بارے میں استاد کے علم کے بغیر 97.74% کی بہتری حاصل کی گئی۔

نیچے دیئے گئے چارٹ کو دیکھیں کہ ہر ماڈل کی کارکردگی کیسے دکھائی دیتی ہے۔

ماڈل کے سائز کو کم کرنے کے مختلف طریقے
اب ہم نے دیکھا ہے کہ اصلی کوڈ کی مثال کے ساتھ کیا ماڈل نکالنا ہے۔ آئیے دیکھتے ہیں کہ ڈیولپرز لیٹینسی، میموری اسپیس، اور کمپیوٹ کی لاگت کو بچانے کے لیے بڑے لینگویج ماڈلز کے سائز کو کم کرنے کے لیے مختلف طریقے اختیار کر رہے ہیں، اور وہ ڈسٹلیشن سے کیسے مختلف ہیں۔
اس کے لیے تین اہم طریقے ہیں:
کوانٹائزیشن
کوانٹائزیشن نیورل نیٹ ورک کے عددی وزن اور ایکٹیویشن کو ذخیرہ کرنے کے لیے استعمال ہونے والے بنیادی ڈیٹا کی قسموں کی بٹ چوڑائی کو سختی سے کم کر کے کارکردگی کو حاصل کرتی ہے۔ یہ ماڈل فن تعمیر کے بجائے میموری بینڈوڈتھ کی رکاوٹ کو نشانہ بناتا ہے۔
سیدھے الفاظ میں، کوانٹائزیشن ایک 32 بٹ نمبر کو 8 بٹ نمبر میں تبدیل کرتی ہے، جو فائل کے سائز کا تقریباً 75 فیصد بچا سکتی ہے۔
کوانٹائزیشن ڈسٹلیشن سے کس طرح مختلف ہوتی ہے اس کی ایک حقیقی زندگی کی مثال نصابی کتابوں کو چھاپنے کے دوران انک اور کاغذ جیسے وسائل کو بچانے کی کوشش ہے۔ ڈسٹلیشن ایک نصابی کتاب کا خلاصہ کرتی ہے، جبکہ کوانٹائزیشن درست مواد پرنٹ کرتی ہے لیکن سیاہی اور کاغذ کو بچانے کے لیے کم ریزولوشن فونٹس استعمال کرتی ہے۔
کٹائی
کٹائی اس اصول پر کام کرتی ہے کہ بڑے زبان کے ماڈلز میں نیٹ ورک میں اکثر بے کار اور کم اثر والے پیرامیٹرز ہوتے ہیں۔ کمزور لنکس کو ہٹانا ماڈل کو چھوٹا اور تیز تر بنا سکتا ہے۔
نصابی کتاب کی تشبیہ استعمال کرنے کے لیے، کٹائی کا عمل نصابی کتاب سے گزرنا اور ایسے صفحات یا ابواب کو پھاڑنا ہے جو آپ کے خیال میں غیر ضروری ہیں۔
کم درجہ فیکٹرائزیشن
یہ ایک ریاضیاتی عمل ہے جو میٹرکس ضرب کو آسان بنانے کے لیے لکیری الجبرا کا استعمال کرتا ہے جو گہری سیکھنے کے فن تعمیر پر حاوی ہے۔
نصابی کتاب سے ایک مثال استعمال کرتے ہوئے، اس عمل میں پیچیدہ جملوں کو آسان، چھوٹے فارمولوں میں دوبارہ لکھنا شامل ہے جن کا ایک ہی مطلب ہے۔
کون سا طریقہ استعمال کرنا ہے اس کا انحصار اس رکاوٹ پر ہوگا جسے آپ حل کرنے کی کوشش کر رہے ہیں۔ کوانٹائزیشن عام طور پر یادداشت کے مسائل کے لیے اچھی طرح کام کرتی ہے، جبکہ کٹائی اور کشید کو حساب کے وقت کو کم کرنے کے لیے ڈیزائن کیا گیا ہے۔
نتیجہ
علم کی منتقلی مصنوعی ذہانت کے لیے اتنی ہی ضروری ہے جتنی انسانی تاریخ کے لیے رہی ہے۔ بالکل اسی طرح جیسے ارسطو نے افلاطون کی تعلیمات پر استوار کیا تھا، آج کے موثر اور قابل استعمال عصبی نیٹ ورک بڑے پیمانے پر، کمپیوٹ-انٹینسی ٹیچر ماڈلز سے حاصل کردہ بنیادی "تاریک علم” پر انحصار کرتے ہیں۔
ٹریلین پیرامیٹر فرنٹیئر ماڈلز کی تربیت کے لیے بہت زیادہ ہارڈ ویئر اور مالی وسائل کی ضرورت ہوتی ہے، لیکن علم کشید اس بات کو یقینی بناتا ہے کہ ان پیشرفتوں کے عملی فوائد کو بڑے کمپیوٹیشنل رکاوٹوں سے روکا نہ جائے۔
جیسا کہ PyTorch MNIST تجربے میں دکھایا گیا ہے، یہاں تک کہ سادہ ردعمل پر مبنی کشید بھی بڑے اساتذہ کے نرم امکانات سے سیکھ کر وزن والے طبقے سے چھوٹے نیٹ ورکس کو فائدہ پہنچا سکتی ہے۔
جب کوانٹائزیشن اور کٹائی جیسی دیگر اصلاحی تکنیکوں کے ساتھ ملایا جاتا ہے، تو ڈسٹلیشن ایج ڈیوائسز، موبائل فونز، اور کنزیومر گریڈ ہارڈ ویئر پر اعلیٰ کارکردگی والے AI کو تعینات کرنے کے لیے ایک واضح راستہ فراہم کرتا ہے۔
پڑھنے کے لیے شکریہ! میرا یوٹیوب چینل دیکھیں جہاں میں AI سے متعلق مواد کے بارے میں ویڈیوز پوسٹ کرتا ہوں۔
حوالہ جات:
-
مشین لرننگ ماڈل یا ایل ایل ایم نکالنے کا کیا مطلب ہے؟
-
AI بصیرت: سائنس، انوویشن اور ٹیکنالوجی ڈیپارٹمنٹ کے لیے ماڈل ایکسٹریکشن
-
ایل ایل ایم کے لیے ماڈل نکالنا: چھوٹے، تیز AI کے لیے ایک عملی گائیڈ
-
نیورل نیٹ ورکس سے علم نکالنا از جیفری ہنٹن
-
ہر وہ چیز جو آپ کو علم کشید کے بارے میں جاننے کی ضرورت ہے۔