
علاج کی پیشرفت کا نوٹ اس بات کا ریکارڈ ہے کہ تھراپی سیشن کے دوران کیا ہوتا ہے۔ اس میں کلائنٹ نے کیا کہا، تھراپسٹ نے کیا مشاہدہ کیا، زیر بحث موضوعات، اور اگلے سیشن کے منصوبے شامل ہو سکتے ہیں۔ وقت گزرنے کے ساتھ، یہ نوٹ بڑی مقدار میں متن کا اضافہ کر سکتے ہیں۔
ایک نوٹ پڑھنے سے آپ کو سیشن کو سمجھنے میں مدد ملتی ہے۔ لیکن اگر آپ ایک سے زیادہ نوٹ دیکھنا چاہتے ہیں تو کیا ہوگا؟ کیا آپ یہ دیکھنے کے لیے ٹیکسٹ اینالیٹکس استعمال کر سکتے ہیں کہ زبان ایک سیشن سے دوسرے سیشن میں کیسے بدلتی ہے؟
نیچرل لینگویج پروسیسنگ (NLP) انسانی زبان کو پروسیس کرنے کے لیے کمپیوٹر استعمال کرنے کا ایک طریقہ ہے۔ Python آپ کو متن کو جملوں میں تقسیم کرنے، زبان کی خصوصیات کو منتخب کرنے اور جذبات اور جذبات کی درجہ بندی کرنے کے لیے ماڈل استعمال کرنے دیتا ہے۔ اس ٹیوٹوریل میں، ہم spaCy کی لینگویج پروسیسنگ پائپ لائن اور ٹیکسٹ پروسیسنگ کے لیے Hugging Face Transformers کا استعمال کرتے ہوئے پہلے سے تربیت یافتہ درجہ بندی کا ماڈل چلاتے ہیں۔
آپ فرضی تھراپی نوٹ کا استعمال کرتے ہوئے ایک چھوٹی NLP پائپ لائن بنائیں گے۔ ہم متن پر کارروائی کرنے کے لیے spaCy کا استعمال کرتے ہیں، جذبات اور جذبات کی درجہ بندی کرنے کے لیے دو آف دی شیلف Hugging Face ماڈل استعمال کرتے ہیں، سیشن کے لحاظ سے نتائج کو ترتیب دینے کے لیے پانڈوں کا استعمال کرتے ہیں، اور چارٹ بنانے کے لیے Matplotlib کا استعمال کرتے ہیں۔
آپ ہمارے GitHub ذخیرہ میں مکمل پروجیکٹ کوڈ تلاش کر سکتے ہیں۔
ہم اس بات کا تعین کرنے کی کوشش نہیں کر رہے ہیں کہ علاج کارآمد ہے یا نہیں۔ مقصد یہ سیکھنا ہے کہ تحریری متن کی جانچ کیسے کی جائے، سوالات پوچھیں، اور اسے ڈیٹا میں تبدیل کریں جسے چارٹ میں دکھایا جا سکتا ہے۔
آخر میں، آپ کے پاس spaCy، Hugging Face Transformers، pandas، اور Matplotlib کا استعمال کرتے ہوئے افسانوی تھراپی نوٹوں میں اثر، جذبات، اور زبان کے نمونوں کو دریافت کرنے کے لیے ایک عملی Python پروجیکٹ ہوگا۔
میمو: یہ ٹیوٹوریل صرف سیکھنے کے مقاصد کے لیے ہے اور فرضی متن کا استعمال کرتا ہے۔ طبی استعمال کے لیے ماڈل کا تجربہ نہیں کیا گیا ہے۔ وہ آپ کو یہ نہیں بتا سکتے کہ آیا علاج کام کر رہا ہے، معالج اور کلائنٹ کے تعلقات میں مسائل کی نشاندہی کریں، یا تربیت یافتہ پیشہ ور افراد کو تبدیل کریں۔
انڈیکس
NLP ہمیں کیا بتا سکتا ہے اور کیا نہیں بتا سکتا
قدرتی زبان کی پروسیسنگ (NLP) مصنوعی ذہانت کا ایک حصہ ہے جو کمپیوٹر کو انسانی زبان کے ساتھ کام کرنے میں مدد کرتا ہے۔ عام NLP کاموں میں متن کو الفاظ اور جملوں میں تقسیم کرنا، گرامر کی شناخت کرنا، ناموں اور مقامات کو تلاش کرنا، اور احساسات اور جذبات کی درجہ بندی کرنا شامل ہے۔
ہر کام ایک مختلف کام انجام دیتا ہے۔ ٹوکنائزیشن متن کو چھوٹے چھوٹے ٹکڑوں میں توڑ دیتی ہے، جیسے کہ الفاظ۔ پارٹ آف سپیچ ٹیگنگ اس بات کی نشاندہی کرتی ہے کہ جملے میں کوئی لفظ کیسے استعمال ہوتا ہے، جیسے کہ اسم یا فعل۔ لیمیٹائزیشن الفاظ کو قدیم لوگوں کے لیے نقشہ بناتی ہے، جبکہ نام کی ہستی کی شناخت لوگوں، تنظیموں اور مقامات جیسی اشیاء کی شناخت کرتی ہے۔ یہ اس جزو کی ایک مثال ہے جسے spaCy کی پروسیسنگ پائپ لائن میں استعمال کیا جا سکتا ہے۔ جذباتی تجزیہ ماڈل کی سیکھی ہوئی مثالوں کی بنیاد پر اندازہ لگاتا ہے کہ متن مثبت ہے یا منفی۔ جذبات کی درجہ بندی ان جذبات کے زمروں کے لیے ایک اسکور فراہم کرتی ہے جو ماڈل نے تربیت کے دوران سیکھے۔
یہ نتائج ہمیں یہ نہیں بتاتے کہ شخص واقعی کیا محسوس کر رہا ہے۔ تھراپی کے نوٹس میں معالج کے مشاہدات، کلائنٹ کے درست الفاظ، اور مؤکل کے کہنے کا تھراپسٹ کا خلاصہ شامل ہو سکتا ہے۔ ماڈل کو سمجھ نہیں آ رہی ہے کہ کس نے کیا کہا یا پوری صورتحال۔ اس ٹیوٹوریل میں، ہم ماڈل پیشین گوئیوں اور زبان کے نمونوں کے بارے میں بات کریں گے، نہ کہ انسانی جذبات یا علاج کی پیش رفت کے بارے میں۔
ہم کیا بنا رہے ہیں
ہمارا پروجیکٹ ورچوئل سیشن نوٹس کے ایک چھوٹے سے ذخیرے کا تجزیہ کرتا ہے اور چار قسم کے نتائج پیش کرتا ہے:
- ہر جملے کے لیے جذبات کی پیشن گوئی
- اوسط سکور کے ساتھ ہر جملے کے لیے جذبات کی پیشین گوئی
- زبان کی سادہ خصوصیات، جیسے منتخب کردہ ضمیروں کی تعداد اور جملے جیسے "شاید” یا "میرے خیال میں”
- سیشنوں کے درمیان نتائج کا موازنہ کرنے کے لیے ٹائم لائن اور ڈیش بورڈ
ورک فلو مندرجہ ذیل ہے:
شکل 1. NLP ورک فلو کا اعلیٰ سطحی منظر۔ خاکہ ممکنہ توسیعات بھی دکھاتا ہے، جیسے CSV اور HTML رپورٹس، جو اس ٹیوٹوریل کے کسی بھی مرحلے میں لاگو نہیں ہوتے ہیں۔
میں کوڈ کو الگ فائلوں میں رکھوں گا تاکہ ہر حصے میں ایک واضح کام ہو۔ یہ پروجیکٹ رشتہ ٹوٹنے کے اسکور یا طبی نتائج کا لیبل نہیں لگاتا ہے۔
ازگر
Python منصوبے کے ہر حصے کو جوڑتا ہے۔ ڈیٹا اور زبانوں کے ساتھ کام کرنے کے لیے بہت سی لائبریریاں بھی ہیں۔
spaCy ایک Python لائبریری ہے جو ٹیکسٹ پروسیسنگ میں مدد کرتی ہے۔ پروسیسنگ پائپ لائن متن کو ٹوکنز میں تقسیم کر سکتی ہے، پارٹ آف سپیچ ٹیگز تفویض کر سکتی ہے، الفاظ کی بنیادی شکلیں تلاش کر سکتی ہے، اور ممکنہ ناموں یا جگہوں کی شناخت کر سکتی ہے۔ ہم چھوٹے انگریزی ماڈل en_core_web_sm استعمال کریں گے۔ یہ ماڈل خاص طور پر علاج کے نوٹوں پر لاگو نہیں ہوتا ہے، لیکن عام طور پر انگریزی پر ہوتا ہے۔
گلے لگانا چہرہ ٹرانسفارمر
ہم دو پہلے سے تربیت یافتہ درجہ بندی کے ماڈل استعمال کریں گے۔
پہلا ماڈل، distilbert/distilbert-base-uncased-finetuned-sst-2-انگریزی، متن کو مثبت یا منفی کے طور پر درجہ بندی کرتا ہے۔ ماڈل کارڈ اس کی شناخت اسٹینفورڈ سینٹیمنٹ ٹری بینک (SST-2) سے ٹھیک ٹیونڈ DistilBERT چیک پوائنٹس سے کرتا ہے، جو سادہ انگریزی جملوں کا ڈیٹا سیٹ ہے۔ DistilBERT خود تحقیقی مقالے میں بیان کیا گیا ہے "DistilBERT، BERT کا ڈسٹل ورژن: چھوٹا، تیز، سستا اور ہلکا۔” نہ ہی چیک پوائنٹ اور نہ ہی اصل DistilBERT کاغذ نے یہ ظاہر کیا کہ یہ ماڈل علاج کے نوٹ کے لیے موزوں ہے۔
دوسرا ماڈل، j-hartmann/emotion-english-distilroberta-base، سات قسموں کی پیشین گوئی کرتا ہے: غصہ، نفرت، خوف، خوشی، غیر جانبدار، اداسی، اور حیرت۔ Jochen Hartmann کے ماڈل کارڈ کے مطابق، اسے چھ ڈیٹا سیٹس سے تیار کردہ متوازن مجموعے پر تربیت دی گئی تھی، بشمول سوشل میڈیا پوسٹس، طالب علم کی خود رپورٹس، اور گفتگو۔ علاج کی پیش رفت کے ریکارڈ کے تجزیہ کے لیے اس کی توثیق نہیں کی گئی ہے۔
یہ ماڈل ہمیں یہ جاننے میں مدد کرتے ہیں کہ متن کی درجہ بندی کیسے کام کرتی ہے۔ تاہم، کیونکہ وہ عام متن پر تربیت یافتہ ہیں، ہم یہ نہیں سمجھ سکتے کہ وہ تھراپی نوٹ پر اچھی طرح کام کریں گے۔
پانڈا اور میٹپلوٹلیب
پانڈاس نتائج کو ڈیٹا فریم نامی ٹیبل میں ترتیب دینے میں ہماری مدد کرتا ہے۔ Matplotlib آپ کو اپنے نتائج کو چارٹ میں تبدیل کرنے میں مدد کرتا ہے۔
پائی ٹیسٹ
pytest یہ چیک کرنے کا ایک ٹول ہے کہ آیا آپ کا کوڈ توقع کے مطابق کام کرتا ہے۔ کچھ ٹیسٹ نمونہ ماڈل کے نتائج کا استعمال کرتے ہیں، آپ کو بڑی ماڈل فائلوں کو ڈاؤن لوڈ کیے بغیر اپنے کوڈ کی جانچ کرنے کی اجازت دیتا ہے۔
ازگر پروجیکٹ کی ترتیبات
اپنے پروجیکٹ کے لیے فولڈر بنانے کے بعد، اس فولڈر پر جائیں۔
mkdir therapy_notes_nlp
cd therapy_notes_nlp
mkdir data src tests images
آپ کے پروجیکٹ فولڈرز اور فائلوں کو اس طرح نظر آنا چاہئے:
therapy_notes_nlp/
├── data/
│   └── synthetic_notes.json
├── images/
├── src/
│   ├── __init__.py
│   ├── preprocessor.py
│   ├── sentiment.py
│   ├── emotions.py
│   ├── tracker.py
│   └── visualizer.py
├── tests/
│   ├── conftest.py
│   ├── test_analyzer.py
│   ├── test_emotions.py
│   ├── test_preprocessor.py
│   ├── test_sentiment.py
│   └── test_tracker.py
├── analyzer.py
├── main.py
├── pytest.ini
└── requirements.txt
اپنا ورچوئل ماحول بنائیں اور فعال کریں۔ ورچوئل ماحول اس پروجیکٹ کے Python پیکجوں کو دوسرے پروجیکٹس کے استعمال کردہ پیکجوں سے الگ رکھتا ہے۔
python -m venv .venv

# Windows
.venvScriptsactivate

# macOS or Linux
source .venv/bin/activate
درج ذیل پیکیجز شامل کریں: requirements.txt:
spacy>=3.8,<4.0
transformers>=4.45,<6.0
torch>=2.2
pandas>=2.2,<3.0
matplotlib>=3.8,<4.0
pytest>=8.0,<10.0
پیکیج انسٹال کریں اور spaCy کا انگریزی ماڈل ڈاؤن لوڈ کریں:
pip install -r requirements.txt
python -m spacy download en_core_web_sm
جب آپ پہلی بار اپنا پروجیکٹ چلاتے ہیں، تو Hugging Face ماڈل فائلوں کو ڈاؤن لوڈ کرے گا۔ آپ اپنے ماڈل کو CPU پر چلا سکتے ہیں، لیکن اسے GPU پر چلانے سے زیادہ وقت لگ سکتا ہے۔
مصنوعی ڈیٹاسیٹ بنائیں
علاج کے نوٹس میں ذاتی معلومات شامل ہو سکتی ہیں۔ لوگوں کی رازداری کے تحفظ کے لیے، ہم اس ٹیوٹوریل میں فرضی مثالیں استعمال کریں گے۔ اس کا مطلب یہ بھی ہے کہ کوئی بھی مریض کے حقیقی ریکارڈ تک رسائی کی ضرورت کے بغیر اس منصوبے کی پیروی کرسکتا ہے۔
براہ کرم اس ٹیوٹوریل کے لیے فرضی ڈیٹا کا استعمال جاری رکھیں۔ براہ کرم اپنے حقیقی علاج کے نوٹوں کو اس وقت تک تبدیل نہ کریں جب تک کہ آپ کے پاس مناسب اجازتیں اور حفاظتی اقدامات نہ ہوں اور آپ پر لاگو ہونے والے قوانین اور قواعد کی جانچ نہ کر لیں۔
spaCy بعض اوقات متن میں نام اور دیگر تفصیلات تلاش کر سکتا ہے، لیکن یہ ان کو یاد بھی کر سکتا ہے۔ کسی فرد کا نام ہٹانے سے علاج کا ریکارڈ گمنام نہیں ہو جاتا۔ اس ٹیوٹوریل میں صرف فرضی مثالیں استعمال کی گئی ہیں۔ حقیقی دنیا کے تحقیقی منصوبوں کو مناسب منظوریوں اور رازداری کے تحفظات کی ضرورت ہوتی ہے۔
اگر آپ نے پہلے سے ایک فائل نہیں بنائی ہے تو اس طرح کی فائل بنائیں: synthetic_notes.json پر data فولڈر:
[
  {
    "session": 1,
    "client_id": "SYNTHETIC_001",
    "note": "The fictional client described feeling overwhelmed by work demands. They said sleep had been difficult and they were unsure where to begin."
  },
  {
    "session": 2,
    "client_id": "SYNTHETIC_001",
    "note": "The fictional client discussed trying a new evening routine. They described one helpful moment but also mentioned ongoing worry."
  },
  {
    "session": 3,
    "client_id": "SYNTHETIC_001",
    "note": "The fictional client reported a stressful week and said they felt frustrated. They also identified one situation they handled differently."
  },
  {
    "session": 4,
    "client_id": "SYNTHETIC_001",
    "note": "The fictional client described feeling more hopeful about a work conversation. They remained concerned about maintaining the changes."
  },
  {
    "session": 5,
    "client_id": "SYNTHETIC_001",
    "note": "The fictional client questioned whether the current approach was useful and said they had expected a different pace. They wanted to discuss this concern."
  },
  {
    "session": 6,
    "client_id": "SYNTHETIC_001",
    "note": "The fictional client and therapist discussed the concern raised previously. The client described feeling heard, while noting that some questions remained unresolved."
  },
  {
    "session": 7,
    "client_id": "SYNTHETIC_001",
    "note": "The fictional client reflected on using a coping strategy during a difficult conversation. They described both relief and lingering nervousness."
  },
  {
    "session": 8,
    "client_id": "SYNTHETIC_001",
    "note": "The fictional client reviewed topics from the earlier sessions. They described changes they had noticed and identified challenges they still wanted to work on."
  }
]
ہر اندراج میں سیشن نمبر، کنفیگر کردہ کلائنٹ ID، اور ایک نوٹ ہوتا ہے۔ مثالوں میں مثبت اور مشکل دونوں تجربات شامل ہیں۔ ہم نے یہ ماڈل کو ایک مخصوص جواب دینے پر مجبور کرنے کے لیے نہیں لکھا۔ آئیے ماڈل کو چلائیں اور اس سے پیدا ہونے والے نتائج کا جائزہ لیں۔
spaCy کا استعمال کرتے ہوئے نوٹوں کو پری پروسیس کریں۔
متن کی درجہ بندی کرنے سے پہلے، ہم ہر نوٹ کو جملوں میں تقسیم کرنے اور الفاظ کے بارے میں کچھ بنیادی معلومات جمع کرنے کے لیے spaCy کا استعمال کرتے ہیں۔
میں src/preprocessor.py:
from __future__ import annotations
from typing import Any
import spacy

MODEL_NAME = "en_core_web_sm"

def load_nlp(model_name: str = MODEL_NAME):
    return spacy.load(model_name)

_nlp = None

def get_nlp():
    global _nlp
    if _nlp is None:
        _nlp = load_nlp()
    return _nlp

def preprocess_note(text: str, nlp=None) -> dict[str, Any]:
    if not isinstance(text, str):
        raise TypeError("text must be a string")
    if not text.strip():
        return {
            "tokens": [], "lemmas": [], "sentences": [],
            "pos_tags": [], "entities": [],
            "token_count": 0, "sentence_count": 0
        }

    doc = (nlp or get_nlp())(text)
    tokens = [t.text.lower() for t in doc if not t.is_punct and not t.is_space]
    lemmas = [
        t.lemma_.lower() for t in doc
        if not t.is_stop and not t.is_punct and not t.is_space and t.is_alpha
    ]
    sentences = [s.text.strip() for s in doc.sents if s.text.strip()]
    pos_tags = [
        {"text": t.text, "pos": t.pos_, "tag": t.tag_}
        for t in doc if not t.is_punct and not t.is_space
    ]
    entities = [{"text": e.text, "label": e.label_} for e in doc.ents]

    return {
        "tokens": tokens,
        "lemmas": lemmas,
        "sentences": sentences,
        "pos_tags": pos_tags,
        "entities": entities,
        "token_count": len(tokens),
        "sentence_count": len(sentences)
    }
کہ _nlp = None / get_nlp() پیٹرن دیکھنے کے لیے توقف کے قابل ہے۔ اسپیسائی ماڈل کو لوڈ کرنے میں ایک یا دو سیکنڈ لگتے ہیں، اور میں نہیں چاہتا کہ ہر فنکشن کال پر پیسہ خرچ ہو۔ برقرار رکھنے سے _nlp ماڈیول کی سطح کے متغیر کے طور پر، ماڈل ایک بار لوڈ ہوتا ہے اور اس کے بعد کی تمام کالیں اسے دوبارہ استعمال کرتی ہیں۔ کہ (nlp or get_nlp())(text) لکیریں پہلے تو عجیب لگ سکتی ہیں، لیکن اس کا مطلب صرف یہ ہے کہ آپ یا تو وہ ماڈل استعمال کر سکتے ہیں جو میں نے آپ کو دیا تھا یا پھر ڈیفالٹ پر واپس جا سکتے ہیں۔ آپ اصلی ماڈل کے بجائے ہلکا پھلکا جعلی ماڈل بھی پاس کر سکتے ہیں، جس سے آپ کے فنکشن کو بعد میں جانچنا آسان ہو جاتا ہے۔
نوٹ کرنے والی ایک بات یہ ہے کہ ہم اصل جملے درجہ بندی کرنے والے کو دیتے ہیں، صاف ٹوکن یا لیموں کو نہیں۔ یہ جان بوجھ کر ہے۔ "نہیں" جیسے الفاظ کسی جملے کے معنی کو تبدیل کرتے ہیں، اور درجہ بندی سے پہلے انہیں ہٹانے سے ماڈل جو کچھ دیکھتا ہے خاموشی سے بدل سکتا ہے۔
ہستی کی فیلڈز spaCy کے ذریعے پائے جانے والے ممکنہ ناموں، مقامات اور دیگر ناموں کو محفوظ کرتی ہیں۔ یہ کسی بھی ذاتی معلومات کو نہیں ہٹاتا ہے یا آپ کے متن کو گمنام نہیں کرتا ہے۔
DistilBERT کا استعمال کرتے ہوئے جذباتی تجزیہ چلانا
جذبات کا تجزیہ ماڈل کے سیکھے ہوئے مثالوں کی بنیاد پر یہ اندازہ لگانے کا ایک طریقہ ہے کہ متن زیادہ مثبت ہے یا منفی۔ ہم نے جس DistilBERT ماڈل کا انتخاب کیا اسے SST-2 پر مزید تربیت دی گئی، جو کہ انگریزی جملوں کا ایک عام ڈیٹا سیٹ ہے۔ ہر جملے کے لیے مثبت اور منفی سکور دیتا ہے۔
میں src/sentiment.py:
MODEL_ID = "distilbert/distilbert-base-uncased-finetuned-sst-2-english"
_pipeline = None

def get_pipeline():
    global _pipeline
    if _pipeline is None:
        from transformers import pipeline
        _pipeline = pipeline(
            "text-classification", model=MODEL_ID, top_k=None
        )
    return _pipeline

def _normalise_prediction(prediction):
    if isinstance(prediction, dict):
        return [prediction]
    if prediction and isinstance(prediction[0], list):
        return prediction[0]
    return prediction

def analyze_sentiment(sentences: list[str], classifier=None) -> dict:
    clean = [s.strip() for s in sentences if isinstance(s, str) and s.strip()]
    if not clean:
        return {
            "sentence_results": [], "aggregate_score": None,
            "aggregate_label": None, "positive_ratio": 0.0,
            "negative_ratio": 0.0
        }

    model = classifier or get_pipeline()
    predictions = model(clean, truncation=True, batch_size=8)
    results = []

    for sentence, prediction in zip(clean, predictions):
        scores = _normalise_prediction(prediction)
        by_label = {
            item["label"].upper(): float(item["score"])
            for item in scores
        }
        positive = by_label.get("POSITIVE", 0.0)
        negative = by_label.get("NEGATIVE", 0.0)
        signed_score = positive - negative
        label = (
            "POSITIVE" if signed_score > 0
            else "NEGATIVE" if signed_score < 0
            else "BALANCED"
        )
        results.append({
            "sentence": sentence,
            "label": label,
            "positive_score": positive,
            "negative_score": negative,
            "signed_score": round(signed_score, 4)
        })

    values = [item["signed_score"] for item in results]
    aggregate = sum(values) / len(values)
    return {
        "sentence_results": results,
        "aggregate_score": round(aggregate, 4),
        "aggregate_label": (
            "POSITIVE" if aggregate > 0
            else "NEGATIVE" if aggregate < 0
            else "BALANCED"
        ),
        "positive_ratio": round(
            sum(item["label"] == "POSITIVE" for item in results) / len(results), 3
        ),
        "negative_ratio": round(
            sum(item["label"] == "NEGATIVE" for item in results) / len(results), 3
        )
    }
get_pipeline() یہ مندرجہ ذیل سست لوڈنگ پیٹرن کی پیروی کرتا ہے: get_nlp(): ماڈل کو ایک بار لوڈ کیا جاتا ہے اور اس کے بعد کی تمام کالوں پر دوبارہ استعمال کیا جاتا ہے۔ ماحول top_k=None Hugging Face پائپ لائن کو تمام لیبلز کے لیے اسکور واپس کرنے کی ہدایت کرتا ہے، نہ صرف اعلی ترین لیبل۔ اس کے بغیر ہمیں صرف جیتنے والا لیبل ملے گا اور ہم دونوں سکور کا موازنہ نہیں کر پائیں گے۔ truncation=True 512 ٹوکن سے زیادہ لمبا کوئی بھی ان پٹ، زیادہ سے زیادہ جس کو ماڈل سنبھال سکتا ہے، کاٹ دیا جاتا ہے۔ batch_size=8 ماڈل کو ایک وقت میں 8 تک جملے بھیجیں۔ یہ انہیں ایک وقت میں ایک بھیجنے سے زیادہ تیز ہے۔
_normalise_prediction() اس کی وجہ یہ ہے کہ ورژن اور کنفیگریشن پر منحصر ہے، آپ کی پائپ لائن مختلف شکلوں میں نتائج واپس کر سکتی ہے۔ تمام شکلوں کو ایک مربوط فہرست میں تبدیل کرتا ہے۔ {"label": ..., "score": ...} چونکہ یہ ایک لغت ہے، باقی فنکشن میں ہمیشہ ایک ہی قابل عمل فارمیٹ ہوتا ہے۔
ہر جملے کے لیے، by_label فہم پر بنائی گئی ایک لغت جو ہر بڑے لیبل کو اس کے متعلقہ سکور پر نقشہ بناتی ہے۔ signed_score منفی اسکورز کو مثبت اسکورز سے گھٹا دیا جاتا ہے، جس سے -1 اور +1 کے درمیان قدر ہوتی ہے۔ آخر میں، فنکشن ایک سکور بنانے کے لیے تمام دستخط شدہ اسکورز کی اوسط کا حساب لگاتا ہے۔ aggregate_score سیشن کے لیے۔
یہ انڈیکس صرف ایک خلاصہ ہے جو ماڈل سکور سے تیار کیا گیا ہے۔ یہ طبی طور پر منظور شدہ پیمانہ، صحت یابی کا سکور، یا تندرستی کا پیمانہ نہیں ہے۔ 0 کے قریب سکور کا مطلب یہ ہو سکتا ہے کہ مثبت اور منفی نتائج ایک دوسرے کے خلاف متوازن ہیں۔
DistilRoBERta کا استعمال کرتے ہوئے جذبات کی درجہ بندی
جذبات اور جذبات کی درجہ بندی ایک جیسی نہیں ہے۔ جذبات کے مثبت یا منفی نتائج کی ایک وسیع رینج ہوتی ہے۔ جذبات کی درجہ بندی خوشی، اداسی، غصہ اور خوف جیسے زمروں کو دیکھتی ہے۔
میں src/emotions.py:
MODEL_ID = "j-hartmann/emotion-english-distilroberta-base"
_pipeline = None

def get_pipeline():
    global _pipeline
    if _pipeline is None:
        from transformers import pipeline
        _pipeline = pipeline(
            "text-classification", model=MODEL_ID, top_k=None
        )
    return _pipeline

def _normalise_prediction(prediction):
    if isinstance(prediction, dict):
        return [prediction]
    if prediction and isinstance(prediction[0], list):
        return prediction[0]
    return prediction

def detect_emotions(sentences: list[str], classifier=None) -> dict:
    clean = [s.strip() for s in sentences if isinstance(s, str) and s.strip()]
    if not clean:
        return {
            "per_sentence": [], "emotion_distribution": {},
            "session_dominant_emotion": None
        }

    model = classifier or get_pipeline()
    predictions = model(clean, truncation=True, batch_size=8)
    per_sentence = []
    totals = {}

    for sentence, prediction in zip(clean, predictions):
        scores = _normalise_prediction(prediction)
        score_map = {
            item["label"].lower(): float(item["score"])
            for item in scores
        }
        for label, score in score_map.items():
            totals[label] = totals.get(label, 0.0) + score
        dominant = max(score_map, key=score_map.get)
        per_sentence.append({
            "sentence": sentence,
            "dominant_emotion": dominant,
            "scores": score_map
        })

    distribution = {
        label: round(score / len(clean), 4)
        for label, score in totals.items()
    }
    dominant_session = max(distribution, key=distribution.get)
    return {
        "per_sentence": per_sentence,
        "emotion_distribution": distribution,
        "session_dominant_emotion": dominant_session
    }
کہ totals لغت جملے میں اسکور جمع کرتی ہے۔ ہر جملے کے لیے، لوپ تمام جذباتی لیبلز کے اسکور کو چلتے ہوئے کل میں شامل کرتا ہے۔ استعمال کریں totals.get(label, 0.0) یہ لیبل پہلی بار ظاہر ہونے پر کلیدی خرابی پیدا کرنے کے بجائے 0 سے شروع کرکے محفوظ طریقے سے کیا جاتا ہے۔
max(score_map, key=score_map.get) سب سے زیادہ سکور والا لیبل تلاش کریں۔ score_map اس جملے کے بارے میں۔ کہ key دلیل کہتی ہے۔ max() کلیدوں کے بجائے لغت میں اقدار کا موازنہ کرتا ہے۔
تمام جملوں پر کارروائی کے بعد، distribution پورے سیشن میں فی جذبات کا اوسط سکور دینے کے لیے ہر مجموعی کل کو جملوں کی تعداد سے تقسیم کریں۔ max(distribution, key=distribution.get) سیشن کی سطح پر غالب جذبات کو تلاش کرنے کے لیے اسی طرز کا اطلاق کریں۔
یہ نتیجہ ماڈل کی پیشن گوئی ہے۔ وہ اس بات کی جانچ نہیں کرتے کہ کوئی کیسا محسوس کرتا ہے۔ ماڈل کو سادہ انگریزی متن پر تربیت دی گئی تھی، لیکن تھراپی کے نوٹ مختلف مقاصد کے لیے لکھے گئے تھے اور مختلف زبانیں استعمال کر سکتے تھے۔ آپ کو یہ نہیں سمجھنا چاہئے کہ آپ کا ماڈل اس ماڈل پر قابل اعتماد طریقے سے کام کرے گا۔
لسانی خصوصیات کی جانچ کرنا
آسان زبان کی خصوصیات کو بھی شمار کیا جا سکتا ہے۔ مثال کے طور پر، آپ شمار کر سکتے ہیں کہ پہلے فرد کے ضمیر کتنی بار ظاہر ہوتے ہیں اور "شاید،" "شاید،" اور "شاید" جیسے جملے تلاش کر سکتے ہیں۔ یہ ایک ہیجنگ جملے کی ایک مثال ہے جسے لوگ بعض اوقات اس وقت استعمال کرتے ہیں جب وہ غیر یقینی یا محتاط ہوتے ہیں۔
اس خصوصیت کو شامل کریں۔ src/preprocessor.py:
def extract_linguistic_features(text: str) -> dict:
    doc = get_nlp()(text)
    first_person = {
        "i", "me", "my", "mine", "myself", "we", "us",
        "our", "ours", "ourselves"
    }
    third_person = {
        "he", "him", "his", "himself", "she", "her", "hers",
        "herself", "they", "them", "their", "theirs",
        "themselves", "it", "its", "itself"
    }
    second_person = {"you", "your", "yours", "yourself", "yourselves"}

    pronouns = [token.text.lower() for token in doc if token.pos_ == "PRON"]
    first = sum(word in first_person for word in pronouns)
    third = sum(word in third_person for word in pronouns)
    second = sum(word in second_person for word in pronouns)
    total = first + third + second

    hedging_phrases = (
        "maybe", "perhaps", "possibly", "i guess", "not sure",
        "sort of", "kind of", "i think", "might"
    )
    lower = text.lower()
    hedging_count = sum(lower.count(phrase) for phrase in hedging_phrases)

    return {
        "first_person_count": first,
        "third_person_count": third,
        "second_person_count": second,
        "pronoun_count": total,
        "first_person_ratio": round(first / total, 3) if total else 0.0,
        "hedging_phrase_count": hedging_count
    }
token.pos_ == "PRON" پارٹ آف اسپیچ ٹیگز کی بنیاد پر ٹوکنز کو فلٹر کریں۔ spaCy اس ٹیگ کو ان الفاظ کو تفویض کرتا ہے جن کی شناخت ضمیر کے طور پر ہوتی ہے۔ تین کا سیٹ first_person، third_personاور second_person ہر گروپ سے تعلق رکھنے والے چھوٹے حروف کی وضاحت کریں۔ اندرونی جنریٹر اظہار sum() چیک کرتا ہے کہ آیا ہر ضمیر ٹوکن کا متن اس سیٹ سے تعلق رکھتا ہے اور میچوں کی تعداد کو شمار کرتا ہے۔
first_person_ratio پہلے شخص کی تعداد کو ضمیروں کی کل تعداد سے تقسیم کریں۔ کہ if total else 0.0 جب ضمیر متن میں ظاہر نہیں ہوتے ہیں تو گارڈ تقسیم بہ صفر کی غلطیوں کو روکتا ہے۔
ہیجنگ جملے کے لیے، text.lower() ہم تلاش کرنے سے پہلے پورے نوٹ کو چھوٹے حروف میں تبدیل کرتے ہیں، لہذا "شاید" اور "شاید" کے ساتھ ایک جیسا سلوک کیا جاتا ہے۔ lower.count(phrase) وہ جملہ جتنی بار سب اسٹرنگ کے طور پر ظاہر ہوتا ہے اس کی تعداد لوٹاتا ہے۔ ہر فقرے کے نتائج آگے شامل کیے جاتے ہیں۔ hedging_count.
یہ تعداد محض ایک گنتی ہے۔ یہ اس بات کی وضاحت نہیں کرتا کہ کسی نے کوئی خاص لفظ یا جملہ کیوں استعمال کیا۔ معنی سیاق و سباق پر منحصر ہے اور نوٹ کس نے لکھا ہے۔ یہ سمجھنے کے لیے کہ آیا یہ خصوصیات کارآمد ہیں، ہمیں احتیاط سے لیبل کی گئی مثالوں سے ان کا موازنہ کرنے کی ضرورت ہے۔ یہ اس ٹیوٹوریل کے دائرہ کار سے باہر ہے۔
سیشنوں کے درمیان نتائج کا موازنہ کریں۔
ہر سیشن نتائج کا ایک سیٹ تیار کرتا ہے۔ ہم نتائج کو ہر سیشن کے لیے ایک قطار پر مشتمل ٹیبل میں رکھنے کے لیے پانڈا استعمال کریں گے۔ یہ وقت کے ساتھ نتائج کا موازنہ کرنا آسان بناتا ہے۔
میں src/tracker.py:
import pandas as pd

def build_session_timeline(session_results: list[dict]) -> pd.DataFrame:
    rows = []
    for result in session_results:
        sentiment = result["sentiment"]
        emotions = result["emotions"]
        linguistic = result["linguistic_features"]
        rows.append({
            "session": result["session"],
            "sentiment_index": sentiment["aggregate_score"],
            "sentiment_label": sentiment["aggregate_label"],
            "dominant_emotion": emotions["session_dominant_emotion"],
            "first_person_ratio": linguistic["first_person_ratio"],
            "hedging_phrase_count": linguistic["hedging_phrase_count"],
            "sentence_count": result["sentence_count"]
        })

    columns = [
        "session", "sentiment_index", "sentiment_label",
        "dominant_emotion", "first_person_ratio",
        "hedging_phrase_count", "sentence_count"
    ]
    if not rows:
        return pd.DataFrame(columns=columns)
    return pd.DataFrame(rows).sort_values("session").reset_index(drop=True)

def describe_sentiment_shift(df: pd.DataFrame) -> dict:
    if df.empty:
        return {
            "session_count": 0,
            "first_half_mean": None,
            "second_half_mean": None,
            "difference": None,
            "description": "No sessions to compare"
        }

    midpoint = max(1, len(df) // 2)
    first = df.iloc[:midpoint]["sentiment_index"].dropna()
    second = df.iloc[midpoint:]["sentiment_index"].dropna()
    first_mean = float(first.mean()) if not first.empty else None
    second_mean = float(second.mean()) if not second.empty else None
    difference = (
        second_mean - first_mean
        if first_mean is not None and second_mean is not None
        else None
    )

    if difference is None:
        description = "Insufficient non-missing scores to compare halves"
    elif difference > 0.05:
        description = "Higher average model sentiment index in the second half"
    elif difference < -0.05:
        description = "Lower average model sentiment index in the second half"
    else:
        description = "Little difference between the two half-period averages"

    return {
        "session_count": len(df),
        "first_half_mean": first_mean,
        "second_half_mean": second_mean,
        "difference": round(difference, 4) if difference is not None else None,
        "description": description
    }
build_session_timeline() ہر سیشن کے نتائج پر اعادہ کریں، نیسٹڈ ڈکشنری سے مطلوبہ فیلڈز حاصل کریں، اور پھر فلیٹ ڈکشنری کو ایک قطار کے طور پر شامل کریں۔ pd.DataFrame(rows) قطاروں کی فہرست کو ٹیبل میں تبدیل کریں۔ .sort_values("session") قطاروں کو سیشن نمبر کے لحاظ سے ترتیب دیں اور .reset_index(drop=True) انڈیکس کو 0 سے شروع ہونے والی صاف ترتیب سے تبدیل کریں۔
میں describe_sentiment_shift()، df.iloc[:midpoint] پوزیشن کے لحاظ سے قطار کے پہلے نصف حصے کو منتخب کرتا ہے۔ .dropna() درج ذیل لائنوں کو ہٹا دیں: sentiment_index ایک گمشدہ قدر مجموعی اوسط نہیں بناتی کیونکہ یہ اوسط کا حساب لگانے سے پہلے غائب ہے۔ NaN. 0.05 کی حد وضاحتوں کو بہت چھوٹے عددی فرق کو معنی خیز کہنے سے روکتی ہے۔
تفصیل سے مراد صرف ماڈل کی جذباتی مقدار ہے۔ ہم "مضبوط بہتری" یا "طبی خرابی" جیسے لیبلز کا استعمال نہیں کرتے ہیں کیونکہ ماڈل سکور میں تبدیلیاں کسی کی دماغی صحت میں تبدیلی یا علاج کے ساتھ پیشرفت کو ظاہر نہیں کرتی ہیں۔
آؤٹ پٹ ویژولائزیشن
چارٹس آپ کے نتائج کو صرف ٹیبلز کے مقابلے میں سمجھنے میں آسان بناتے ہیں۔ چار چارٹ بنائیں: جذبات کا حصّہ، ہر سیشن کے لیے ممکنہ طور پر پیش گوئی کردہ جذبات، پہلے فرد کے ضمیر کا تناسب، اور ہیجنگ کے فقروں کی تعداد۔
میں src/visualizer.py:
import matplotlib.pyplot as plt
import pandas as pd

def plot_dashboard(
    df: pd.DataFrame,
    output_path: str = "images/session_dashboard.png"
):
    if df.empty:
        raise ValueError("Cannot plot an empty session timeline")

    fig, axes = plt.subplots(2, 2, figsize=(12, 8))
    sessions = df["session"]

    axes[0, 0].plot(sessions, df["sentiment_index"], marker="o")
    axes[0, 0].axhline(0, linestyle="--", linewidth=1)
    axes[0, 0].set(
        title="Model sentiment index by session",
        xlabel="Session",
        ylabel="Positive score minus negative score"
    )

    emotion_codes = {
        name: i for i, name in enumerate(
            sorted(df["dominant_emotion"].dropna().unique())
        )
    }
    emotion_values = [
        emotion_codes.get(value, -1)
        for value in df["dominant_emotion"]
    ]
    axes[0, 1].scatter(sessions, emotion_values)
    axes[0, 1].set(
        title="Dominant predicted emotion",
        xlabel="Session",
        ylabel="Emotion category"
    )
    axes[0, 1].set_yticks(
        list(emotion_codes.values()), list(emotion_codes.keys())
    )

    axes[1, 0].plot(sessions, df["first_person_ratio"], marker="o")
    axes[1, 0].set(
        title="First-person pronoun share",
        xlabel="Session",
        ylabel="Share of counted pronouns",
        ylim=(0, 1)
    )

    axes[1, 1].bar(sessions, df["hedging_phrase_count"])
    axes[1, 1].set(
        title="Selected hedging phrases",
        xlabel="Session",
        ylabel="Phrase count"
    )

    fig.suptitle("Exploratory text-analysis outputs (synthetic data)")
    fig.tight_layout()
    fig.savefig(output_path, dpi=160, bbox_inches="tight")
    plt.close(fig)
    return output_path
plt.subplots(2, 2, figsize=(12, 8)) 2 x 2 گرڈ میں ذیلی پلاٹ کے ساتھ ایک شکل تیار کرتا ہے۔ ایک Figure آبجیکٹ لوٹاتا ہے۔ fig اور ایک 2D صف axes کہاں axes[row, col] ہر چارٹ فراہم کیا گیا ہے۔
جذباتی چارٹ استعمال کرتے ہیں: axes[0, 0].axhline(0) 0 پر ایک افقی بیس لائن بنائیں۔ اس سے ایک نظر میں یہ دیکھنا آسان ہو جاتا ہے کہ کون سے سیشن خالص مثبت یا خالص منفی انڈیکس تیار کر رہے ہیں۔
جذباتی چارٹس کو ایک اضافی قدم کی ضرورت ہوتی ہے کیونکہ Matplotlib scatterplots کو نمبرز کی ضرورت ہوتی ہے، تاروں کی نہیں۔ emotion_codes ایک لغت جو ہر منفرد جذباتی لیبل کو ایک عدد میں نقشہ بناتی ہے: enumerate. emotion_values غالب جذباتی کالم کو سازش کے مقاصد کے لیے اس کے عدد کے برابر میں تبدیل کریں۔ set_yticks() یہ پھر y-axis پر اصل لیبل کے ناموں کو بحال کرتا ہے، لہذا چارٹ نمبروں کے بجائے الفاظ دکھاتا ہے۔
fig.tight_layout() اوور لیپنگ ٹائٹلز اور لیبلز سے بچنے کے لیے ذیلی پلاٹوں کے درمیان وقفہ کاری کو خودکار طور پر ایڈجسٹ کرتا ہے۔ fig.savefig() مکمل تصویر کو فائل میں لکھیں۔ plt.close(fig) تصویر کے ذریعہ استعمال شدہ میموری کو آزاد کرتا ہے۔
[Figure 2: figure-2.png]
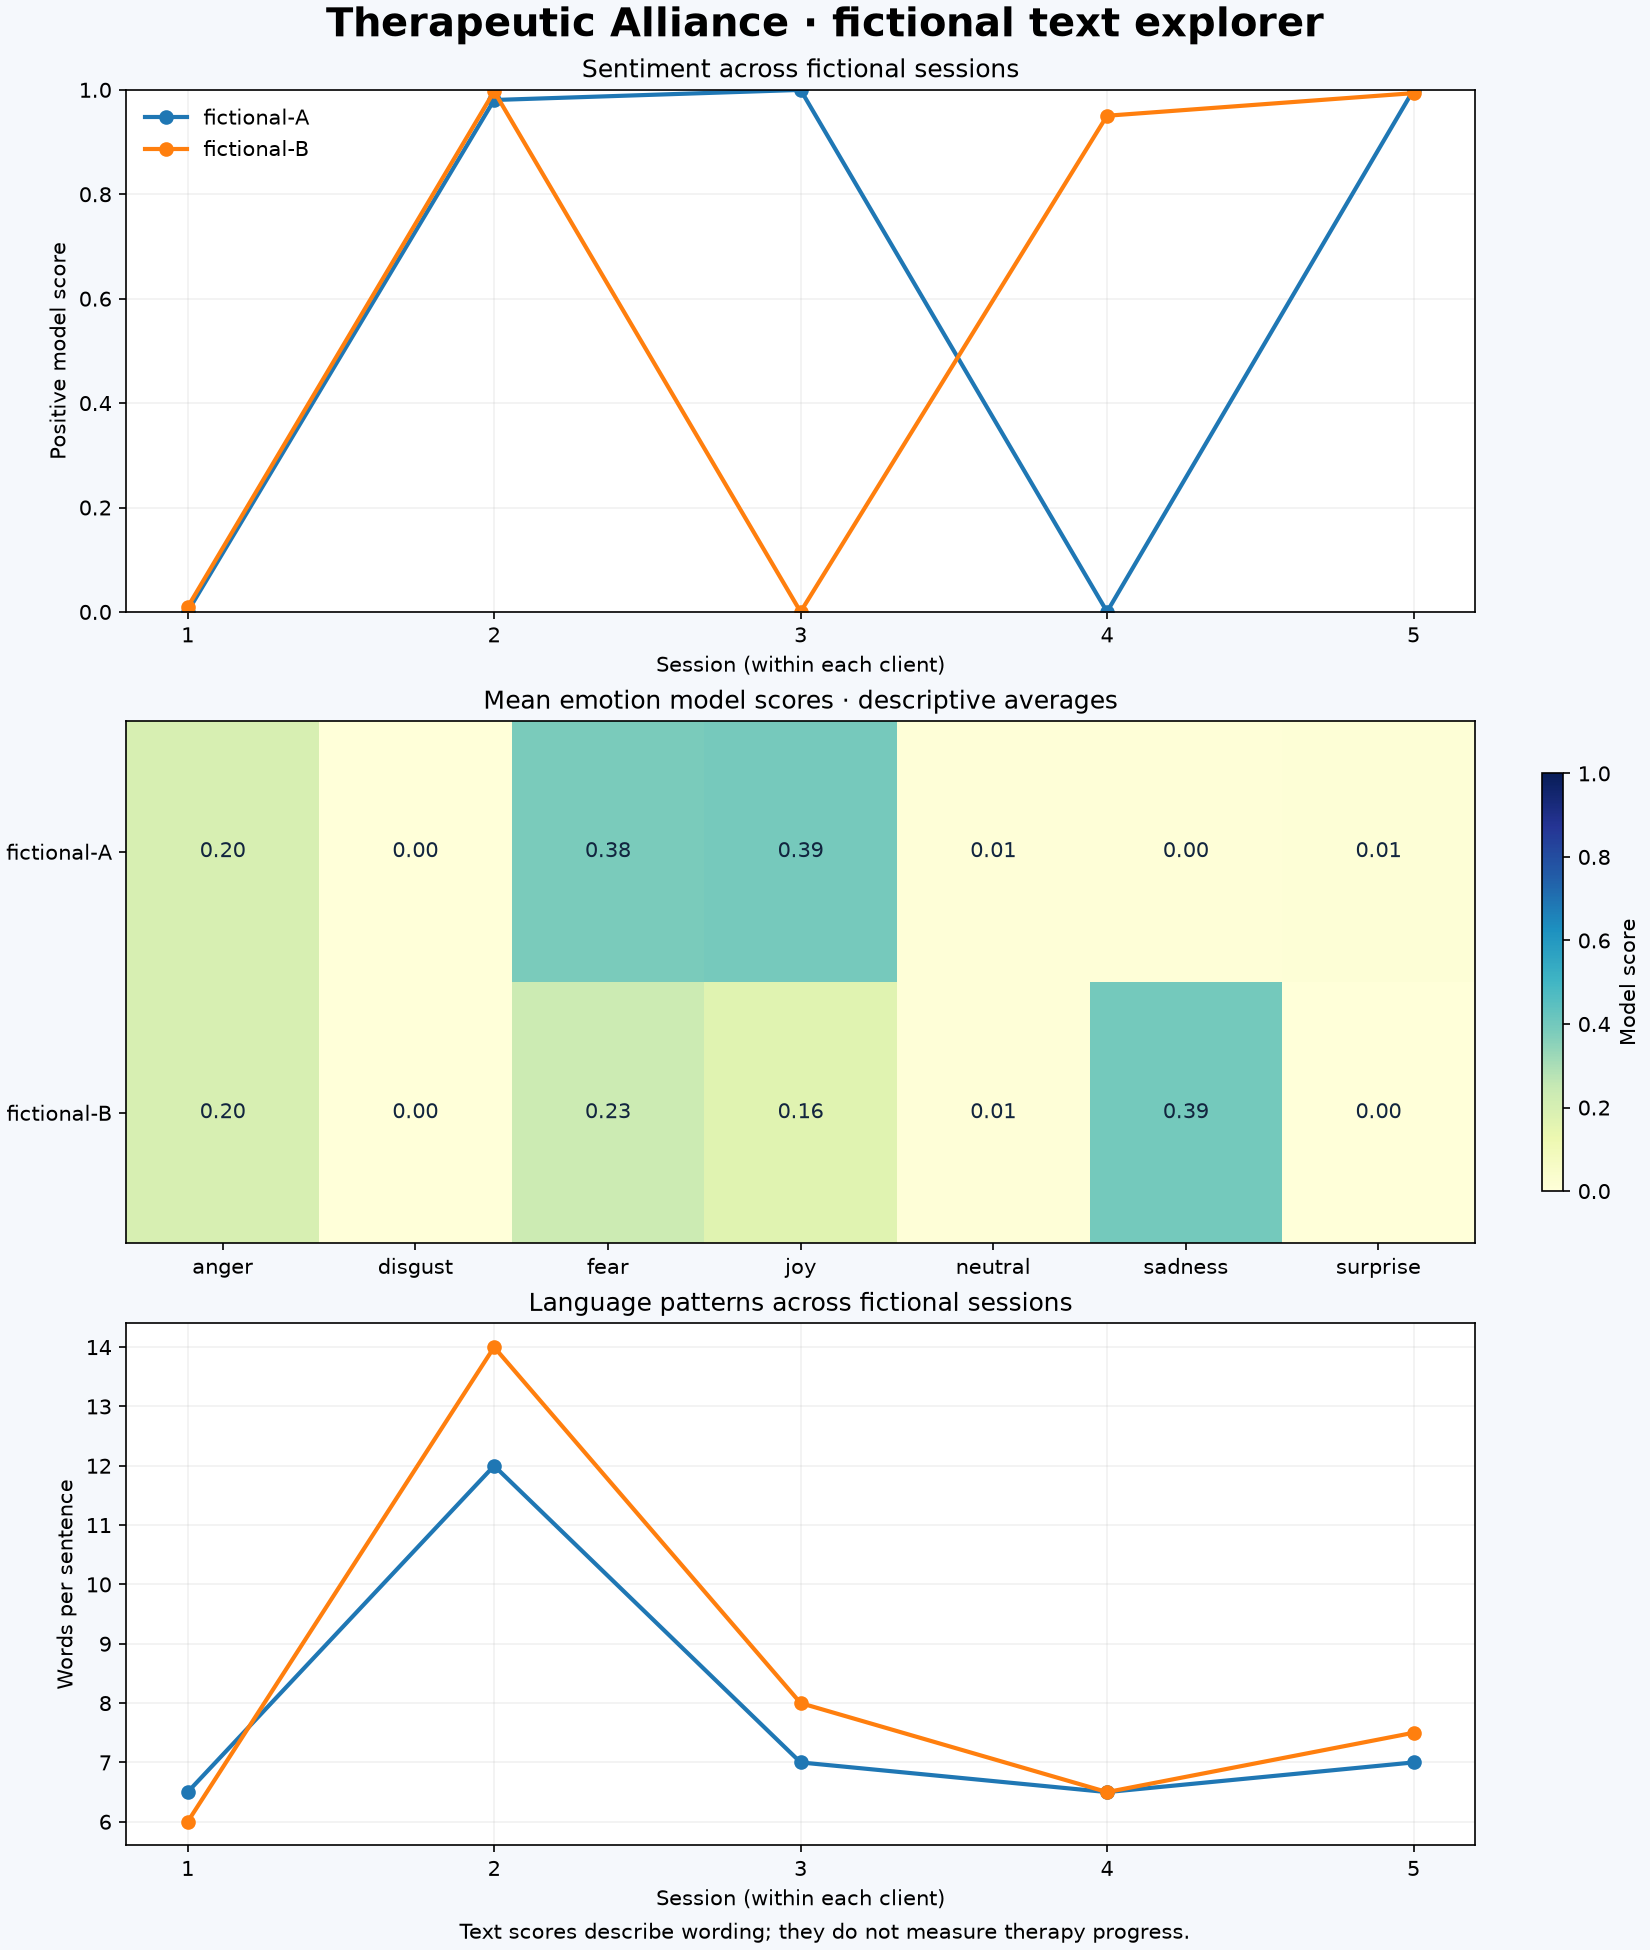
شکل 2۔ ورچوئل سیشن کے لیے ڈیش بورڈ کی مثال۔ اسکور اور زبان کے شمار ماڈل آؤٹ پٹ اور ٹیکسٹ فیچرز ہیں اور علاج کی پیشرفت کی پیمائش نہیں کرتے ہیں۔
ہر چارٹ مختلف نتائج دکھاتا ہے۔ جذباتی چارٹ ماڈل سکور سے شمار کردہ ایک انڈیکس دکھاتا ہے۔ جذباتی چارٹ ہر سیشن میں سب سے زیادہ اسکور کرنے والے آئٹمز دکھاتا ہے۔ دوسرے دو چارٹ براہ راست متن سے لیے گئے شمار یا فیصد دکھاتے ہیں۔
یہ ڈیش بورڈ کسی کے علاج کی پیشرفت کی رپورٹ نہیں ہے۔ صرف ہمارے منتخب کردہ ماڈل اور کوڈ کے ذریعہ تیار کردہ نتائج دکھائے جائیں گے۔
پائپ لائن کنکشن
اگلا، ہم پروجیکٹ کے مختلف حصوں کو جوڑنے کے لیے Python کلاسز کا استعمال کریں گے۔ یہ آپ کو شروع کرنے کے لیے ایک جگہ دیتا ہے جب آپ ایک نوٹ یا ایک سے زیادہ نوٹ کا تجزیہ کرنا چاہتے ہیں۔
میں analyzer.py:
from src.preprocessor import preprocess_note, extract_linguistic_features
from src.sentiment import analyze_sentiment
from src.emotions import detect_emotions
from src.tracker import build_session_timeline, describe_sentiment_shift

class TherapyNoteAnalyzer:
    def analyze_session(self, note_data: dict) -> dict:
        required = {"session", "client_id", "note"}
        missing = required - note_data.keys()
        if missing:
            raise ValueError(f"Missing required fields: {sorted(missing)}")

        processed = preprocess_note(note_data["note"])
        sentiment = analyze_sentiment(processed["sentences"])
        emotions = detect_emotions(processed["sentences"])
        linguistic = extract_linguistic_features(note_data["note"])

        return {
            "session": note_data["session"],
            "client_id": note_data["client_id"],
            "sentence_count": processed["sentence_count"],
            "sentiment": sentiment,
            "emotions": emotions,
            "linguistic_features": linguistic,
            "entity_candidates": processed["entities"]
        }

    def analyze_all(self, notes: list[dict]) -> dict:
        if not notes:
            timeline = build_session_timeline([])
            return {
                "client_id": None,
                "session_results": [],
                "timeline": timeline,
                "sentiment_comparison": describe_sentiment_shift(timeline)
            }

        client_ids = {item.get("client_id") for item in notes}
        if len(client_ids) != 1:
            raise ValueError(
                "This example expects notes for one synthetic client at a time"
            )

        results = [self.analyze_session(item) for item in notes]
        timeline = build_session_timeline(results)
        return {
            "client_id": next(iter(client_ids)),
            "session_results": results,
            "timeline": timeline,
            "sentiment_comparison": describe_sentiment_shift(timeline)
        }
آخر کار main.py:
import json
from pathlib import Path
from analyzer import TherapyNoteAnalyzer
from src.visualizer import plot_dashboard

def main():
    with Path("data/synthetic_notes.json").open(encoding="utf-8") as file:
        notes = json.load(file)

    results = TherapyNoteAnalyzer().analyze_all(notes)
    print(results["timeline"].to_string(index=False))
    print("nDescriptive comparison:", results["sentiment_comparison"])

    output = plot_dashboard(results["timeline"])
    print(f"nSaved dashboard to {output}")
    print("Reminder: these model outputs are exploratory, not clinical assessments.")

if __name__ == "__main__":
    main()
پروجیکٹ کو روٹ ڈائرکٹری سے چلائیں۔
python main.py
جب آپ پہلی بار اسکرپٹ چلاتے ہیں تو تمام Hugging Face ماڈلز ڈاؤن لوڈ ہو جائیں گے۔ پھر سیشن رزلٹ ٹیبل پرنٹ کریں اور ڈیش بورڈ امیج کو امیجز فولڈر میں محفوظ کریں۔
ماڈل ورژن اور کوڈ کو چلانے کے طریقے کے لحاظ سے نتائج مختلف ہو سکتے ہیں۔ ہمیشہ اپنی پھانسی کے نتائج کو چیک کریں۔ یہ کہنے کے بجائے کہ سیشن نے کیا "دکھایا" یا "ظاہر کیا"، ماڈل نے کیا پیشین گوئی کی تھی۔ ماڈل کی پیشین گوئیاں اس بات کا ثبوت نہیں ہیں کہ کیا ہوا ہے۔
منصوبے کی جانچ
جانچ اس بات کو یقینی بنانے میں مدد کرتی ہے کہ آپ کا فنکشن عام ان پٹ اور غیر معمولی ان پٹ پر کام کرتا ہے، جیسے کہ خالی متن۔ ان ٹیسٹوں کو پاس کرنے سے یہ ثابت نہیں ہوتا ہے کہ یہ ماڈل طبی ترتیب میں درست یا مفید ہے۔
جذبات اور جذبات کی جانچ کے لیے، ہم ایک جعلی درجہ بندی کا استعمال کرتے ہیں جو پہلے سے منتخب کردہ نتائج کو لوٹاتا ہے۔ یہ جانچ کو تیز کرتا ہے اور ماڈل فائلوں کو ڈاؤن لوڈ کرنے کی ضرورت کو ختم کرتا ہے۔
ایک آسان تشخیصی ٹیسٹ مندرجہ ذیل ہے:
from src.sentiment import analyze_sentiment

class FakeSentiment:
    def __call__(self, texts, **kwargs):
        return [
            [
                {"label": "POSITIVE", "score": 0.8},
                {"label": "NEGATIVE", "score": 0.2}
            ],
            [
                {"label": "POSITIVE", "score": 0.1},
                {"label": "NEGATIVE", "score": 0.9}
            ]
        ][:len(texts)]

def test_sentiment_score_is_positive_minus_negative():
    result = analyze_sentiment(
        ["Good sentence.", "Bad sentence."],
        classifier=FakeSentiment()
    )
    assert result["sentence_results"][0]["signed_score"] == 0.6
    assert result["sentence_results"][1]["signed_score"] == -0.8
FakeSentiment چونکہ آپ اس کی وضاحت کرتے ہیں، آپ فوری طور پر اصل ماڈل کو تبدیل کر سکتے ہیں۔ __call__. جب ازگر دیکھتا ہے۔ model(clean, ...)یہ کال کرتا ہے model.__call__(clean, ...)کوئی بھی شے جو اس طریقہ کو استعمال کرتی ہے وہ کال ایبل کی طرح برتاؤ کرتی ہے۔ FakeSentiment.__call__ ان پٹ ٹیکسٹ سے قطع نظر اسکورز کی ایک مقررہ فہرست لوٹاتا ہے۔ اس کا مطلب یہ ہے کہ ٹیسٹ ماڈل کو ڈاؤن لوڈ کیے بغیر حساب کتاب کی منطق کی تصدیق کرتا ہے۔
[:len(texts)] ان پٹ جملوں کی تعداد سے ملنے کے لیے واپسی کی قدر کو تقسیم کریں۔ یہ جعلی درجہ بندی کرنے والوں کو ان پٹ سے زیادہ نتائج واپس کرنے سے روکتا ہے۔ zip() کو analyze_sentiment آپ کچھ غیر متوقع طور پر کریں گے۔
گزرنا classifier=FakeSentiment() کو analyze_sentiment دوبارہ وضاحت کریں get_pipeline() اس فون کال کی وجہ سے۔ اس پیٹرن کو انحصار انجیکشن کہا جاتا ہے۔ فنکشنز انحصار کو اندرونی طور پر بنانے کے بجائے خارجی طور پر قبول کرتے ہیں، جس سے انہیں جانچنا اور دوبارہ استعمال کرنا آسان ہو جاتا ہے۔
پورے پروجیکٹ میں خالی ان پٹ، جملے کی تقسیم، ورڈ پروسیسنگ، جذباتی سکور کیلکولیشن، جذباتی سکور کا خلاصہ، سیشن چھانٹنا، خالی ٹائم لائن، اور ٹیسٹنگ شامل ہیں تاکہ یہ یقینی بنایا جا سکے کہ مطلوبہ ان پٹ فیلڈز موجود ہیں۔
پروجیکٹ روٹ سے ٹیسٹ سویٹ چلائیں۔
python -m pytest -q
پروجیکٹ آرکائیو میں 15 ٹیسٹ ہیں، اور تمام 15 پاس ہوئے جب پروجیکٹ کی تصدیق کی گئی۔ کچھ ٹیسٹ کنفیگرڈ ماڈل کے نتائج کا استعمال کرتے ہیں، جب کہ دیگر منتخب ٹیکسٹ پروسیسنگ کے مراحل کی تصدیق کے لیے چھوٹی spaCy ترتیبات استعمال کرتے ہیں۔ یہ ٹیسٹ ماڈل کی درستگی کی پیمائش نہیں کرتے ہیں، اس بات کی تصدیق نہیں کرتے ہیں کہ جذباتی لیبل درست ہیں، یا یہ ظاہر کرتے ہیں کہ اصل تھراپی نوٹوں میں ماڈل کس طرح کارکردگی کا مظاہرہ کرتا ہے۔
حدود اور اخلاقی تحفظات
چونکہ یہ پروجیکٹ تھراپی سے متعلق متن کا استعمال کرتا ہے، ہمیں رازداری، ماڈل کی حدود، اور زبان کے نمونوں اور ماہر طبی تشخیص کے درمیان فرق کے بارے میں احتیاط سے سوچنے کی ضرورت ہے۔
عام ڈومین ماڈل کلینیکل ماڈل نہیں ہے۔
DistilBERT ماڈل کو SST-2 پر تربیت دی گئی تھی، علاج کے نوٹس پر نہیں۔ DistilRoBERTA ماڈل کی تربیت سادہ انگریزی عبارتوں کے مرکب پر کی گئی تھی۔ یہ جاننا ناممکن ہے کہ دونوں ماڈلز کلینکل نوٹ میں کتنی اچھی کارکردگی کا مظاہرہ کریں گے جب تک کہ ان کا مناسب ڈیٹا اور واضح لیبل کے ساتھ الگ سے تجربہ نہ کیا جائے۔ یہ ماڈل رسمی تحریر، انگریزی کو ایک اضافی زبان کے طور پر بولنے والے لوگوں کی تحریر، اور درد کو غیر تسلی بخش اظہار کرنے کے مختلف ثقافتی طریقوں سے بھی آگاہ کر سکتا ہے۔ ان کے تربیتی ڈیٹا کو ان تمام حالات کا احاطہ کرنے کے لیے ڈیزائن نہیں کیا گیا ہے۔
جذبات شفا یابی کو آگے نہیں بڑھاتے ہیں۔
مثبت بیانات سے یہ ثابت نہیں ہوتا کہ کلائنٹ بہتر ہو رہا ہے۔ ایک منفی بیان یہ ثابت نہیں کرتا کہ علاج ناکام ہو گیا۔ نوٹس میں معالج کے خیالات، مؤکل کے اپنے الفاظ، مشکل واقعات، یا ان کا مرکب شامل ہو سکتا ہے۔ ماڈل فرق بتانے کے قابل نہیں ہوسکتا ہے۔
لسانی خصلتیں کوئی نفسیاتی تشخیص نہیں ہیں۔
ضمیر کی گنتی اور ہیجنگ کے جملے سادہ خصوصیات ہیں جو متن میں مل سکتی ہیں۔ ان نمبروں میں تبدیلی سے یہ ثابت نہیں ہوتا کہ کلائنٹ پیچھے ہٹ رہا ہے، موضوع سے گریز کر رہا ہے، اعتماد کھو رہا ہے، یا معالج کے ساتھ کوئی مسئلہ ہے۔ اس پروجیکٹ کے پچھلے ورژن میں، برسٹ اسکورنگ کو ہٹا دیا گیا تھا کیونکہ اسکورنگ کے قواعد اور وارننگ لیولز کو طبی استعمال کے لیے جانچ یا منظور نہیں کیا گیا تھا۔
پرائیویسی کے تقاضے دائرہ اختیار کے لحاظ سے مختلف ہوتے ہیں۔
ریاستہائے متحدہ میں، HIPAA کچھ صحت کی دیکھ بھال کرنے والی تنظیموں اور ان کے کاروباری شراکت داروں پر لاگو ہوتا ہے۔ دوسرے ممالک کے اپنے ڈیٹا کے تحفظ اور طبی رازداری کے قوانین ہیں۔ جسمانی ریکارڈ استعمال کرنے سے پہلے، تنظیموں کو قابل اطلاق قوانین، ان کی اپنی پالیسیاں، ڈیٹا استعمال کرنے کی قانونی وجوہات، مطلوبہ رضامندی، متعلقہ خدمات اور وینڈرز، حفاظتی اقدامات، اور ڈیٹا کو برقرار رکھنے کی مدت کی جانچ کرنی چاہیے۔ یہ ٹیوٹوریل اس جائزے کی جگہ نہیں لیتا۔ یہاں تک کہ اگر آپ جہاں رہتے ہیں وہاں HIPAA لاگو نہیں ہوتا ہے، اس کا مطلب یہ نہیں ہے کہ آپ کے علاج کے اصل ریکارڈ کو سنبھالنا محفوظ یا اخلاقی ہے۔
انسانی نگرانی اور شفافیت
اس پروجیکٹ کا مقصد طبی فیصلوں کی بنیاد کے طور پر نہیں ہے، اور اسے استعمال نہیں کیا جانا چاہیے۔ حقیقی دنیا کے صحت کی دیکھ بھال کے کام کے لیے غور کیا جانے والا کوئی بھی NLP ٹول اس مخصوص ترتیب کے لیے ٹیسٹ کیا جانا چاہیے۔ اس کے لیے رازداری اور تعصب کا جائزہ، واضح دستاویزات، اور اہل پیشہ ور افراد کی نگرانی کی بھی ضرورت ہے۔ جو لوگ معلومات استعمال کرتے ہیں ان کو قابل اطلاق قواعد کے مطابق مطلع کیا جانا چاہیے۔
نتیجہ اور مزید سیکھنا
اس پروجیکٹ میں، ہم نے spaCy، Hugging Face Transformers، pandas، اور Matplotlib کا استعمال کرتے ہوئے ایک NLP ورک فلو بنایا ہے۔ فرضی تھراپی نوٹ کا استعمال کرتے ہوئے، ہم نے دکھایا کہ متن کو جملوں میں کیسے تقسیم کیا جائے، احساسات اور جذبات کی درجہ بندی کیسے کی جائے، زبان کی خصوصیات کا حساب لگایا جائے، سیشنز کا موازنہ کیا جائے، چارٹ بنایا جائے، اور ٹیسٹ کوڈ کیسے بنایا جائے۔
NLP بڑی مقدار میں تحریری متن کو ڈیٹا میں تبدیل کرنے میں ہماری مدد کرتا ہے جسے ہم منظم اور دریافت کر سکتے ہیں۔ تاہم، نتائج کی حدود ہیں۔ یہ خاص طور پر درست ہے جب عام مقصد کے ماڈلز کو حساس قسم کے متن کے لیے استعمال کرتے ہیں جنہیں سمجھنے کے لیے ان کی تربیت یا تجربہ نہیں کیا گیا ہے۔
اگر آپ اس منصوبے پر تعمیر کرنا چاہتے ہیں، تو یہاں کچھ خیالات ہیں:
مختلف جذباتی ماڈلز آزمائیں اور پیشین گوئیوں کا موازنہ کریں۔ نوٹ کریں کہ وہ کہاں متفق ہیں اور کہاں متفق ہیں۔
ماڈل کی کارکردگی کے بارے میں دعوے کرنے سے پہلے، انسانی تصدیق شدہ لیبلز کے ساتھ ڈیٹا سیٹس بنائیں اور انہیں استعمال کرنے کے لیے مناسب اخلاقی منظوری حاصل کریں۔
ایک بار جب آپ کے پاس موازنہ کرنے کے لیے صحیح لیبل ہو جائیں، تو درستگی، یاد کرنے، F1 سکور، اور کنفیوژن میٹرکس جیسے اقدامات کا استعمال کرتے ہوئے اپنے ماڈل کے نتائج کو چیک کریں۔
کلینیکل NLP ٹولز جیسے scispaCy پر ایک نظر ڈالیں۔ یاد رکھیں کہ میڈیکل ٹیکسٹ کے لیے بنائے گئے ٹولز کو ابھی بھی ان کاموں کے لیے جانچنے کی ضرورت ہے جن کے لیے وہ استعمال کرنا چاہتے ہیں۔
ایک Streamlit ایپ بنائیں جو لوگوں کو آپ کے پروجیکٹ کو ورچوئل مثالوں کے ساتھ آزمانے دیتی ہے۔
مزید جاننے کے لیے، spaCy دستاویزات، DistilBERT Sentiment Model Card، اور DistilRoBERTa Sentiment Model Card کو پڑھیں۔ اس کے علاوہ، تھراپسٹ اور کلائنٹ کے درمیان کام کرنے والے تعلقات کے بارے میں پس منظر کی معلومات کے لیے، ایڈورڈ ایس بورڈن کا 1979 کا مقالہ "ورکنگ الائنس کے نفسیاتی تصور کی عمومی قابلیت" پڑھیں۔
NLP متن کی بڑی مقدار کا مطالعہ کرنے میں مدد کرتا ہے۔ لیکن اسے ذمہ داری سے استعمال کرنے کا مطلب ہے ڈیٹا کو سمجھنا، یہ جاننا کہ ماڈل کو کیا کرنے کی تربیت دی گئی تھی، اور اس بارے میں واضح ہونا کہ نتائج ہمیں کیا نہیں بتاتے۔
اگر آپ پروجیکٹ کو قریب سے دیکھنا چاہتے ہیں تو GitHub ذخیرہ کو دیکھیں۔ میں نے یہاں کوڈ اور پروجیکٹ کا ڈھانچہ شامل کیا ہے تاکہ آپ دیکھ سکیں کہ یہ سب کیسے کام کرتا ہے۔ یہ ایک اچھا نقطہ آغاز بھی ہے اگر آپ جاننا چاہتے ہیں کہ Python اور NLP کا اطلاق صحت کی دیکھ بھال، میڈٹیک، کلینیکل NLP، اور AI جیسے شعبوں پر کیسے ہوتا ہے۔ اس جگہ میں ابھی بھی بہت کچھ دریافت کرنا باقی ہے، اور مجھے امید ہے کہ یہ پروجیکٹ آپ کو چیزوں کے لیے کچھ آئیڈیاز فراہم کرے گا۔
حوالہ جات
- بورڈین، ای ایس (1979)۔ کام کرنے والے اتحاد کے نفسیاتی تصور کی عامیت۔ سائیکو تھراپی: تھیوری، ریسرچ اور پریکٹس، 16(3)، 252-260۔ https://doi.org/10.1037/h0085885
- ہارٹ مین، جے (2022)۔ جذباتی انگریزی DitilRoBERTA پر مبنی. گلے لگنے والا چہرہ ماڈل ہب۔
- گلے لگانا چہرہ۔ (این ڈی) ایس ایس ٹی-2 پر کیس فائن ٹیون کیے بغیر DitilBERT بیس. گلے لگنے والا چہرہ ماڈل ہب۔
- گلے لگانا چہرہ۔ (این ڈی) ٹرانسفارمرز کی دستاویزات. https://huggingface.co/docs/transformers۔
- Matplotlib ترقیاتی ٹیم۔ (این ڈی) Matplotlib دستاویزات. https://matplotlib.org/stable/۔
- پانڈا (این ڈی) پانڈا دستاویزات. https://pandas.pydata.org/docs/۔
- pytest ترقیاتی ٹیم. (این ڈی) PyTest دستاویزات. https://docs.pytest.org/۔
- Sanh, V., Debut, L., Chaumond, J., & Wolf, T. (2019)۔ DistilBERT، BERT کا ڈسٹل ورژن: چھوٹا، تیز، سستا اور ہلکا۔. arXiv:1910.01108۔
- جاسوس (این ڈی) استعمال شدہ دستاویزی: لینگویج پروسیسنگ پائپ لائن. https://spacy.io/usage/processing-pipelines۔