
کچھ عرصہ پہلے، میں نے ایک مشین لرننگ ماڈل کو پبلک CDC ڈیٹاسیٹ سے پانچ کالم دیا اور اس سے کہا کہ وہ اسی فائل سے چھٹے کالم کی پیشین گوئی کرے۔ اس ماڈل کے لیے R² سکور 0.998 ہے، جو بالکل اتنا ہی قریب ہے جتنا ایک حقیقی ماڈل حاصل کر سکتا ہے۔
اسکور کامیاب لگ رہا تھا، لیکن ماڈل نے حقیقی دنیا کے بارے میں بہت کم سیکھا۔ CDC نے دوسرے 5 کالموں سے 6 ویں کالم کا حساب لگایا، لہذا ماڈل نے CDC کے فارمولے کو آسانی سے شمار کیا۔
ڈیٹا سائنسدان اسے ایک مسئلہ کہتے ہیں۔ ہدف لیکایسا اس وقت ہوتا ہے جب آپ ماڈل کو جو ان پٹ فراہم کرتے ہیں اس میں پہلے سے ہی کسی نہ کسی شکل میں جواب ہوتا ہے۔
اس طرح کی لیکس عوامی ڈیٹا میں آسانی سے چھپ جاتی ہیں کیونکہ اس کا زیادہ تر حصہ دوسرے عوامی ڈیٹا سے لیا جاتا ہے۔ سروے کالم سے گورنمنٹ انڈیکس بنایا جا سکتا ہے اور پہلے انڈیکس سے دوسرا انڈیکس بنایا جا سکتا ہے۔ ایجنسیاں ان طریقوں کو طریقہ کار پی ڈی ایف میں بیان کرتی ہیں، لیکن ڈیٹا کیٹلاگ انہیں کمپیوٹر کے پڑھنے کے قابل فارمیٹ میں شاذ و نادر ہی اسٹور کرتے ہیں۔
اس ٹیوٹوریل میں، ہم ایک چھوٹا Python ٹول بناتے ہیں جو ان ریکارڈز کو براہ راست لکھتا ہے اور پھر انہیں پڑھتا ہے۔ یہ ٹول پیکیج مینیجر کے اندر انحصار چیکر کی طرح کام کرتا ہے۔ یہ آپ کو بتاتا ہے کہ آپ کس چیز کی پیشن گوئی کرنا چاہتے ہیں، کون سے کالم استعمال کرنے ہیں، اور ہدف کے اخذ کرنے کے راستے میں کسی بھی کالم کو مسترد کرتا ہے۔
آخر میں، آپ کو معلوم ہو جائے گا کہ کیسے:
-
ہم لائیو سی ڈی سی ڈیٹا اور اسکیٹ لرن کا استعمال کرتے ہوئے حقیقی لیکس کو دوبارہ تیار کرتے ہیں۔
-
ایک چھوٹی YAML فائل جسے مینی فیسٹ کہا جاتا ہے اس کی وضاحت کرتی ہے کہ ڈیٹاسیٹ کس چیز سے بنایا گیا ہے۔
-
چوڑائی-پہلی تلاش اور گہرائی-پہلی تلاش کا استعمال کرتے ہوئے گراف کو دریافت کریں۔
-
ایک چیکنگ ٹول بنائیں جو ٹائپ کی غلطیوں، خراب فائلوں اور خالی ان پٹ کے لیے زور سے ناکام ہو جائے
-
GitHub ایکشنز کا استعمال کرتے ہوئے ہر پش کے ساتھ خود بخود چیک چلائیں۔
انڈیکس
شرطیں
پیروی کرنے کے لیے آپ کو ضرورت ہو گی:
-
Python 3.10 یا اس سے زیادہ
-
پانڈاس ڈیٹا فریم کیا ہے اس کا بنیادی خیال
-
ایک ٹرمینل جہاں آپ کمانڈ چلا سکتے ہیں۔
-
CDC ڈیٹا فائلوں کے لیے تقریباً 7 MB مفت ڈسک کی جگہ۔
اس کے اندر ورچوئل ماحول کے ساتھ ایک نیا پروجیکٹ فولڈر بنانا ان لائبریریوں کو باقی سسٹم سے الگ رکھے گا۔ پھر اس ٹیوٹوریل میں استعمال ہونے والی تین لائبریریاں انسٹال کریں۔
mkdir leak-tutorial
cd leak-tutorial
python3 -m venv .venv
source .venv/bin/activate
pip install pandas scikit-learn pyyaml
ونڈوز پر، چلائیں: .venvScriptsactivate اس کے بجائے source لائنیں اور اقسام python جہاں بھی یہ مضمون ہے۔ python3. اس ٹیوٹوریل میں تمام کمانڈز کو اندر سے چلائیں۔ leak-tutorial فولڈر
اس ٹیوٹوریل میں آپ جو فائلیں بناتے ہیں وہ بھی کمپینیئن ریپوزٹری، ڈیریوز سے ٹیوٹوریل میں ہیں، لہذا اگر آپ کو کوئی پریشانی ہو تو آپ اپنے کام کا موازنہ کر سکتے ہیں۔
ٹول کا مکمل ورژن عوامی GitHub ذخیرہ میں ہے، مضمون کے آخر میں ایک لنک کے ساتھ۔
کلیدی اصطلاحات سادہ انگریزی میں
یہاں پانچ الفاظ ہیں جو اس ٹیوٹوریل میں بار بار آتے ہیں:
-
ہدف: یہ وہ کالم ہے جس کی آپ ماڈل پیش گوئی کرنا چاہتے ہیں۔
-
Covariates: یہ وہ کالم ہیں جنہیں آپ اپنے اہداف کی پیشن گوئی کرنے میں مدد کرنے کے لیے ماڈل میں فیڈ کرتے ہیں (بہت سے لوگ ان افعال کو کہتے ہیں)۔
-
R² (R مربع): ایک اسکور جو آپ کو بتاتا ہے کہ ماڈل کی پیشین گوئیاں اصل قدروں سے کتنی قریب سے ملتی ہیں۔ 1.0 کے اسکور کا مطلب ایک مکمل میچ ہے، جبکہ 0 کے قریب سکور کا مطلب ہے کہ ماڈل بہت کم وضاحت کرتا ہے۔
-
مردم شماری کا علاقہ: ریاستہائے متحدہ میں ایک چھوٹا سا علاقہ جس میں عام طور پر تقریباً 4,000 لوگ رہتے ہیں، تقریباً ایک محلے کے سائز کے۔
-
کراس توثیق: یہ آپ کے ماڈل کو جانچنے کا ایک منصفانہ طریقہ ہے۔ ڈیٹا کو 5 حصوں میں تقسیم کریں، 4 حصوں کو تربیت دیں، 5ویں حصے کی جانچ کریں، اور اس وقت تک دہرائیں جب تک کہ تمام حصے ٹیسٹ سیٹ میں تبدیل نہ ہوجائیں۔
مرحلہ 1: خود لیک کی جانچ کریں۔
یو ایس سینٹرز فار ڈیزیز کنٹرول اینڈ پریونشن (سی ڈی سی) کے ذریعہ اعلان کیا گیا سماجی کمزوری انڈیکسیا SVI. ہنگامی منصوبہ ساز اس معلومات کو ان کمیونٹیز کی نشاندہی کرنے کے لیے استعمال کرتے ہیں جنہیں سیلاب، گرمی کی لہروں، یا بیماری کے پھیلنے کے دوران اضافی مدد کی ضرورت ہو سکتی ہے۔
CDC تہوں میں SVIs بناتا ہے۔ یہ امریکن کمیونٹی سروے (ACS) کے 16 کالموں کے ساتھ شروع ہوتا ہے، یہ ایک بڑا سروے ہے جسے امریکی مردم شماری بیورو چلاتا ہے۔ ہر کالم ایک فیصد ہے، جیسے غربت میں لوگوں کا فیصد یا بغیر گاڑی والے گھرانوں کا فیصد۔
CDC 16 کالموں کو چار عنوانات میں گروپ کرتا ہے اور ہر عنوان کے اندر تمام مردم شماری کے راستوں کی درجہ بندی کرتا ہے۔ پھر ہم چار تھیم کی درجہ بندی کو ایک مجموعی درجہ بندی میں یکجا کرتے ہیں۔ RPL_THEMES.
CDC SVI کیسے بناتا ہے: 16 ACS سروے کالم چار موضوعاتی درجہ بندی فراہم کرتے ہیں، اور چار موضوعاتی درجہ بندی ایک مجموعی درجہ بندی فراہم کرتی ہے۔ ہر پیلے رنگ کے باکس کو اس کے نیچے والے باکس سے شمار کیا جاتا ہے۔
اس ٹیوٹوریل میں اہم تفصیلات میں شامل ہیں: CDC ایک ہی CSV فائل میں خام ACS کالم اور مکمل درجہ بندی فراہم کرتا ہے۔ لہذا دونوں کو پکڑ کر ایک ماڈل میں ڈالنا بہت آسان ہے۔
کیلیفورنیا فائل ڈاؤن لوڈ کریں:
curl -L -o California.csv https://svi.cdc.gov/Documents/Data/2022/csv/states/California.csv
میں استعمال کرتا ہوں curl اس کی وجہ یہ ہے کہ میک او ایس پر پائیتھون کی کچھ تنصیبات فائلوں کو براہ راست ڈاؤن لوڈ کرتے وقت ویب سائٹ کے سیکیورٹی سرٹیفکیٹ کی تصدیق نہیں کرتی ہیں۔
اب درج ذیل فائلیں بنائیں: leak_demo.py:
"""leak_demo.py: predict a published index from the columns it was built from."""
import pandas as pd
from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.model_selection import KFold, cross_val_score

# CDC marks missing values as -999, so turn those into proper blanks.
df = pd.read_csv("California.csv", low_memory=False).replace(-999, float("nan"))


def score(inputs, target):
    data = df[inputs + [target]].dropna()
    model = HistGradientBoostingRegressor(random_state=0)
    folds = KFold(n_splits=5, shuffle=True, random_state=0)
    r2 = cross_val_score(model, data[inputs], data[target],
                         cv=folds, scoring="r2").mean()
    print(f"{target:<11} from {len(inputs)} column(s)  "
          f"tracts={len(data)}  R2 = {r2:.3f}")


# Theme 1 is built from exactly these five columns.
score(["EP_POV150", "EP_UNEMP", "EP_HBURD", "EP_NOHSDP", "EP_UNINSUR"],
      "RPL_THEME1")

# EP_NOINT ships in the same file, and CDC leaves it out of the index.
score(["EP_NOINT"], "RPL_THEMES")
اسکرپٹ کی خصوصیات میں شامل ہیں:
-
CSV لوڈ کریں اور CDC کو تبدیل کریں۔
-999CDC مارکر کو خالی اقدار میں تبدیل کرتا ہے۔-999پرچم غائب اقدار۔ -
کہ
scoreیہ فنکشن نمبروں کے ٹیبل پر ایک طاقتور اور وسیع پیمانے پر استعمال ہونے والے گریڈینٹ بوسٹنگ ماڈل کو تربیت دیتا ہے اور R² کو 5 گنا کراس توثیق کے ذریعے ماپتا ہے۔ -
پہلی کال تھیم 1 کی تعمیر کے لیے استعمال ہونے والے CDC کے عین 5 کالموں کا استعمال کرتے ہوئے تھیم 1 کی پیش گوئی کرتی ہے۔
-
دوسری کال اس کا استعمال کرتے ہوئے مجموعی درجہ کی پیش گوئی کرتی ہے:
EP_NOINTبراڈ بینڈ انٹرنیٹ سبسکرپشن سے محروم گھرانوں کا فیصد۔ CDC اس کالم کو اسی فائل میں شامل کرتا ہے اور اسے انڈیکس سے خارج کرتا ہے۔
چلائیں:
python3 leak_demo.py

کی پیداوار leak_demo.py. تھیم 1 کی پیش گوئی سی ڈی سی کے ذریعہ بنائے گئے پانچ کالموں سے کی گئی تھی اور اس کا اسکور R² = 0.998 ہے۔ انڈیکس سے خارج کردہ کالموں سے CDC کی طرف سے پیش گوئی کی گئی مجموعی درجہ بندی 0.384 ہے۔
پہلا سکور 0.998 تھا، جس کا مطلب ہے کہ ماڈل نے CDC کے تھیم 1 کو تقریباً بالکل ٹھیک کر دیا۔ سی ڈی سی کا فارمولا ایک مقررہ نسخہ ہے اور ماڈل میں تمام اجزاء شامل ہیں۔
دوسرا سکور 0.384 ہے۔ EP_NOINT فائل کے انڈیکس کے ساتھ واقع، اس کا سکور دو متعلقہ اقدامات کے درمیان مخصوص لنک سائز کی نشاندہی کرتا ہے۔
اب سماجی کمزوری کی پیشین گوئی کرنے کے لیے R² = 0.998 رپورٹ کرنے والے کاغذ کا تصور کریں۔ یہ تعداد شاید اہم معلوم ہو، لیکن وہ صرف یہ ظاہر کرتے ہیں کہ ماڈل نے سی ڈی سی کا راستہ تلاش کر لیا ہے۔
اس آرٹیکل میں اسکورز scikit-learn 1.8.0 سے ہیں۔ scikit-learn 1.3.2 سے 1.9.0 تک، تین اعشاریہ ایک جیسے رہتے ہیں، اس لیے آپ کے رنز ملنا چاہیے۔
مرحلہ 2: سمجھیں کہ عوامی ڈیٹا کیوں لیک ہوتا ہے۔
SVI مثالیں تلاش کرنا آسان ہے کیونکہ ان پٹ اور انڈیکس ایک فائل میں ہیں۔ زیادہ تر حقیقی دنیا کے معاملات زیادہ مشکل ہیں کیونکہ یہ سلسلہ متعدد اداروں میں چلتا ہے۔
یہاں ایک حقیقی سلسلہ ہے جو تین تنظیموں کو عبور کرتا ہے: FEMA کے نیشنل رسک انڈیکس (NRI) میں سماجی کمزوری کا سکور شامل ہے۔ FEMA کی تکنیکی دستاویز (ورژن 1.20، دسمبر 2025) کے مطابق، یہ اسکور مردم شماری بیورو کے کمیونٹی لچک کے تخمینے سے آتے ہیں۔ مردم شماری بیورو یہ تخمینہ ACS سروے کے ڈیٹا کی بنیاد پر کرتا ہے۔
لہذا، FEMA کے خطرے کے اسکور اور ACS کالم ایک سلسلہ کے دونوں سرے پر ہو سکتے ہیں، حالانکہ وہ مختلف ایجنسیوں اور ویب سائٹس سے آتے ہیں۔
یہ جاننے کے لیے کہ کمپیوٹر اس سے کیوں محروم رہتے ہیں، آپ کو ان دو قسم کے ریکارڈز کے بارے میں جاننا ہوگا جو نمبرز کے پاس ہوسکتے ہیں۔
-
پیدائش سوال کا جواب دیتے ہوئے، "یہ نمبر کہاں سے آیا؟" مثال کے طور پر، اقدار اس سے آتی ہیں:
California.csvاس سے آتا ہے:svi.cdc.gov. -
شامل کرنا اس سوال کا جواب دیتے ہوئے کہ "ان نمبروں کو کس چیز سے شمار کیا گیا؟" مثال کے طور پر، تھیم 1 کا حساب پانچ ACS کالموں سے کیا گیا تھا۔

نمبروں میں دو طرح کے ریکارڈ ہو سکتے ہیں: بائیں طرف کے ذرائع ان فائلوں اور ویب سائٹس کو ریکارڈ کرتے ہیں جہاں سے قدریں آئیں۔ دائیں طرف کا اخذ پانچ ACS کالموں کو ریکارڈ کرتا ہے جن کے لیے ٹاپک 1 کا حساب لگایا گیا تھا۔
زیادہ تر ڈیٹا کیٹلاگ پرووننس کو ذخیرہ کرنے کا ایک اچھا کام کرتے ہیں، گوگل کا ڈیٹا کامنز ایک اچھی مثال ہے۔ ہم اصل کو "درآمد کی جسمانی اکائی" کے طور پر بیان کرتے ہیں، جو ہمیں بتاتا ہے کہ فائل نمبر کہاں سے آیا ہے۔ ماخوذ عام طور پر صرف پی ڈی ایف طریقہ کار کے دستاویزات میں موجود ہوتے ہیں جو انسانوں کے لیے لکھے گئے ہیں۔
لہذا، جب ایک خودکار پائپ لائن مفید کوواریٹس تلاش کرتی ہے، تو یہ کالم جمع کر سکتی ہے جہاں ہدف لکھا گیا ہے۔ پائپ لائن اعلی اسکور کی جانچ کرتی ہے اور متعلقہ کالم کو برقرار رکھتی ہے۔
مرحلہ 3: پیکیج مینیجر سے آئیڈیاز لیں۔
سافٹ ویئر ڈویلپرز نے بہت پہلے اسی طرح کا مسئلہ حل کیا تھا۔
جب آپ بھاگتے ہیں pip install requestspip کس چیز کی فہرست پڑھتا ہے۔ requests پیکجوں پر منحصر ہے کہ کس چیز پر منحصر ہے، اور اسی طرح درخت کے نیچے. چونکہ تمام انحصار لاگ ان ہیں، pip کسی بھی چیز کو انسٹال کرنے سے پہلے درخت میں کہیں بھی مسائل تلاش کر سکتا ہے۔
نیچے دیا گیا خاکہ اس درخت کو اسی مسئلے کے ڈیٹا ورژن کے ساتھ رکھتا ہے۔

ایک ہی شکل دو بار ظاہر ہوتی ہے۔ بائیں طرف پائپ کا انحصار درخت ہے۔ urllib3 اور certifi کھانا کھلانا requestsکھانا کھلانا my-app. دائیں طرف ڈیٹا ورژن ہے۔ ACS.EP_UNEMP پیشن گوئی کا ماڈل درج کریں۔ FEMA_NRI.risk_scoreایک ہی کالم دیگر دو مصنوعات سے گزرتا ہے اور متعلقہ رسک سکور تک جاتا ہے۔
عوامی ڈیٹا کو اسی قسم کے ریکارڈ کی ضرورت ہوتی ہے۔ اوپر دیے گئے خاکے کے دائیں نصف میں، ACS.EP_UNEMP (بے روزگاری کی شرح) کو ماڈل میں کوواریٹ کے طور پر درج کیا گیا ہے۔ ایک ہی ستون دو مختلف مصنوعات سے گزرتا ہے۔ FEMA_NRI.risk_scoreیہ مقصد ہے۔ کالم لوپ کے دونوں سروں پر واقع ہیں۔
کمپیوٹر سائنس میں اس قسم کا خاکہ ہے۔ گراف. ہر باکس لفظہر تیر کنارے. ڈیٹا گراف میں تیروں کی پیروی کرنا ہمیشہ نقطہ آغاز سے اوپر کی طرف بڑھتا ہے، لہذا گراف اس طرح لگتا ہے: ڈائریکٹڈ Acyclic گرافمختصراً ڈی اے جی۔ "Acyclic" کا مطلب ہے کہ تیر ایک صفر لوپ بناتے ہیں۔
اس پورے مضمون میں، تمام تیر ایک جزو سے اس جزو کے ساتھ تیار کردہ مصنوعات کی طرف اشارہ کرتے ہیں۔
دو خاندانی الفاظ گراف پر مقامات کو بیان کرنے میں مدد کرتے ہیں۔
-
نہیں اجداد نوڈ وہ چیز ہے جس تک کسی بھی فاصلے سے پیچھے کی طرف تیر کی پیروی کرکے پہنچا جا سکتا ہے۔ ACS بخار SVI کا آباؤ اجداد ہے۔
-
کوئی راستہ نہیں اولاد نوڈ وہ چیز ہے جس تک تیر کے ساتھ آگے بڑھ کر پہنچا جا سکتا ہے۔ SVI ACS کالم کا بچہ ہے۔
پھر لیک ٹیسٹنگ ایک سادہ اصول بن جاتا ہے۔ یعنی، تمام ہم خیال افراد کو موضوع کے والدین اور بچوں سے انحراف کرنا چاہیے۔
مرحلہ 4: انحصاری مینی فیسٹ لکھیں۔
مینی فیسٹ ایک فائل ہے جو تمام پروڈکٹس اور ہر پروڈکٹ کے اجزاء کی فہرست دیتی ہے۔ ہم یہاں YAML استعمال کریں گے کیونکہ لوگوں کے لیے پڑھنا اور ترمیم کرنا آسان ہے۔
ماپا مصنوعات اس طرح لگتا ہے:
ACS.EP_UNEMP:
  label: Unemployment rate
  measurementBasis: measured
  derivesFrom: []
خالی فہرست derivesFrom: [] چونکہ یہ پروڈکٹ براہ راست ایک سروے سے آتا ہے، ہم اعلی درجہ بندی کو ریکارڈ نہیں کرتے ہیں۔
یہاں مختلف مصنوعات سے تیار کردہ کچھ مصنوعات ہیں:
FEMA_NRI.social_vulnerability:
  label: FEMA National Risk Index, social vulnerability
  measurementBasis: composite
  derivesFrom:
    - {variable: CENSUS_CRE.social_vulnerability, relation: identity, confidence: documented}
ہر ایک شے ہے۔ derivesFrom گراف کا ایک کنارہ ہے، اور ہر کنارے کے تین حقائق ہیں:
-
variableاس میں بنیادی پروڈکٹ کا نام ہوتا ہے، اور یہ نام فائل میں کہیں اور بیان کردہ پروڈکٹ سے مماثل ہونا چاہیے۔ -
relationوضاحت کرتا ہے کہ والدین کو کس طرح استعمال کیا جاتا ہے۔ -
confidenceلکھیں کہ آپ کنارے کے بارے میں کتنے پر اعتماد ہیں۔
پانچ رشتے یہ ہیں:
| رشتہ | معنی |
|---|---|
component |
والدین ایک ریاضیاتی عنصر ہے جو رقم میں ایک عدد کے برابر ہے۔ |
modelled_from |
والدین شماریاتی ماڈل میں ان پٹ تھے۔ |
identity |
پروڈکٹ بنیادی پروڈکٹ ہے اور اسے نئے نام کے ساتھ دوبارہ شائع کیا جائے گا۔ |
poststratified_on |
والدین نے آبادی کا وزن فراہم کیا۔ |
denominator |
والدین کسر کے سب سے نیچے نمبر ہیں، جیسا کہ "فی کس کیسز" میں آبادی ہے۔ |
اعتماد کی تین سطحیں ہیں:
| ایمان | معنی |
|---|---|
certain |
فارمولے شائع کیے جاتے ہیں یا ان پٹ اور آؤٹ پٹ ایک فائل میں ایک ساتھ فراہم کیے جاتے ہیں۔ |
documented |
ادارہ اپنے طریقہ کار کی دستاویز میں لنک کی وضاحت کرے گا۔ |
inferred |
دستاویز سختی سے ایک لنک تجویز کرتی ہے، لہذا اسے عارضی سمجھیں۔ |
اعتماد کا میدان اس سے کہیں زیادہ اہم ہے جتنا یہ پہلے ظاہر ہوتا ہے۔ اندازوں سے بھرا ایک شجرہ نسب کا گراف اسی مسئلے کو دوبارہ پیش کرتا ہے جسے آپ حل کرنے کی کوشش کر رہے ہیں، لہذا ہر کنارے کو آپ کو بتانا چاہیے کہ اس کے پیچھے کتنے ثبوت ہیں۔
ہر ایک پروڈکٹ بھی ہے۔ measurementBasis:
| پیمائش کا معیار | معنی |
|---|---|
measured |
براہ راست شمار یا سروے، جیسے مردم شماری۔ |
modelled |
شماریاتی یا مشین لرننگ ماڈلز سے تیار کردہ |
composite |
دیگر مصنوعات کے فکسڈ آپریشنز کے ساتھ حساب لگائیں۔ |
یہ فیلڈ ایسی چیز کو ریکارڈ کرتی ہے جسے عام طور پر عوامی کیٹلاگ سے خارج کر دیا جاتا ہے: چاہے نمبر کا حساب لگایا گیا ہو یا پیشین گوئی کی گئی ہو۔ مردم شماری کی گنتی اور جنگل کی بے ترتیب پیشین گوئیاں اسپریڈ شیٹ میں ایک جیسی نظر آتی ہیں، لیکن یہ بہت مختلف قسم کے ثبوت ہیں۔
ابھی بنائیں mini-manifest.yaml ذیل کے مواد کے لیے۔ یہ مکمل مینی فیسٹ کا ایک چھوٹا حصہ ہے، جس میں اصل امریکی ڈیٹا انفراسٹرکچر سے 11 پروڈکٹس شامل ہیں۔ ہر ٹکڑا اپنے اصلی کناروں میں سے کچھ کو برقرار رکھتا ہے، لہذا آپ کے ڈھیر چھوٹے رہتے ہیں۔
# A small slice of derivation-manifest.yaml, used in the tutorial.
schema: derives-from/0.2

products:

  # ---- measured: counted or surveyed directly
  ACS.EP_POV150:
    label: Population below 150% of the poverty line
    measurementBasis: measured
    derivesFrom: []

  ACS.EP_UNEMP:
    label: Unemployment rate
    measurementBasis: measured
    derivesFrom: []

  ACS.EP_NOVEH:
    label: Households with zero vehicles
    measurementBasis: measured
    derivesFrom: []

  SAT.chirps_rainfall:
    label: CHIRPS satellite rainfall
    measurementBasis: measured
    derivesFrom: []

  NVSS.mortality:
    label: Death certificate records
    measurementBasis: measured
    derivesFrom: []

  # ---- built from other products
  CENSUS_CRE.social_vulnerability:
    label: Census Community Resilience Estimates, social vulnerability
    measurementBasis: modelled
    derivesFrom:
      - {variable: ACS.EP_POV150, relation: modelled_from, confidence: documented}
      - {variable: ACS.EP_UNEMP,  relation: modelled_from, confidence: documented}
      - {variable: ACS.EP_NOVEH,  relation: modelled_from, confidence: documented}

  FEMA_NRI.social_vulnerability:
    label: FEMA National Risk Index, social vulnerability
    measurementBasis: composite
    derivesFrom:
      - {variable: CENSUS_CRE.social_vulnerability, relation: identity, confidence: documented}

  HVRI.bric:
    label: Baseline Resilience Indicators for Communities
    measurementBasis: composite
    derivesFrom:
      - {variable: ACS.EP_UNEMP, relation: component, confidence: documented}
      - {variable: ACS.EP_NOVEH, relation: component, confidence: documented}

  FEMA_NRI.community_resilience:
    label: FEMA National Risk Index, community resilience
    measurementBasis: composite
    derivesFrom:
      - {variable: HVRI.bric, relation: identity, confidence: documented}

  FEMA_NRI.expected_annual_loss:
    label: FEMA National Risk Index, expected annual loss
    measurementBasis: modelled
    derivesFrom: []

  FEMA_NRI.risk_score:
    label: FEMA National Risk Index, overall risk score
    measurementBasis: composite
    derivesFrom:
      - {variable: FEMA_NRI.expected_annual_loss, relation: component, confidence: certain}
      - {variable: FEMA_NRI.social_vulnerability, relation: component, confidence: certain}
      - {variable: FEMA_NRI.community_resilience, relation: component, confidence: certain}
مرحلہ 5: لنٹر بنانا
کوئی راستہ نہیں لنٹر یہ ایک ایسا ٹول ہے جو کچھ پڑھتا ہے اور نقصان پہنچانے سے پہلے آپ کو مسائل سے آگاہ کرتا ہے۔ جب کہ فلیک 8 جیسے کوڈ لنٹر سورس کوڈ کو پڑھتے ہیں، یہ لنٹر مینی فیسٹس اور ہم آہنگی کی فہرستوں کو پڑھتا ہے۔
نامی ایک فائل بنائیں mini_lint.py. یہ چھ حصوں پر مشتمل ہے اور تیار فائل کو 200 لائنوں سے کم رکھا جائے گا۔
حصہ 1: YAML لوڈ کرنا اور ڈپلیکیٹ کیز کو مسترد کرنا
"""mini_lint.py: refuse covariates that sit on a derivation path to or from the target."""
import argparse
import sys
from collections import deque
from itertools import combinations

import yaml

RANK = {"certain": 3, "documented": 2, "inferred": 1}
DETERMINISTIC = {"component", "identity", "denominator"}


def fail(message):
    """Exit code 2 means the manifest or the command itself is broken."""
    print(message, file=sys.stderr)
    sys.exit(2)


# ---------------------------------------------------------------- step 1
class StrictLoader(yaml.SafeLoader):
    """A YAML loader that stops on a repeated key."""


def refuse_duplicates(loader, node, deep=False):
    seen = {}
    for key_node, _ in node.value:
        key = loader.construct_object(key_node, deep=deep)
        line = key_node.start_mark.line + 1
        if key in seen:
            fail(f"manifest error: key {key!r} appears twice "
                 f"(line {seen[key]} and line {line})")
        seen[key] = line
    return loader.construct_mapping(node, deep=deep)


StrictLoader.add_constructor(
    yaml.resolver.BaseResolver.DEFAULT_MAPPING_TAG, refuse_duplicates)
RANK یہ اعتماد کے الفاظ کو نمبروں میں تبدیل کرتا ہے، جس سے ٹول راستے میں کمزور ترین کناروں کو تلاش کر سکتا ہے۔ DETERMINISTIC مکمل طور پر ریاضی کے تعلقات کی فہرست۔
fail ایک پیغام پرنٹ کرتا ہے اور کوڈ 2 کے ساتھ باہر نکلتا ہے۔ بعد میں ٹیوٹوریل میں آپ دیکھیں گے کہ کوڈ 2 کو کوڈ 1 سے الگ کرنے کی ضرورت کیوں ہے۔
لوڈر کچھ ڈرپوک YAML سلوک کو سنبھالتا ہے۔ اگر ایک ہی بلاک میں ایک کلید دو بار ظاہر ہوتی ہے تو، PyYAML خاموشی سے آخری کاپی رکھتا ہے اور پہلی کاپی کو رد کر دیتا ہے۔ آپ مینی فیسٹ میں پروڈکٹ کے تمام کناروں کو مٹا سکتے ہیں اور ٹول دیکھے گا کہ کوئی راستہ نہیں ہے اور خوشی سے کسی بھی لیک شدہ کوویریٹس کو مٹا دے گا۔
refuse_duplicates جب بھی PyYAML میپنگ (Python ڈکشنری) بناتا ہے تو چلتا ہے۔ یہ چابیاں دیکھتا ہے، ہر کلید کے لیے لائن نمبر یاد رکھتا ہے، اور جیسے ہی کوئی کلید دہرائی جاتی ہے پروگرام کو روک دیتا ہے۔
حصہ 2: پروڈکٹس اور ایج پڑھیں
# ---------------------------------------------------------------- step 2
def load(path):
    try:
        with open(path) as fh:
            products = yaml.load(fh, StrictLoader)["products"]
    except (OSError, yaml.YAMLError, KeyError, TypeError) as e:
        fail(f"manifest error: unable to read {path}: {e}")

    edges = {}
    for name, product in products.items():
        edges[name] = []
        for e in product.get("derivesFrom") or []:
            if RANK.get(e.get("confidence")) is None:
                fail(f"manifest error: {name} has an edge with "
                     f"confidence {e.get('confidence')!r}")
            edges[name].append((e["variable"], e["relation"], e["confidence"]))
    return products, edges
load فائل کو سخت لوڈر کے ساتھ کھولیں۔ اگر پڑھتے وقت کچھ غلط ہو جاتا ہے، جیسے غلط راستہ یا خراب YAML، میں کال کرتا ہوں: fail.
پھر ہم اس طرح ایک لغت بناتے ہیں: edges. ہر پروڈکٹ کے نام کی فہرست کو محفوظ کریں۔ (parent, relation, confidence) ٹوپل مثال کے طور پر:
edges["FEMA_NRI.social_vulnerability"]
# [("CENSUS_CRE.social_vulnerability", "identity", "documented")]
یہ اس بات کو بھی یقینی بناتا ہے کہ تمام اعتماد کی قدریں اجازت یافتہ تین الفاظ میں سے ایک ہیں۔ ٹائپ کی غلطیاں درج ذیل ہیں: documneted بصورت دیگر، آپ پھسل جائیں گے اور بعد میں اپنی درجہ بندی کو توڑ دیں گے۔
حصہ 3: اپنے مینی فیسٹ پر بھروسہ کرنے سے پہلے اسے چیک کریں۔
# ---------------------------------------------------------------- step 3
def undefined_names(products, edges):
    mentioned = {parent for rows in edges.values() for parent, _, _ in rows}
    return sorted(mentioned - set(products))


def find_cycle(edges):
    state = {}

    def visit(node, stack):
        state[node] = "open"
        stack.append(node)
        for parent, _, _ in edges.get(node, []):
            if state.get(parent) == "open":
                return stack[stack.index(parent):] + [parent]
            if parent in state:
                continue
            cycle = visit(parent, stack)
            if cycle:
                return cycle
        stack.pop()
        state[node] = "closed"
        return None

    for node in edges:
        if node in state:
            continue
        cycle = visit(node, [])
        if cycle:
            return cycle
    return None
والدین کے ناموں میں ٹائپوز جیسے: HVRI.brick اس کے بجائے HVRI.bricایک کنارے بناتا ہے جو اس پروڈکٹ کی طرف اشارہ کرتا ہے جو فائل میں نہیں ہے۔ ٹراورسل ایک ڈیڈ اینڈ پر رک جائے گا اور اس سے آگے کے تمام کوواریٹس محفوظ دکھائی دیں گے۔
undefined_names ہر کنارے سے، ہم تمام متذکرہ والدین کو جمع کرتے ہیں اور مصنوعات کے ایک متعین سیٹ کو گھٹاتے ہیں۔ جو کچھ رہ گیا ہے وہ ٹائپ کی غلطیاں یا پروڈکٹس ہیں جنہیں آپ شامل کرنا بھول گئے ہیں۔
find_cycle یقینی بنائیں کہ آپ کا مینی فیسٹ دراصل ایک DAG ہے۔ حقیقی اعداد و شمار پر گھریلو مصنوعات ناممکن ہو گی اور لوپ ہمیشہ کے لیے ایک دائرے میں راستہ تلاش کر دے گا۔
فنکشن استعمال کرتا ہے: گہرائی سے پہلی تلاش دو لیبل ہیں۔ جب تلاش کسی نوڈ میں داخل ہوتی ہے، تو یہ اس نوڈ کو دکھاتا ہے۔ open. ایک نوڈ کو نشان زد کرتا ہے جب اس کے اوپر کی تمام اشیاء کی کھوج کی گئی ہو۔ closed. جب کوئی نوڈ پہنچ جاتا ہے جہاں تلاش ابھی جاری ہے۔ openآپ ایک دائرے میں چلے گئے اور فنکشن اس دائرے کو لوٹاتا ہے تاکہ آپ اسے دیکھ سکیں۔
حصہ 4: گراف کی تلاش
# ---------------------------------------------------------------- step 4
def ancestors(edges, node):
    """Every product that `node` was built from, at any distance."""
    found = set()
    queue = deque([node])
    while queue:
        current = queue.popleft()
        for parent, _, _ in edges.get(current, []):
            if parent in found:
                continue
            found.add(parent)
            queue.append(parent)
    return found


def routes(edges, start, goal):
    """Every path from start up to goal. Safe because step 3 ruled out cycles."""
    found = []
    for parent, relation, confidence in edges.get(start, []):
        step = (parent, relation, confidence)
        if parent == goal:
            found.append([step])
        else:
            for rest in routes(edges, parent, goal):
                found.append([step] + rest)
    return found


def describe(start, route):
    chain = " -> ".join([start] + [parent for parent, _, _ in route])
    weakest = min(route, key=lambda step: RANK[step[2]])[2]
    arithmetic = all(rel in DETERMINISTIC for _, rel, _ in route)
    kind = "deterministic" if arithmetic else "statistical"
    return [chain, f"{kind}, weakest link: {weakest}"]
ancestors استعمال کریں چوڑائی پہلی تلاش (BFS) ٹکٹ آفس میں قطار کا تصور کریں۔ لانچ پروڈکٹ کو قطار میں لگائیں۔ ہر موڑ پر، یہ سامنے سے پروڈکٹ لیتا ہے، اس کے والدین کو تلاش کرتا ہے، اور پھر ہر اس والدین کو شامل کرتا ہے جسے اس نے ابھی تک قطار کے پچھلے حصے میں نہیں دیکھا ہے۔ اگر قطار خالی ہے۔ found سیٹ تمام فاصلوں پر تمام آباؤ اجداد کو رکھتا ہے۔
کہ found سیٹ تلاشوں کو ایک ہی پروڈکٹ کو دو بار دیکھنے سے بھی روکتا ہے۔ یہ اہم ہے کیونکہ بہت سے پروڈکٹس پیرنٹ پروڈکٹ کا اشتراک کرتے ہیں۔
ancestors یہ آپ کو بتاتا ہے کہ آیا کوویریٹ اپ اسٹریم ہے۔ routes یہ آپ کو بتاتا ہے کہ وہاں کیسے جانا ہے۔
routes تکرار کے ساتھ گہرائی سے پہلے تلاش کا استعمال کریں۔ ہر والدین کے لیے startیقینی بنائیں کہ والدین ہدف ہیں۔ پھر وہ واحد قدم ایک مکمل راستہ ہے۔ بصورت دیگر، فنکشن والدین سے مقصد تک تمام راستے تلاش کرنے کے لیے خود کو کال کرتا ہے، پھر موجودہ قدم کو ہر قدم کے سامنے رکھتا ہے۔
یہ فنکشن تمام راستے واپس کرتا ہے۔ یہ انتخاب جان بوجھ کر کیا گیا ہے۔ میرے مکمل ٹول کے پچھلے ورژن میں صرف مختصر ترین راستے کی اطلاع دی گئی تھی، اس لیے رپورٹ نے سب سے کم ہاپس کے ساتھ راستہ دکھایا، یہاں تک کہ جب طویل راستے کے لیے مضبوط ثبوت موجود تھے۔
یہاں تکرار محفوظ ہے کیونکہ ہم پہلے ہی حصہ 3 میں دیکھ چکے ہیں کہ گراف ڈی اے جی ہے۔
describe راستے کو دو پڑھنے کے قابل لائنوں میں تبدیل کریں۔ پہلی سطر ناموں کا سلسلہ ہے۔ دوسری لائن اشارہ کرتی ہے کہ آیا راستہ ہے: deterministic (ہر قدم پر ریاضی) یا statistical (زنجیر میں ایک یا ایک سے زیادہ ماڈلز)، چونکہ ایک سلسلہ صرف اتنا ہی مضبوط ہوتا ہے جتنا اس کی کمزور ترین کڑی، اس لیے ہم راستے میں اعتماد کی کمزور ترین سطح کی وضاحت کرتے ہیں۔
حصہ 5: شکرگزار
آڈٹ گراف میں تین شکلیں تلاش کرتا ہے۔

ہر پینل ایک شکل دکھاتا ہے اور اس سے کیا گیا فیصلہ۔ یعنی، ہدف کی طرف ایک تیر (FAIL)، ہدف سے دور ایک تیر (FAIL)، اور ایک مشترکہ ان پٹ (REVIEW) پر دو کوواریٹس لٹک رہے ہیں۔
-
اجداد: Covariates یا تو براہ راست یا دیگر مصنوعات کے ذریعے ہدف میں داخل ہوئے۔ یہ ایک کلاسک لیک ہے، لہذا ٹول اسے غلطی کے طور پر رپورٹ کرتا ہے۔
-
ذیلی عنوانات: اہداف کوویریٹس کے طور پر شامل کیا گیا تھا۔ والدین کو اپنے بچوں سے پیشین گوئی کرنا اتنا ہی سنگین لیک ہے، اس لیے یہ بھی ایک غلطی ہے۔
-
مشترکہ آباؤ اجداد: دونوں covariates ایک ہی ان پٹ سے آئے ہیں۔ یہ ایک ہلکا مسئلہ ہے، کیونکہ جوڑا اوور لیپنگ معلومات رکھتا ہے اور ٹول انسانی جائزے کو الرٹ کرتا ہے۔
# ---------------------------------------------------------------- step 5
def audit(products, edges, target, covariates):
    findings = []

    unknown = [n for n in [target, *covariates] if products.get(n) is None]
    if unknown:
        return [("ERROR", f"unknown name: {n}", ["check the spelling"])
                for n in unknown]

    target_ancestors = ancestors(edges, target)
    for cov in covariates:
        if cov in target_ancestors:
            found = routes(edges, target, cov)
            details = [line for r in found for line in describe(target, r)]
            findings.append(("ERROR", f"{cov} is an ancestor of the target "
                                      f"({len(found)} route(s))", details))
        if target in ancestors(edges, cov):
            found = routes(edges, cov, target)
            details = [line for r in found for line in describe(cov, r)]
            findings.append(("ERROR", f"{cov} is a descendant of the target "
                                      f"({len(found)} route(s))", details))

    for a, b in combinations(covariates, 2):
        if a in ancestors(edges, b) or b in ancestors(edges, a):
            findings.append(("ERROR", f"{a} and {b}: one is built from the other", []))
        elif ancestors(edges, a) & ancestors(edges, b):
            shared = sorted(ancestors(edges, a) & ancestors(edges, b))
            findings.append(("WARN", f"{a} and {b} share ancestors", shared))
    return findings
آڈٹ نام کے حل سے شروع ہوتا ہے۔ اگر آپ کوویریٹ کی غلط ہجے کرتے ہیں، تو ٹول فوری طور پر غلطی کی اطلاع دیتا ہے۔ اس کی وجہ یہ ہے کہ ہمارے پاس مینی فیسٹ سے باہر کے نام کے بارے میں قطعی طور پر کوئی معلومات نہیں ہیں، اور اس نام کو محفوظ کہنا ایک اندازہ ہے۔
اس کے بعد، ہم ایک بار مضمون کے آباؤ اجداد کا حساب لگاتے ہیں اور ہر ایک کوویریٹ کو اس سیٹ کے خلاف جانچتے ہیں۔ یہ ہر ایک کوویریٹ کے آباؤ اجداد کا بھی حساب لگاتا ہے تاکہ یہ دیکھیں کہ آیا موضوع ان کے درمیان ظاہر ہوتا ہے، اور اس طرح یہ اولاد کو پکڑتا ہے۔
آخر کار combinations پر itertools ماڈیول تمام کوویریٹ جوڑے تیار کرتا ہے۔ یہ ایک غلطی ہے اگر ایک کوویریٹ دوسرے کوویریٹ سے بنایا گیا ہے۔ اگر جوڑا کسی اجداد کا اشتراک کرتا ہے، تو یہ ایک انتباہ ہے۔
حصہ 6: فیصلہ اور ایگزٹ کوڈز
# ---------------------------------------------------------------- step 6
def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--manifest", default="mini-manifest.yaml")
    parser.add_argument("--target", required=True)
    parser.add_argument("--covariates", nargs="+", required=True)
    args = parser.parse_args()

    products, edges = load(args.manifest)
    missing = undefined_names(products, edges)
    if missing:
        fail(f"manifest error: undefined names: {', '.join(missing)}")
    cycle = find_cycle(edges)
    if cycle:
        fail(f"manifest error: cycle: {' -> '.join(cycle)}")

    findings = audit(products, edges, args.target, args.covariates)
    severities = {severity for severity, _, _ in findings}
    if "ERROR" in severities:
        verdict = "FAIL"
    elif "WARN" in severities:
        verdict = "REVIEW"
    elif ancestors(edges, args.target):
        verdict = "PASS"
    else:
        verdict = "UNTRACED"

    basis = products.get(args.target, {}).get("measurementBasis", "unknown")
    print(f"target      {args.target}  [{basis}]")
    print(f"covariates  {', '.join(args.covariates)}")
    print(f"verdict     {verdict}n")
    for severity, message, details in findings:
        print(f"  {severity:<5} {message}")
        for line in details:
            print(f"        {line}")

    sys.exit(1 if verdict == "FAIL" else 0)


if __name__ == "__main__":
    main()
main یہ کمانڈ لائن جھنڈوں کو پڑھتا ہے، مینی فیسٹ کو لوڈ کرتا ہے، دونوں خود چیک کرتا ہے، اور پھر آڈٹ چلاتا ہے۔ نتیجہ چار فیصلوں میں سے ایک ہے:
| فیصلہ | جب ایسا ہوتا ہے | باہر نکلنے کا کوڈ |
|---|---|---|
FAIL |
کم از کم ایک غلطی | 1 |
REVIEW |
صرف انتباہ | 0 |
PASS |
کوئی تلاش نہیں ہے اور مضمون نے آباؤ اجداد کو ریکارڈ کیا ہے۔ | 0 |
UNTRACED |
کوئی تلاش نہیں ہے اور موضوع کے کوئی ریکارڈ شدہ آباؤ اجداد نہیں ہیں۔ | 0 |
ایک کرپٹ مینی فیسٹ یا غلط کمانڈ کوڈ 2 کے ساتھ باہر نکل جائے گی۔
PASS اور UNTRACED یہ قریب سے دیکھنے کے قابل ہے۔ PASS اس کا مطلب یہ ہے کہ ٹول نے آپ کے اصل خاندانی درخت کو تلاش کر لیا ہے تاکہ دیگر تمام کوواریٹس کو تلاش کیا جا سکے۔ UNTRACED چونکہ مینی فیسٹ میں ہدف کے لیے ایک خالی خاندانی درخت ہے، اس کا مطلب ہے کہ واک میں انجام دینے کے لیے کوئی قدم نہیں ہے۔ اسے پاتھ کہنے سے ٹول مزید نمایاں ہوجاتا ہے اور اسے ایک منفرد نام دیتا ہے۔
ایگزٹ کوڈ اتنا ہی اہم ہے۔ 1 کے ایگزٹ کوڈ کا مطلب ہے کہ ٹیسٹ چلایا گیا تھا اور ایک لیک پایا گیا تھا، جب کہ 2 کے ایگزٹ کوڈ کا مطلب ہے کہ ٹیسٹ خود ہی خراب ہو گیا تھا۔ آپ کی CI پائپ لائن کو دونوں کے درمیان فرق کرنا چاہیے۔ اس کی وجہ یہ ہے کہ ایک لیک آپ کو covariates کو تبدیل کرنے کا اشارہ کرے گا، اور ایک کرپٹ مینی فیسٹ آپ کو فائل کو ٹھیک کرنے کا اشارہ کرے گا۔
مرحلہ 6: ایک حقیقی کیس پر لنٹر چلائیں۔
کیس 1: FEMA کا رسک اسکور
FEMA کا کمپوزٹ رسک سکور کمیونٹی کے خطرے کے عوامل سے تخمینہ شدہ سالانہ نقصان کو کئی گنا کر دیتا ہے۔ ان عوامل میں سماجی کمزوری کے اسکور اور کمیونٹی لچک کے اسکور پر مشتمل ہوتا ہے، یہ دونوں مختلف تنظیموں کے ذریعے ACS سروے کالم تک پہنچتے ہیں۔

FEMA_NRI.risk_score اور ہر چیز اس سے بنی ہے۔ نیلے اور سرخ رنگ میں بنائے گئے دونوں راستے، اسی ACS بے روزگاری کی شرح کے کالم سے شروع ہوتے ہیں۔ ایک مردم شماری بیورو کے لچکدار تخمینوں کے ذریعے اوپر جاتا ہے اور دوسرا HVRI کے BRIC انڈیکس کے ذریعے اوپر جاتا ہے۔
فرض کریں کہ آپ خطرے کے اسکور کی پیشن گوئی کرنے کے لیے غربت اور بے روزگاری کی شرح کو استعمال کرنا چاہتے ہیں۔
python3 mini_lint.py --target FEMA_NRI.risk_score --covariates ACS.EP_POV150 ACS.EP_UNEMP

فیصلہ FAIL ہے۔ غربت کی شرح ایک راستے سے ہدف تک پہنچتی ہے، اور بیروزگاری کی شرح دو راستوں سے ہدف تک پہنچتی ہے: شماریاتی اور تعینیاتی۔
نتیجہ ایگزٹ کوڈ 1 کے ساتھ FAIL ہے۔
ACS.EP_POV150 آپ ایک راستے سے اپنے مقصد تک پہنچ جاتے ہیں۔ ACS.EP_UNEMP 2 بجے تک پہنچنا۔
بے روزگاری کا پہلا راستہ مردم شماری کے ماڈل سے گزرتا ہے، لہذا ٹول اسے شماریاتی طور پر دکھاتا ہے۔ دوسرا راستہ HVRI کے BRIC انڈیکس سے گزرتا ہے، جہاں بے روزگاری ایک براہِ راست عنصر ہے، اس لیے ٹول اسے تعین پر مبنی لیبل کرتا ہے۔
اگر آپ اسپریڈشیٹ میں کالم کے ناموں کے ساتھ دو راستوں کو بصری طور پر ٹریس کرتے ہیں، تو آپ کو جلد ہی نظر آئے گا کہ گراف کیوں مددگار ہیں۔ ٹراورسل سیکنڈوں میں دونوں کو ڈھونڈتا ہے۔
کیس 2: اولاد
اب آئیے گیئرز کو تبدیل کریں اور فرض کریں کہ ہم مردم شماری کے اسکورز کی پیشین گوئی کر رہے ہیں FEMA کی مردم شماری کی دوبارہ شائع شدہ کاپی بطور covariate۔
python3 mini_lint.py --target CENSUS_CRE.social_vulnerability --covariates FEMA_NRI.social_vulnerability
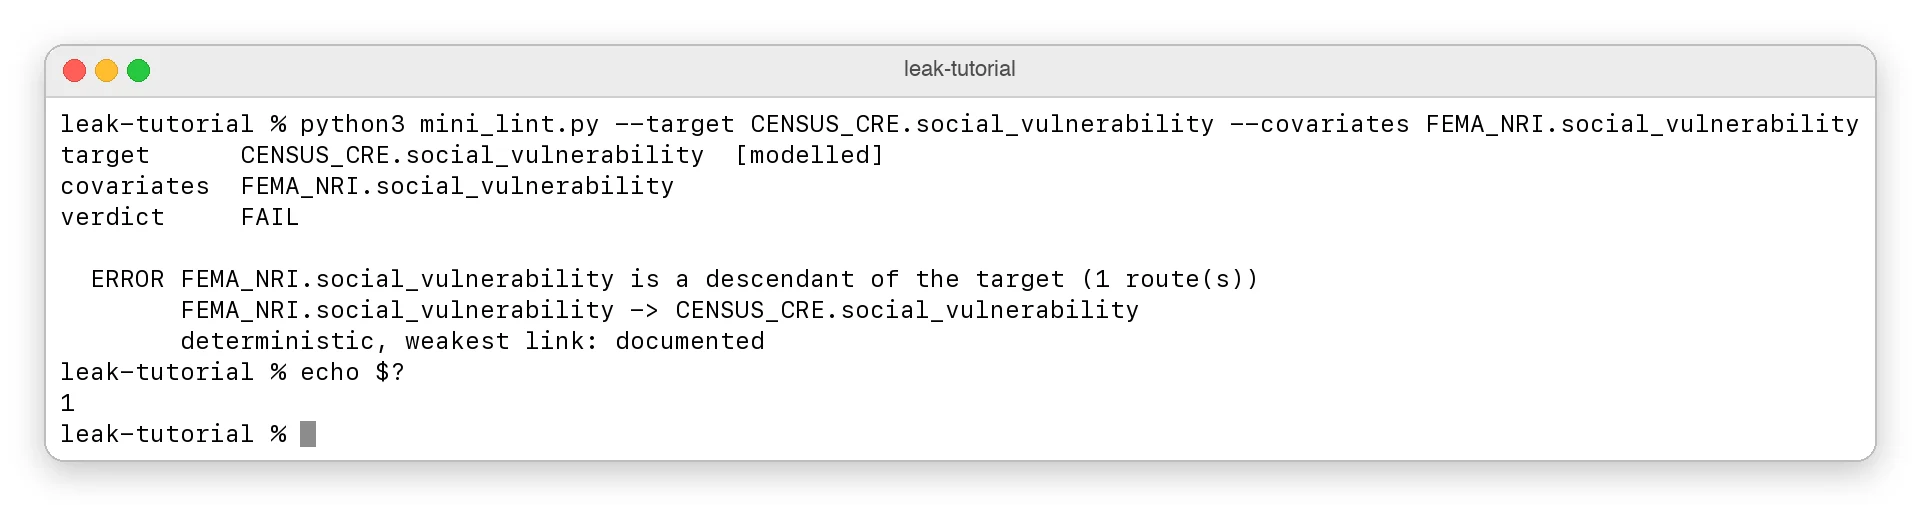
کیس الٹ گیا اور پھر ناکام ہوگیا۔ FEMA کی طرف سے دوبارہ جاری کی گئی مردم شماری کے اسکور کی کاپیاں ایک تعییناتی راستے کے ذریعے مضامین سے حاصل کی گئی ہیں۔
FEMA کے اسکورز براہ راست مردم شماری کے اسکور سے بنائے جاتے ہیں، اس لیے ان کو بطور ان پٹ استعمال کرنے سے ماڈل کے جوابات مل جاتے ہیں۔ ٹول ان کو بچوں کی طرح پکڑتا ہے۔
کیس 3: جائزہ لیا گیا، پاس کیا گیا، ٹریک نہیں کیا گیا۔
یہاں تین رنز ہیں جو صاف یا تقریبا صاف ہونے چاہئیں۔
python3 mini_lint.py --target NVSS.mortality --covariates FEMA_NRI.social_vulnerability HVRI.bric
python3 mini_lint.py --target FEMA_NRI.risk_score --covariates SAT.chirps_rainfall
python3 mini_lint.py --target NVSS.mortality --covariates SAT.chirps_rainfall

تین صاف ستھرا رنز: دو ACS والدین کا اشتراک کرنے والے جوڑوں کے لیے جائزہ، سیٹلائٹ بارش بمقابلہ رسک سکور کے لیے PASS، اور بغیر درج والدین کے اہداف کے لیے UNTRACED۔
پہلی رن REVIEW لوٹاتی ہے کیونکہ دونوں کوواریٹس دو ACS والدین اور ماڈل اوورلیپ میں ان کے پاسز کا اشتراک کرتے ہیں۔
دوسرا رن PASS کو لوٹاتا ہے کیونکہ رسک اسکور میں ایک ٹریک شدہ پیڈیگری ہے اور سیٹلائٹ کی بارش اس سے باہر ہے۔
تیسرا رن UNTRACED لوٹتا ہے۔ اس کی وجہ یہ ہے کہ موت کے سرٹیفکیٹ کے ریکارڈ براہ راست شمار ہوتے ہیں جن میں والدین درج نہیں ہوتے ہیں۔
یہ خاموش نتائج ناکامیوں کی طرح اہم ہیں۔ ایک چیکر جو ہر ان پٹ پر خطرے کی گھنٹی بجاتا ہے بیکار ہے، لہذا ایک اچھے ٹیسٹ سیٹ میں ہمیشہ ایسے کیسز شامل ہوں گے جنہیں پاس ہونا ضروری ہے۔
مرحلہ 7: غلط ان پٹ کی وجہ سے لنٹر کو بری طرح ناکام ہونے کے لیے سیٹ اپ کریں۔
حفاظتی ٹولز واضح طور پر ناکام ہو کر اعتبار حاصل کرتے ہیں۔ لیک چیکر کا سب سے برا نتیجہ ایک معائنہ کے لیے ایک سبز پاس ہے جس نے خاموشی سے اپنا کام چھوڑ دیا، اور ایسا ہونے کے تین عام طریقے ہیں:
نقصان 1: نام میں ٹائپنگ
اگر آپ اسے آزمانا چاہتے ہیں تو اسے کاپی کریں۔ mini-manifest.yaml کو typo-manifest.yaml اور تبدیلی HVRI.bric کو HVRI.brick میں FEMA_NRI.community_resilience اندراج پھر درج ذیل دو کمانڈز چلائیں:
python3 mini_lint.py --target FEMA_NRI.risk_score --covariates ACS.EP_POV15
python3 mini_lint.py --manifest typo-manifest.yaml --target FEMA_NRI.risk_score --covariates ACS.EP_UNEMP

2 ٹائپ کی غلطیاں، 2 ایگزٹ کوڈز۔ ایک غلط ہجے والے کوویریٹ کے نتیجے میں ایگزٹ کوڈ 1 کے ساتھ FAIL ہو جائے گا، اور مینی فیسٹ میں غلط ہجے والے والدین کے نتیجے میں ایگزٹ کوڈ 2 کے ساتھ ایک واضح غلطی ہو گی۔
غلط ہجے والی کوواریٹس (ACS.EP_POV15) ایگزٹ کوڈ 1 کے ساتھ ناکام ہو جائے گا۔ مینی فیسٹ کے اندر غلط ہجے والے والدین (HVRI.brick) کے نتیجے میں ایگزٹ کوڈ 2 کے ساتھ ایک واضح غلطی ہوتی ہے۔ دونوں ٹراورسل ہونے سے پہلے ہی عملدرآمد روک دیتے ہیں۔
نقصان 2: YAML چابیاں ڈپلیکیٹ کریں۔
مینی فیسٹ کی ایک اور کاپی اس طرح بنائیں: sneaky-manifest.yaml، اور پھر فائل کے آخر میں ایک لائن شامل کریں۔ FEMA_NRI.risk_score بلاک:
derivesFrom: []
اب خطرے کے دو اسکور ہیں: derivesFrom کلید بنانا peek.py یہ دیکھنے کے لیے کہ PyYAML کیا کرتا ہے:
import yaml

with open("sneaky-manifest.yaml") as fh:
    doc = yaml.safe_load(fh)

print(doc["products"]["FEMA_NRI.risk_score"]["derivesFrom"])
اب دوڑو peek.pyاسی فائل پر لنٹر چلائیں۔
python3 peek.py
python3 mini_lint.py --manifest sneaky-manifest.yaml --target FEMA_NRI.risk_score --covariates ACS.EP_UNEMP

ڈپلیکیٹ چابیاں دو طریقوں سے دیکھی گئیں۔ صاف yaml.safe_load جب کہ یہ ایک خالی فہرست پرنٹ کرتا ہے اور کچھ نہیں کہتا، ایک سخت لوڈر بار بار کیز کو دو لائن نمبر تفویض کرتا ہے اور کوڈ 2 کے ساتھ باہر نکلتا ہے۔
صاف yaml.safe_load PyYAML ایک خالی فہرست واپس کرتا ہے کیونکہ ہم نے دوسری کلید رکھی اور تینوں اصلی کناروں کو ضائع کر دیا اور اس کے بارے میں خاموش رہے۔ اس لوڈر میں بنایا گیا ایک لنٹر اس بات کو یقینی بنائے گا کہ تمام لیکس بغیر کسی راستے کو ڈھونڈے ہموار ہیں۔
سخت لوڈر ایگزٹ کوڈ 2 کے ساتھ رک جاتا ہے اور دونوں لائن نمبروں کی طرف اشارہ کرتا ہے۔
پِٹفال 3: کوویریٹ کی خالی فہرست
تیسری خرابی کو نظر انداز کرنا آسان ہے۔ CI میں، آپ فائل یا شیل متغیر سے covariates کی فہرست بنا سکتے ہیں۔ اگر وہ فائل خالی ہے یا متغیر کے نام میں کوئی ٹائپنگ ہے، تو کمانڈ 0 covariates کے ساتھ ختم ہو جائے گی۔
میرے مجموعی ٹول کا ایک پرانا ورژن اس کو قبول کرے گا اور ایک PASS پرنٹ کرے گا، چیک کے لیے صحت کا صاف بل، اس سارے کام کو چھوڑ کر۔
python3 mini_lint.py --target FEMA_NRI.risk_score --covariates

خالی --covariates فہرست اب ایگزٹ کوڈ 2 کے ساتھ ٹراورسنگ سے پہلے آرگ پارس پر عملدرآمد روک دیتی ہے۔
میں mini_lint.py، nargs="+" ارگ پارس کو یہ بتائیں: --covariates کم از کم ایک قدر کی ضرورت ہے۔ required=True جھنڈا خود کو لازمی قرار دیں۔ اب ایک خالی فہرست ایگزٹ کوڈ 2 کے ساتھ پائپ لائن کو سرخ کر دیتی ہے۔
مرحلہ 8: CI پر خود بخود چیک چلائیں۔
مسلسل انضمام (CI) جب بھی آپ کوڈ کو آگے بڑھاتا ہے چیک کرتا ہے۔ یہ GitHub ایکشنز ورک فلو ہر پش اور ہر پل کی درخواست کے لیے ایک لنٹر چلاتا ہے۔ بطور محفوظ کریں۔ .github/workflows/lineage.yml اپنے ذخیرے میں mini_lint.py اور mini-manifest.yaml اس کی جڑوں سے:
name: lineage-check

on: [push, pull_request]

jobs:
  lint-lineage:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v5
      - uses: actions/setup-python@v6
        with:
          python-version: "3.12"
      - run: pip install pyyaml
      - name: Check covariates against the target's lineage
        run: |
          python3 mini_lint.py
            --target FEMA_NRI.risk_score
            --covariates $(cat features.txt)
covariate نام features.txt ریپوزٹری روٹ میں فی لائن ایک نام:
SAT.chirps_rainfall
کہ $(cat features.txt) حصہ یہ ہے کہ اس نام کو کمانڈ میں پیسٹ کریں اور اس فائل کو استعمال کریں، آپریشن گزر جائے گا اور یہ سبز ہو جائے گی۔ بعد میں، اگر کوئی اس طرح لیکی کوواریٹ شامل کرتا ہے: ACS.EP_UNEMPکام کوڈ 1 کے ساتھ ختم ہوتا ہے اور سرخ ہو جاتا ہے۔ اگر کوئی خالی کرتا ہے۔ features.txt اتفاق سے آرگ پارس کوڈ 2 کے ساتھ باہر نکلتا ہے اور ٹاسک بھی سرخ ہو جاتا ہے۔
| باہر نکلنے کا کوڈ | معنی | CI کے نتائج |
|---|---|---|
| 0 | چیک بھاگ گیا اور PASS، REVIEW، یا UNTRACED واپس آیا۔ | سبز |
| 1 | ایک چیک چلایا گیا اور لیک کا پتہ چلا۔ | سرخ |
| 2 | مینی فیسٹ خراب ہے یا کمانڈ خراب ہے۔ | سرخ |
REVIEW اور UNTRACED بھی کوڈ 0 کے ساتھ باہر نکلیں۔ اگر آپ چاہتے ہیں کہ پائپ لائن یہاں بھی رک جائے تو آخری لائن کو تبدیل کریں: main PASS کے علاوہ تمام فیصلے 1 کے کوڈ کے ساتھ ختم ہوں گے۔
ساتھی ریپوزٹری اسی ورک فلو کو چلاتی ہے، اور آپ ریپوزٹری کے آپریشنز ٹیب میں نتائج دیکھ سکتے ہیں۔
مرحلہ 9: میری غلطیوں سے سیکھیں۔
ایک مکمل مینی فیسٹ لکھنے سے مجھے یہ سکھایا گیا کہ ایک لنٹر صرف اتنا ہی اچھا ہے جتنا یہ گراف پڑھتا ہے۔ مجھے مخالف سمت میں دو بار SVI غلط ملا۔ دونوں غلطیاں فائل کے کالموں پر بھروسہ کرنے کی ایک ہی عادت سے پیدا ہوئیں نہ کہ ان کے پیچھے طریقہ کار۔
غلطی 1: SVI California فائل میں 24 کالم ہیں جن کے نام سے شروع ہوتے ہیں: EP_تاہم، سی ڈی سی نے ان میں سے صرف 16 کو انڈیکس میں شامل کیا۔ میرے پہلے مینی فیسٹ نے تمام 24 کو شمار اور ریکارڈ کیا۔ EP_NOINT ہم (براڈ بینڈ سبسکرپشنز) کو انڈیکس کے جزو کے طور پر استعمال کرتے ہیں۔ کنارے کو ہٹا دیا گیا ہے کیونکہ وہ کالم فائل میں ہے اور CDC اسے درجہ بندی سے خارج کر دیتا ہے۔
غلطی 2: اس کے بعد ہم نے تمام آٹھ غیر درجہ بندی والے کالموں کو حد سے زیادہ درست کیا اور انہیں انڈیکس کے آگے فراہم کردہ محفوظ راہگیروں کے طور پر درج کیا۔ ان آٹھ میں سے سات نسل اور نسلی کالم ہیں۔ جب میں نے خام گنتی کی جانچ کی تو وہ 7 ہو گئے۔ E_MINRTY تمام 9,109 ٹریکٹس میں سب سے بڑا فرق 0 تھا۔
EP_MINRTY یہ تھیم 3 کے لیے ایک ہی ان پٹ ہے، اور تھیم 3 آپ کو مکمل انڈیکس فراہم کرتا ہے۔

سات ستون کیوں نہیں ہیں؟ ان کا مجموعہ بالکل یہ ہے: EP_MINRTYتھیم 3 تک ایک ہاپ، اور ایک ہاپ مکمل انڈیکس تک کھلائیں۔ EP_NOINTیہ ڈاٹڈ باکس میں اسی فائل میں آتا ہے اور اسے انڈیکس سے باہر رکھا جاتا ہے۔
تو وہ 7 کالم انڈیکس کے آباؤ اجداد ہیں اور 2 ہاپس اپ ہیں۔ میرے اپنے لنٹر نے اسے ایس وی آئی ٹارگٹ کے لیے ایک محفوظ کوویریٹ کے طور پر ہٹا دیا، جو بالکل اسی قسم کی جھوٹی ہٹانے کو روکنے کے لیے موجود ہے۔

ہر پروڈکٹ کے لیے کراس توثیق شدہ R² کا تخمینہ اس کے آگے درج کالم میں لگایا گیا ہے۔ ہمارے اپنے ان پٹ سے پیش گوئی کی گئی تمام مصنوعات نے 0.987 سے اوپر اسکور کیا۔ EP_NOINTصرف انڈیکس کے آگے پہنچایا گیا، یہ 0.384 تک پہنچ جاتا ہے۔
چارٹ واضح طور پر فرق دکھاتا ہے۔ جبکہ سات نسل اور نسلی کالم R² = 0.992 کے ساتھ تھیم 3 کو ری فریم کرتے ہیں۔ EP_NOINT بذات خود، یہ پورے انڈیکس کے مقابلے میں صرف 0.384 ہے۔
اب میں کسی بھی کالم کو محفوظ کے بطور نشان زد کرنے سے پہلے سخت قوانین کی پیروی کرتا ہوں۔ پہلے طریقہ کار کو پڑھیں اور پھر ڈیٹا میں رشتوں کی جانچ کریں۔
مکمل مینی فیسٹ درج ذیل فیلڈز میں نتائج کو ریکارڈ کرتا ہے: coPublishedNonInputsیہ ان کالموں کی فہرست بناتا ہے جو انڈیکس جیسی فائل میں آتے ہیں اور حساب میں بالکل حصہ نہیں لیتے ہیں۔ SVI کے لیے، EP_NOINT اب یہ واحد شے ہے۔
اس ٹیوٹوریل میں منی لنٹر بنیادی خیالات کا احاطہ کرتا ہے۔ مکمل پراجیکٹ شامل کرتا ہے:
-
US اور عالمی ڈیٹا میں 60 مصنوعات اور 75 اخذ کردہ کناروں کے ساتھ ظاہر کریں، بشمول CDC PLACES، FEMA کا نیشنل رسک انڈیکس، WorldPop، AlphaEarth سیٹلائٹ ایمبیڈز، اور WFP کا HungerMap LIVE
-
تمام کناروں والی مصنوعات کے لیے ایک تحریری ثبوت نوٹ اور
correctionوہ علاقے جہاں سابقہ دعوے غلط ثابت ہوئے ہیں۔ -
کوئی راستہ نہیں
--graphپورے اخذ کردہ گراف کو پرنٹ کرنے کا موڈ -
حقیقی دنیا کے آڈٹ کی 8 مثالیں بلٹ ان ہیں۔
-
کوئی راستہ نہیں
reproduce_svi.pyایک اسکرپٹ جو اس دستاویز میں تمام R² نمبرز کو لائیو CDC فائل کے خلاف چیک کرتا ہے۔ -
چونکہ یہ ایک فکسڈ ڈاکر فائل ہے، اس لیے نمبرز کو درست طریقے سے دوبارہ پیش کیا جاتا ہے۔
اسے آزمانے کے لیے، ان اقدامات پر عمل کریں:
git clone https://github.com/Adeniyikayodee/dependency_manifest.git
cd dependency_manifest
python3 lint_lineage.py
python3 lint_lineage.py --graph
python3 reproduce_svi.py

پورے مینی فیسٹ کے لیے مکمل ٹول: 60 پروڈکٹس، 75 اخذ کردہ کنارے، 8 آڈٹ واپس آتے ہیں 5 فیل، 1 جائزہ، 1 پاس، 1 بے پتہ۔
منشور کی واضح حدود ہیں۔ یہ دنیا بھر میں تقریباً 400+ آفیشل کمپوزٹ انڈیکسز میں سے 60 کا احاطہ کرتا ہے، جس میں چار کناروں پر ابھی بھی نشان لگا ہوا ہے۔ inferred. فائل کے پہلے آڈٹ میں چھ غلطیاں پائی گئیں، جن میں سے چار کناروں پر تھیں جن پر میں نے پہلے ہی لیبل لگا دیا تھا۔ certain یا documented.
اس قسم کے ریکارڈ بنانے کے لیے سب سے بہتر لوگ خود ادارے ہیں۔ اس کی وجہ یہ ہے کہ ایجنسی پہلے ہی پی ڈی ایف فارمیٹ میں طریقہ کی وضاحت کرتی ہے۔ پبلک ڈیٹا اسکیما میں دو نئے فیلڈز derivesFrom اور measurementBasisیہ ہر پروڈیوسر کو اس چیز کو ذخیرہ کرنے کی جگہ دے گا جو وہ پہلے سے جانتے ہیں۔
اگر آپ عوامی ڈیٹا کے ساتھ کام کرتے ہیں، تو آپ ان پروڈکٹس کو شامل کرکے یا دکھائے گئے کونوں کو چیک کرکے مدد کرسکتے ہیں۔ inferred اصل دستاویز کے بارے میں۔
نتیجہ
عوامی ڈیٹا کے ٹارگٹڈ لیک ان ترکیبوں کے اندر چھپے ہوئے ہیں جنہیں ادارے اپنے اشاریہ سازی کے لیے استعمال کرتے ہیں۔ ایک ماڈل ان میں سے کسی ایک ترکیب کو دوبارہ دریافت کر کے قریب قریب کامل سکور حاصل کر سکتا ہے، اور یہ سکور ہمیں حقیقی دنیا کے بارے میں بہت کم بتاتا ہے۔
اس ٹیوٹوریل میں آپ کریں گے:
-
ہم نے R² = 0.998 کے ساتھ اپنے 5 ان پٹ کالموں سے CDC کے تھیم 1 کی تشکیل نو کی۔
-
ماخذ (جہاں نمبر آیا ہے) اس کے اخذ سے الگ ہے (اس کا حساب کیا جاتا ہے)
-
میں نے ایک YAML مینی فیسٹ لکھا ہے جو ان کے تعلقات اور اعتماد کی سطح کے ساتھ اخذ کردہ کناروں کو ریکارڈ کرتا ہے۔
-
میں نے ایک لنٹر بنایا ہے جو پہلے کی تلاش کا استعمال کرتے ہوئے آباؤ اجداد کو تلاش کرتا ہے اور گہرائی سے پہلی تلاش کا استعمال کرتے ہوئے تمام راستوں کی فہرست دیتا ہے۔
-
ٹائپوز، ڈپلیکیٹ YAML کیز، سائیکل، اور خالی کوویریٹ فہرستوں کی وجہ سے لنٹر بری طرح ناکام ہو گیا۔
-
میں نے واضح ایگزٹ کوڈ کا استعمال کرتے ہوئے چیک کو GitHub ایکشنز سے منسلک کیا۔
عوامی اعداد و شمار سے اعلی اسکور پر بھروسہ کرنے سے پہلے، اپنے آپ سے پوچھیں کہ آپ کے مقاصد کیا ہیں۔ اگر آپ جواب لکھتے ہیں، تو ہر بار جب آپ اپنے ماڈل کو تربیت دیتے ہیں تو آپ اسے ازگر کی چند سطروں سے چیک کر سکتے ہیں۔
اس ٹیوٹوریل کا کوڈ ٹیوٹوریل سے ٹیوٹوریل میں ہے، اور آپ مکمل ٹولز، مینی فیسٹ، اور ری پلے اسکرپٹ کو مین انحصار_مینیفسٹ ریپوزٹری میں تلاش کر سکتے ہیں۔ اس پروجیکٹ کو DOI 10.5281/zenodo.22274757 کے تحت Zenodo میں محفوظ کیا گیا ہے اور یہ CC0 لائسنس کے تحت آزادانہ طور پر دستیاب ہے۔